登录社区云,与社区用户共同成长
邀请您加入社区
为什么 dsh 不直接 import fs?为什么 Shell 执行可以一键切到远程沙箱?这篇文章讲 dsh 的能力 Seam 设计:Service Definition / Provider / Consumer 三角色,以及 ctx.fs、ctx.sandbox、ctx.shell、ctx.llm 这些核心 Seam 的实际用法
今天分享 3 款高频在用的工具,从 “开门找对路” 到 “验真辨好坏” 再到 “合成出初稿”,全是亲测能省时间的硬货,第一款直接封神!整个周期从以前的 “一个月头大” 压缩到 “一周能交差”,多出来的时间我用来调实验、写代码,甚至偶尔摸鱼放松 ——AI 不是偷懒神器,而是把科研从 “苦力模式” 切换到 “思考模式” 的加速器。前两款负责 “找” 和 “验”,Paperguide 就专攻 “合成 +
评测Agent需明确数据集、grader、harness,先设计可稳定判分的任务;合成数据适合补洞,不能代替真实分布。最终答案通过不代表工具正确,须分层检查工具选择、参数、执行和结果。长任务分数取决于模型与全套运行配置,grader本身也需校准。评测应定位数据、结果、轨迹、运行、评分各层失败,而非只报告总分。
AI编程已从代码补全经对话式编程跃迁至自主多智能体协同,形成Copilot、ClaudeCode、Cursor三足鼎立格局,中国Qoder亦入局。未来AI将成“数字同事”,但需求理解、架构设计等核心工程仍由人类掌控,程序员将转型为“指挥AI写代码的人”。
2024年,当Claude 3在CTF比赛中独立完成二进制exploit链构造;当GPT-4o能在数秒内审计出一段存在SQL注入的代码并给出修复方案;当GitHub Copilot Security让一名普通开发者的安全编码能力追平资深安全工程师——整个网络安全行业都感受到了一种前所未有的震动。这不是一次普通的技术迭代,而是一次生产关系的重构。过去三十年,网络安全行业的核心生产力是人:人的经验、人
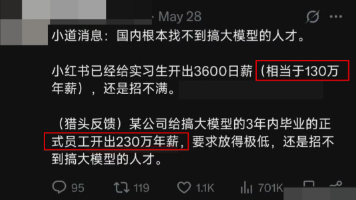
<think>我们只需要根据内容生成≤150字的文章摘要。内容主要讲AI大模型人才稀缺、薪资高,原因包括政策、需求、供需失衡,企业高薪抢人,最后推广学习资料。摘要需简洁概括。</think>AI大模型人才极度稀缺,薪资高企,实习生日薪3600元、应届生年薪230万仍难招人。政策驱动、行业渗透和供需失衡是主因。DeepSeek、京东等头部企业年薪破百万抢人。AI岗位需求旺盛,掌握大模型技能成高薪关键
本文围绕deepseek辅助科研主题,指出传统关键词检索精读的科研路径易形成认知天花板,推荐了一套高效科研新路径:以复旦切问学术为起点,通过灵感发现功能获取研究方向、生成可执行研究计划,依托其论文复现功能一键完成算力适配、环境搭建、实验跑通全流程;再用SciSpace批量解构核心论文挖掘共性创新空白,辅以Research Rabbit等工具构建动态学术知识图谱,帮助科研人员建立先见森林后见树木的系
只会调 API 不够,还要会"编排"! 本文用 DeepSeek 实测 LangChain:从消息类型、Runnable 接口到 LCEL 管道链,再到 bind_tools 工具调用,每步都有可直接运行的完整代码,零基础也能照着写。
获取有效的 DeepSeek API-Key掌握 HTTP 协议基础与 JSON 数据格式规范定义:单次请求中messages数组包含的全部信息,即模型本次调用可见的所有内容上下文窗口:DeepSeek V3.1 系列模型支持最大 128K 上下文长度,约合 300~500 页文档内容截断规则:上下文超出最大长度时,会自动截断较早的历史内容。
从一句话需求,到一套能跑、可验证、可复盘的 Cordis 插件系统 —— 用"搭建一个真实系统"的方式,彻底理解 dsh 框架「一切皆插件」的架构思想。
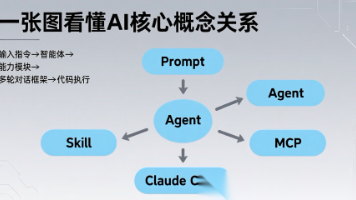
本文通过公司实习生的比喻,系统解析了AI领域的五大核心概念:Prompt(指令输入)、Agent(自主执行)、Skill(标准化流程)、MCP(工具连接协议)和Claude Code(集成产品)。这些概念构成从"与AI对话"到"让AI自主工作"的完整体系,各自扮演不同角色:Prompt明确目标,Agent规划执行,Skill提供方法,MCP连接外部,Claude Code是现成解决方案。理解它们的
Day51|从0学习Claude Code(一):一个while循环加一个Bash,复刻Claude Code的心脏
这一轮新面孔里,四个都带着"脑"字:claude-obsidian 要当你的第二大脑,openhuman 自称个人 AI 超级智能,ai-engineering-from-scratch 教你把 AI 从零手写出来,awesome-llm-apps 则是 100 多个 AI 应用模板的仓库。昨日报纸已经介绍过它的用法,今天的变化在于热度:单日 +351 Star,对一个 1,700 多 Star
放了四组实现:basic workflows、orchestrator-workers、evaluator-optimizer,以及后来的 async multi-agent orchestration。表面看,它们无非是把llm_call串行、并行或循环调用几次。这比“工作流和 Agent 的区别”更准确。是否用了工具、是否有多个模型、是否并发,都不是分界线。
秉承在实践中学习,在写项目中提高编程语言的综合能力的原则,准备在复刻deepseek harness项目的过程中,找到light的不足,补足短板,让light语言真正能够实战!已经让hy3 模型先摸了摸底,写了两篇文档: 在目录 G:\dswork\duan-light-merge ,一篇 复刻deepseek-harness难点分析.md ,一篇 复刻harness驱动_light升级计划.md
本文介绍了如何在DeepSeek Harness(DSH)平台上实现Agent技能的自我进化机制。DSH原生技能系统采用Markdown文件+YAML格式存储技能,通过技能管理器工具(skill_write、skill_delete、skill_list)实现技能的增删查操作,并保证原子写特性。核心创新是"后台反思蒸馏"循环:定时扫描会话事件,通过严格JSON契约的LLM调用进行技能提炼,将有效技
定位:C++17 实现的大模型接入静态库,封装 HTTP 请求、会话管理、持久化底层逻辑支持模型:云端(DeepSeek、GPT-4o、Gemini)、本地(Ollama DeepSeek R1)核心能力:多轮对话、流式 / 非流式响应、会话全生命周期管理、SQLite 数据持久化依赖栈:OpenSSL、fmt、jsoncpp、spdlog、gflags、sqlite3。
Create a list called "fruits". 新建空列表。Check if "apple" is in fruits. 判断存在。|通过固定的英语句式,让其在学习英语的同时培养编程思维的可行性讨论。初学Python,对于自然语言模型的初步探索,期望各位大佬批评指正。Repeat 3 times: Print "hi". 循环执行。Print all items in fruits.
硬件走 CERN 开源硬件许可,软件走 MIT,作者是摩洛哥一个小工作室,README 里写"从一个小工作间开始,现在有 1.9 万工程师星标"。Apple Silicon 上的 LLM 推理服务器,昨天第 8 今天掉到第 10,但日增星从 78 涨到 370,翻了 4.7 倍。今天空降第二的新面孔,定位是"本地多智能体编排器"——把你在终端里跑的 Claude Code、Codex、Grok 等
浏览器使用代理(如OpenAI Atlas、Perplexity Comet、Anthropic Claude-for-Chrome等)能够像人类一样与网页互动——点击、滚动、填写表单、跨页面导航。然而,这类代理继承了底层LLM的提示注入漏洞:攻击者可以通过在网页中嵌入恶意指令,诱导代理执行未经授权的操作,如洩露私人信息或发起非预期的状态变更请求。
2026年8月17日,DeepSeek新版API价格生效,V4 Pro峰时输出涨至27元/百万Token(约3.5倍)。本文提供完整决策指南:成本测算→替代方案评估→迁移成本估算→综合决策。还包含缓存优化、模型分级等防守策略,助你理性应对涨价。
千问团队开源Qwen3.8-27B大模型,在多模态处理、推理深度、编程办公等场景实现全面升级。实测显示:该模型在Linux知识(满分)、逻辑常识(满分)、传统文化(90分)、高考数学(95分)四科测试中表现优异,推理速度稳定在50 tokens/秒,支持262K长上下文。相比前代,Qwen3.8通过混合架构和词表扩展显著提升中文理解与多任务处理能力,尤其适合运维、开发等复杂场景。大模型技术正重塑职
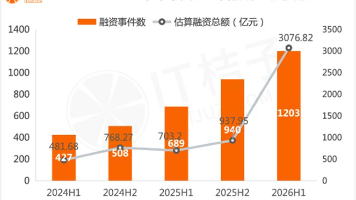
DeepSeek V4 Pro、Grok 4.6等大模型相继发布,AI行业竞争激烈。2026上半年AI赛道融资额突破3000亿元,人才缺口达600万,薪资大幅提升。无论背景如何,通过系统学习AI技术,普通人也能在AI领域找到发展机会。8月13日凌晨,DeepSeek V4 Pro正式版静默上线,没有预告没有发布会,虽然低调,但是依旧强势冲上热搜。巧合的是,马斯克旗下Grok 4.6几乎在同一时间发
Agent工程师这个岗位的价值会越来越高,原因很简单:AI能力在快速提升,但把AI能力转化为商业价值的人才严重不足。随着GPT、DeepSeek等更强大的模型发布,Agent能处理的任务会越来越复杂。但模型再强大,也需要有人来设计业务流程、优化用户体验、解决实际问题。而且,每个行业都有自己独特的业务逻辑和数据特点,这意味着Agent工程师的需求会呈现"长尾效应"——不是几个通用的Agent就能解决
Autowired@Bean@Description("根据用户ID查询最近订单列表")@Bean@Description("根据订单号查询物流状态")里的文字是给大模型看的,它会根据这段描述判断要不要调这个函数。所以描述要写清楚:这个函数是干什么的,参数是什么意思。我们早期有函数描述写得模糊,模型该调的时候没调,不该调的时候乱调,排查了好一阵子。
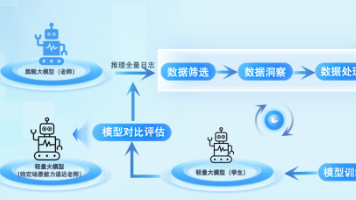
那到底什么是模型蒸馏,怎么来做模型蒸馏,今天我就用最直白的话讲明白这个事儿,其实一句话来讲就是:让便宜的小模型,学会贵的大模型的本事。具体操作上,就是先用那些顶尖的模型,比如GPT、Opus这些跑一遍任务,把它的输出结果、思考过程什么的全部都记录下来。然后用这些数据去训练一个开源小模型(比如阿里的Qwen、Meta的Llama等等吧)。训练完成后,这个小模型在特定的垂直场景下的表现,真的可以接近甚
DeepSeek Harness(DSH)网页版使用
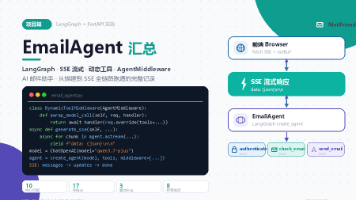
摘要:EmailAgent 是一个基于 LangGraph AgentMiddleware 的智能邮件助手系统,支持自然语言交互完成邮箱认证、收发邮件等操作。技术栈采用 DashScope 的 qwen3.7-plus 作为 LLM,LangGraph 构建 Agent 框架,FastAPI 提供 Web 服务。当前功能均为模拟实现(如硬编码邮箱认证、固定返回邮件状态),未来需接入数据库、IMAP