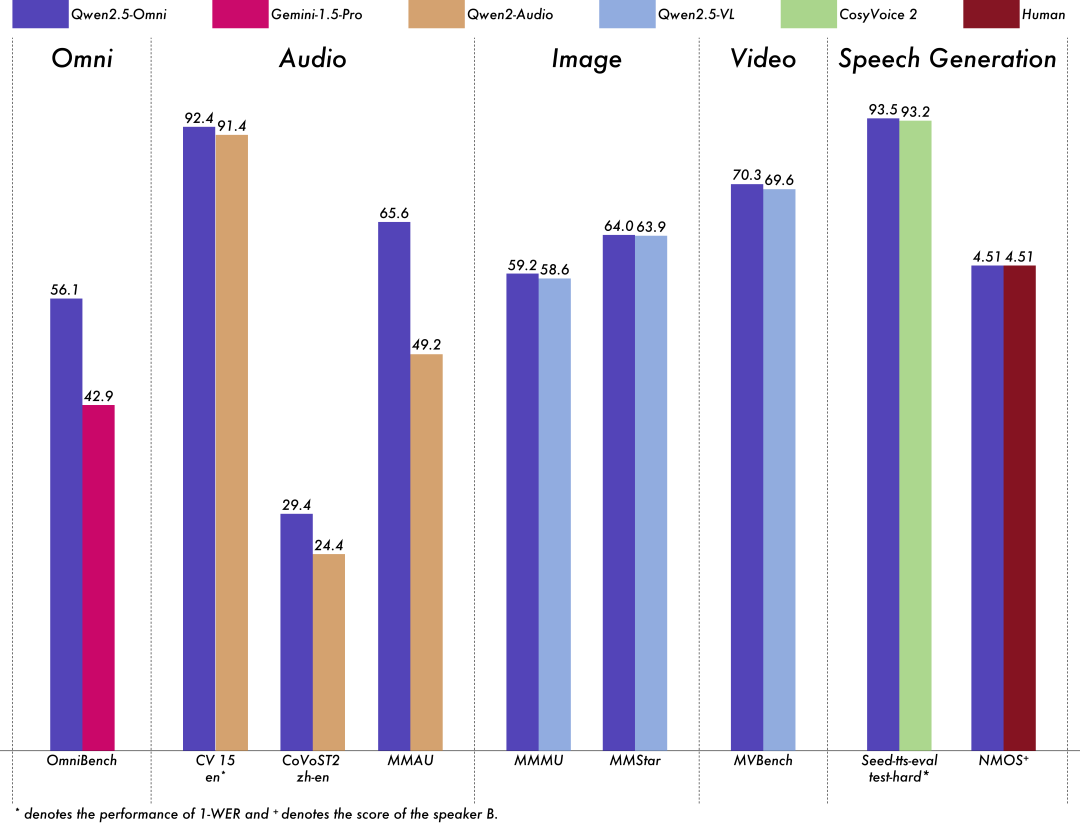
登录社区云,与社区用户共同成长
邀请您加入社区
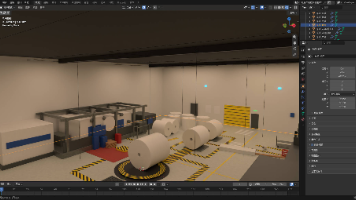
本文介绍一条 "从基于大模型构建3D模型生产到应用发布" 的快速构建链路:上游由大模型驱动 Blender 辅助实时建模,下游把模型变成可拖拽配置的元件,业务人员无需人工3D建模和开发业务代码即可产出浏览器应用。
如何让“蓝色大肥鱼”帮你免费干活?国际版 WorkBuddy 的 DeepSeek V4.1 Flash 虽然限免真香,但一换账号历史会话、MCP 工具和长期记忆全被清空。借助开源工具 WorkBuddy Tools,一键打包带走全部工作上下文与配置,让多账号高配模型轮流给你当免费打工人!
今天分享 3 款高频在用的工具,从 “开门找对路” 到 “验真辨好坏” 再到 “合成出初稿”,全是亲测能省时间的硬货,第一款直接封神!整个周期从以前的 “一个月头大” 压缩到 “一周能交差”,多出来的时间我用来调实验、写代码,甚至偶尔摸鱼放松 ——AI 不是偷懒神器,而是把科研从 “苦力模式” 切换到 “思考模式” 的加速器。前两款负责 “找” 和 “验”,Paperguide 就专攻 “合成 +
刚进实验室的研一新生最容易陷入迷茫。不知道怎么确定研究方向,看不懂海量外文文献,不会设计合理的实验方案,数据处理和绘图一窍不通,写第一篇学术论文更是无从下手。别慌,亲测这五个工具能帮你快速入门科研,少走至少三年弯路。
在工业边缘网关、智能车载语音控制以及手持巡检终端中部署小参数大语言模型(如 Llama-3.2-1B、Qwen2.5-1.5B)时,用户交互体验最敏感的指标并非后续连续吐字的平均吞吐量,而是按下回车键到屏幕上跳出第一个字的时间——。在许多嵌入式 Linux 板卡实测中,即使后续 Decode 阶段能达到尚可接受的 5 Tokens/s,但 TTFT 却长达 3 到 8 秒。在需要实时语音应答或紧急
针对研究生读文献易陷入方向模糊、难辨关键的痛点,本文介绍了deepseek科研相关的三类文献筛选工具:通过WisPaper剔除伪关键论文、快速识别仅需了解的背景类文献,聚焦真正有研究推进价值的内容;借助Connected Papers可视化定位研究网络中的核心节点论文;最后用Google Scholar在验证阶段核查论文引用动态与相关质疑,为科研人员提供清晰的文献处理逻辑,助力科研提质增效。
DeepSeek Harness 凭借 Web 化架构、插件化生态、动态工作流、Agent 团队协作、全链路执行透明五大核心特性,在 AI 编程助手赛道走出了差异化路线。相比 Cursor 等成熟工具,它在自定义程度、跨设备访问、多工具协同上具备独特优势,尤其适合需要高度定制工作流、处理大型复杂代码库、进行团队式代码评审的开发者。同时,DeepSeek Harness 的迭代速度极快,伴随着 De
本文是《Qwen3.8-Flash-Next 落地指南》的续集,围绕开发者 Eyal Toledano 将 176B 模型塞进 48GB 内存 MacBook Air 的实测展开。核心是两招:REAP 剪枝把专家池从 68GB 砍到 35GB,再把 51B 的 n-gram 词典整体卸载到 SSD,最终让 q4 量化常驻内存从 97GB 压到 39GB,质量仅掉 2.4 个点。8G/16G 独显党
阿里开源了 Qwen3.8-Flash-Next,176B 总参、每 token 只激活 6B,训练成本压到上一代的 1/9。但对 8G/16G 消费级显卡用户来说,本地部署当下结构性跑不了——MoE 稀疏激活省的是计算不是显存,权重必须常驻显存。本文梳理模型架构、硬件门槛、可等的低显存工具(airllm / KTransformers / GGUF),并给出最现实的体验路径:走 API,或把内存
今天,通义千问Qwen2.5-Omni-7B正式开源。作为通义系列模型中首个端到端全模态大模型,可同时处理文本、图像、音频和视频等多种输入,并实时生成文本与自然语音合成输出。在权威的多模态融合任务OmniBench等测评中,Qwen2.5-Omni刷新业界纪录,全维度远超Google的Gemini-1.5-Pro等同类模型。
今年人工智能的话题铺天盖地,左边GPT-5物理奥赛完胜人类,右边Gemini3.0已经内测,据说可一键制作网页。AI发展速度远超我们想象,当我们阅读海量文章时,是否也会偶尔迷惑一下,有时看到新闻说的是大模型,有的文章写的却是大语言模型,二者到底有什么区别?今天实验室的小编好好帮你解答一下。有很多人都把大模型等同于大语言模型,其实呢二者差异显著。
DeepSeek-V3.2以开源路线对抗国际巨头,通过DSA稀疏注意力机制、可扩展GRPO训练框架和大规模合成Agent数据集三大创新,实现性能追平Gemini 3.0 Pro但价格仅为1/5。文章介绍了其技术突破、实战表现及开源战略意义,承认仍有约10%差距但正在快速缩小,预示新一代模型即将到来,展现了中国AI在资源劣势下的自主创新能力和技术自信。
自Transformer架构被提出来之后,人们一直都在对Transformer架构进行更改,例如:从正余弦位置编码旋转位置编码RoFE、从多头Attention到DeepSeek的MLA、从前馈神经网络到当前的MoE架构等。而归一化(Normalization)在整体Transformer架构中并没有做太多的改进,但它对模型能否顺利训练,却有着很关键的作用。本文将带你一文了解归一化(Normali
嵌入模型是一种将高维离散数据(文本、图像等)转换为低维连续向量的技术,这种转换让机器能更好地理解和处理复杂数据。举一个例子来理解向量,你正在玩一个叫做"猜词"的游戏。你的目标是描述一个词,而你的朋友们要根据你的描述猜出这个词。你不能直接说出这个词,而是要用其他相关的词来描述它。例如,你可以用"热"、“喝”、“早餐"来描述"咖啡”。嵌入模型就是将一个词转化为其他相关词的专用模型。
谷歌的全新模型Gemini 2.5 Pro,果然深夜上线了!Gemini 2.5 Pro是一个「思考」模型,能够在回应前先进行思考推理,从而提升性能,并改善准确性。谷歌称,它是世界上最强大的模型,具备统一的推理能力,以及用户所喜爱的Gemini的所有功能(长上下文、工具等)。
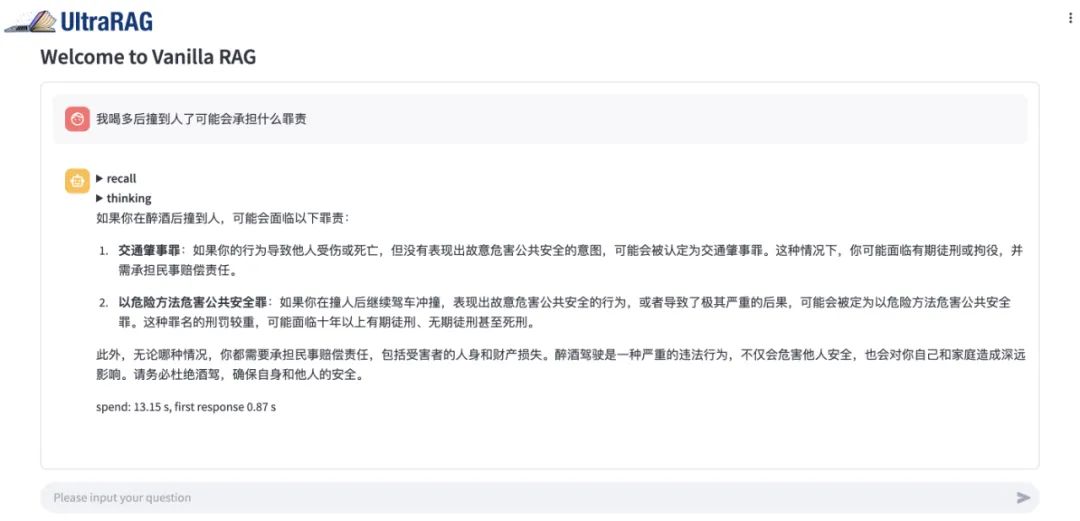
最近,深度求索开源的 DeepSeek-R1 系列模型火遍全球,但因为“服务器繁忙”劝退不少人。为了解决这个问题,我们将以 UltraRAG 框架为例,为大家介绍 DeepSeek-R1 的本地部署流程,同时带领大家熟悉 UltraRAG 的细节和功能。在成功跑通 VanillaRAG 后,我们还简单尝试了在 DeepSeek-R1 加持下的 Adaptive-Note,提出法律领域的问题,效果居
这个图可以很轻松的让没有任何基础的人看懂DLM的工作原理,它会根据问题直接生成一个回答草稿,然后一次次的修改和润色草稿,最终输出回答。而传统的大模型是一个字一个字的吐,比如我问DeepSeek,跟上面同样的问题,它的回答模式就是线性的,下一个字的输出取决于前面的内容,跟后面的内容没有关系。
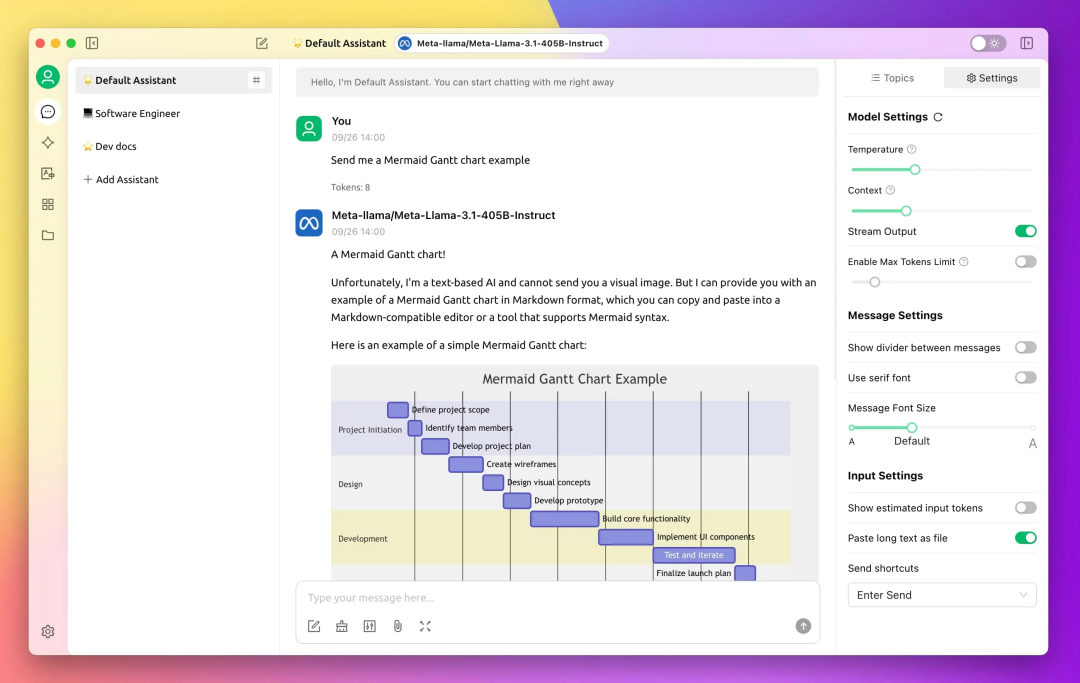
之前刷到一个不错的讯息,就是通过 CherryStudio 可以让本地的所有模型拥有联网能力。当然包括 DeepSeek 了。之前不少人问,自己本地调用的 API 或者本地安装的开源模型要如何联网。现在有方法了,而且设置挺简单。直接使用CherryStudio内置功能即可!
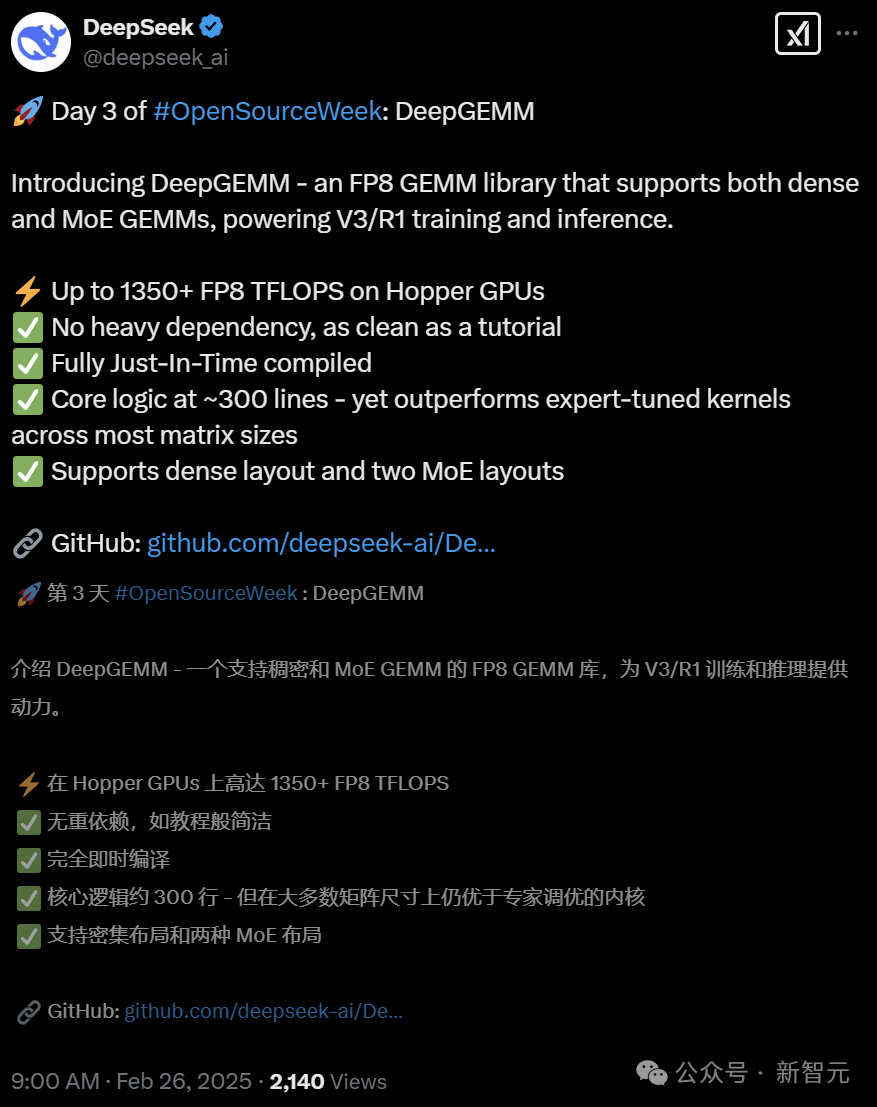
DeepSeek发布了DeepGEMM。这是一个支持稠密和MoE模型的FP8 GEMM(通用矩阵乘法)计算库,可为V3/R1的训练和推理提供强大支持。仅用300行代码,DeepGEMM开源库就能超越专家精心调优的矩阵计算内核,为AI训练和推理带来史诗级的性能提升!
谁也没料到,大周末的,小扎竟然开源了Llama 4家族。一共三款模型,首次采用MoE架构,开启了原生多模态的Llama时代!Llama 4 Scout,激活17B,16个专家,109B参数;Llama 4 Maverick,激活17B,128个专家,402B参数;Llama 4 Behemoth,激活288B,16个专家,2T参数。Llama 4发布后排名瞬间跃升,甚至超过了DeepSeek-V3
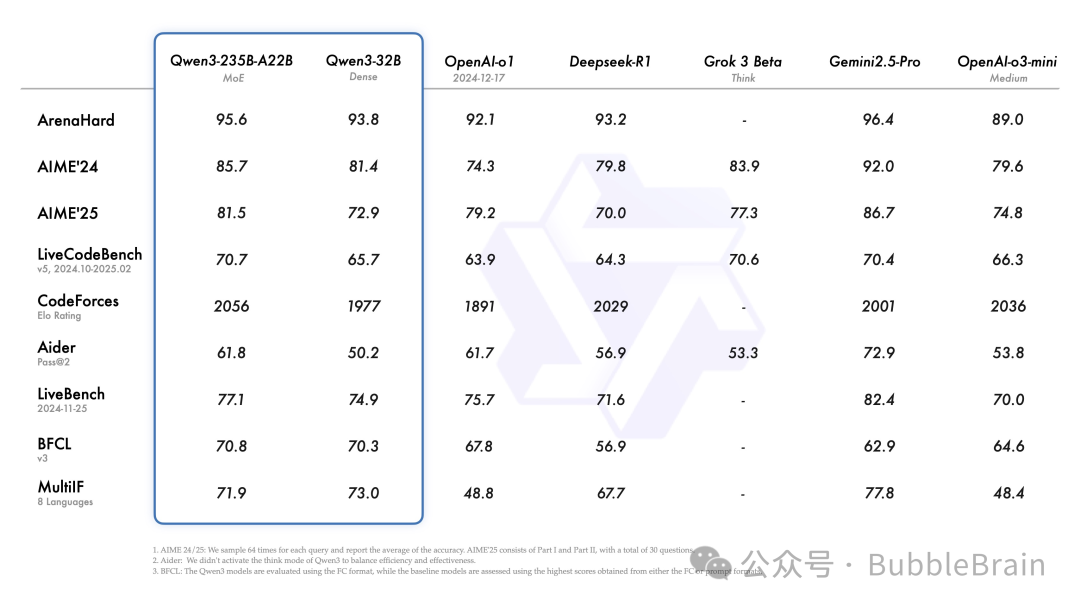
今天,通义千问Qwen团队正式开源推出 Qwen3,这是 Qwen 系列大型语言模型的最新成员。最新的Qwen3系列模型具备双模推理能力(深入思考/快速响应)、支持119种语言及方言,并强化了Agent功能与代码执行能力,全面满足复杂问题处理与全球化应用需求。其中,旗舰模型 Qwen3-235B-A22B 在代码、数学、通用能力等基准测试中,与 DeepSeek-R1、o1、o3-mini、Gro
随着大规模语言模型(LLM)在各类自然语言处理任务中不断突破,如何让模型具备更强的推理能力、生成能力与人类对齐特性,成为研究与工程实践中的重中之重。DeepSeek R1 正是在这样的背景下应运而生,它融合了预训练、监督微调(SFT)、强化学习(RL)及模型蒸馏等多种技术手段,通过分阶段、多轮次的训练迭代,最终构建了一款既具备扎实推理能力,又与人类偏好高度对齐的开源对话模型。在本文中,我们将结合如
DeepSeek-R1-Distill-Qwen-1.5B作为基础模型。这一选择不同于许多聚焦于大模型的研究,而是着眼于一个蒸馏得到的小型模型。这个模型虽然参数量小,但通过特定的系列(DeepSeek/Qwen)和蒸馏过程,具有较强的初始推理能力。
先说结论: 虽说将大模型部署在自己的电脑上,有很多好处,但万不得已,并不推荐个人搞本地部署(钱多或企业除外)。对于普通用户来讲,只是日常简单的使用AI,直接使用市面上主流的云AI工具就足够了。那在哪些情况下,需要或者适合将大模型(如DeepSeek)部署在自己的电脑上呢?
终于,千呼万唤中,Qwen 3 登场了。这次发布了2 个 MoE 模型,6 个 稠密(dense)模型,从 0.6B 到 235B,所有的尺寸都集全了。它们最顶尖的模型 Qwen3-235B-A22B 在 benchmark 上的表现达到了业界顶尖的水平,与 DeepSeek-R1,Gemini-2.5-Pro, Grok-3 水平相当。小模型方面,即使是 Qwen3-4B 的水平也基本超过了前一
本地化部署DeepSeek-R1能保障数据在本地安全处理,防止敏感信息泄露至云端。企业可根据业务需求灵活调整硬件配置与模型参数,实现高效的可扩展性。同时,DeepSeek-R1配备了用户友好的界面及命令行工具,有效降低了使用难度,显著提升了用户体验。与传统的云端AI服务不同,Ollama允许用户在自己的机器上部署和管理这些模型,它为用户提供了在本地环境中运行大型语言模型的能力。
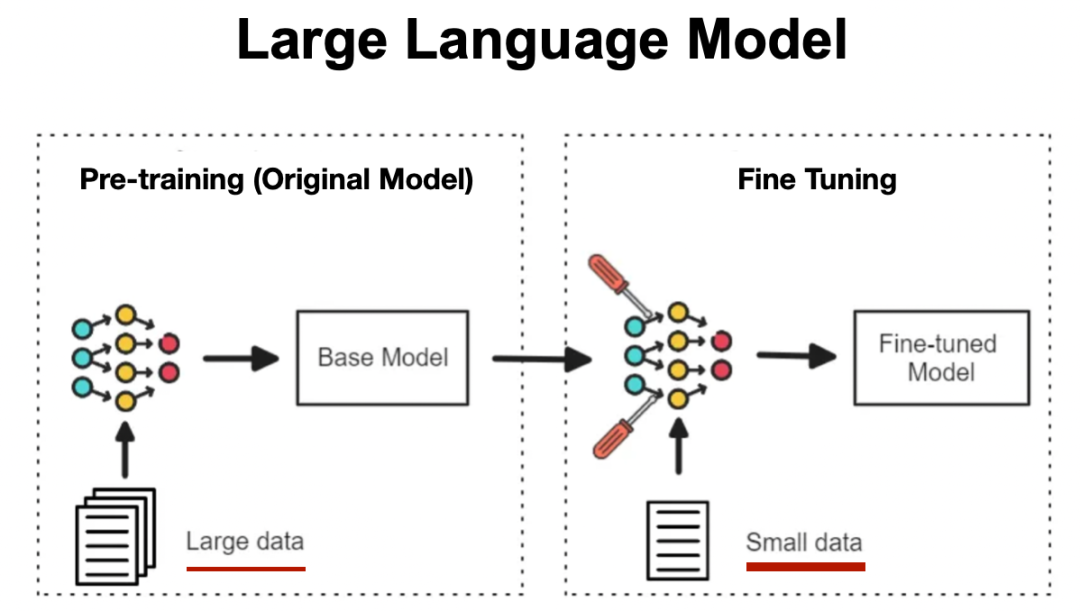
Fine-tuning(模型微调)到底是个啥?模型微调是在预训练大模型(如DeepSeek、LLaMA、Qwen等)的基础上,用特定领域或任务的数据集对模型参数进行二次训练,让大模型“从通才成为专家”。预训练模型:已在大规模无标注数据上学习通用特征(如语言规则、物体识别)。微调:注入领域专属知识(如医疗术语、金融逻辑),使模型具备特定场景下的专业能力。
在 AI 发展浪潮中,逻辑推理能力正成为衡量智能水平的重要标准。而DeepSeek-R1 作为一款由中国 AI 公司 DeepSeek 开发的开源推理模型,正引领这一领域的新变革。它不仅能解决复杂的数学问题,还能执行实时决策,为 AI 在实际应用中的落地提供了更多可能性。在本教程中,我将手把手带你完成 DeepSeek-R1 在本地的运行流程,并详细讲解如何使用 Ollama 进行环境配置。
实测下来,真的新版DeepSeek V3,提升不止亿点点:上下文理解能力显著增强,回复更加详细,不容易出现幻觉,prompt理解能力增强,更加遵守prompt。经过多次测试,发现回复的内容,习惯性的会增加表格,进行对比(这点太贴心了)所以,现在新版DeepSeek V3应该是目前最具性价比的大模型了。各方面能力都直逼Claude3.7,但API甚至还能免费用。
本文介绍如何通过Ollama结合Qwen2,搭建OpenAI格式的聊天API,并与外部函数结合来拓展模型的更多功能。tools是OpenAI的Chat Completion API中的一个可选参数,可用于提供函数调用规范(function specifications)。这样做的目的是使模型能够生成符合所提供的规范的函数参数格式。同时,API 实际上不会执行任何函数调用。开发人员需要使用模型输出来
Qwen3最引人注目的创新在于其动态可调混合专家架构。相较于前代产品的固定结构,第三代MoE系统通过以下机制实现智能资源分配:分层稀疏调度:配置文件中的mlp_only_layers参数允许开发者指定仅使用传统MLP的层序号,而decoder_sparse_step参数控制MoE层的插入间隔。例如配置mlp_only_layers = [0,6]时,模型将在第0、3、6层启用MoE,其余层保持密集
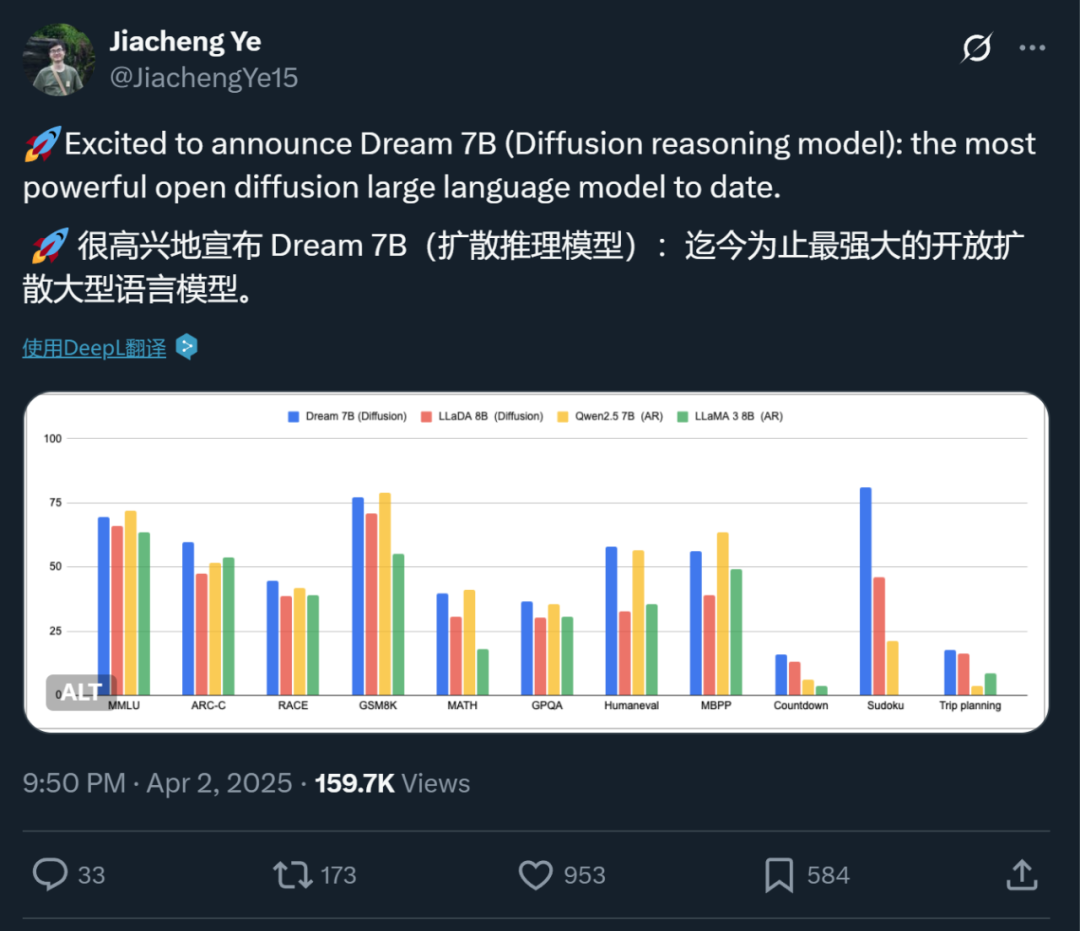
语言是离散的,所以适合用自回归模型来生成;而图像是连续的,所以适合用扩散模型来生成。在生成模型发展早期,这种刻板印象广泛存在于很多研究者的脑海中。但最近,这种印象正被打破。更多的研究者开始探索在图像生成中引入自回归(如 GPT-4o),在语言生成中引入扩散。香港大学和华为诺亚方舟实验室的一项研究就是其中之一。他们刚刚发布的扩散推理模型 Dream 7B 拿下了开源扩散语言模型的新 SOTA,在各方
本文记录了一张 8G 显存的 RTX 3070 实测本地部署 Qwen3.8-27B 社区量化版的全过程。作者通过三轮调参把生成速度从 3.5 t/s 提到 4.1 t/s,再通过切换 IQ2_M 量化把速度翻倍到 8.5 t/s,同时对比了 IQ4 与 IQ2 在质量和速度上的取舍。结论是:8G 显存跑 27B 完全可行,适合聊天、陪练和轻量角色扮演,但长文、代码等生产级任务仍需谨慎。
AI 编程助手(Cursor/Copilot/Claude Code)深度工作流优化:实践要点”不能只停在原则层。实际处理前,先把当前目标、可用输入、依赖版本和允许的操作范围写清。信息缺失时,结论的表述也应收窄:可以说明尚未确认的部分,但不能把推测包装成已经发生的事实。这样读者能判断文章中的建议适用于哪一段链路,而不是把它当成没有前提的通用答案。
本文介绍阿里千问 8 月 20 日发布的 GUI 智能体基座模型 Qwen-UI-Agent。它让 AI 学会"看懂屏幕、点击按钮、填写表单",从而真正替人操作手机和电脑。文章用数据对比展示其在真机测试中的领先表现,并通过跨 App 办事、无 API 操作、跨设备协同等案例说明能力边界,同时解答"现在能否使用"和"安全性如何"两大核心疑问。
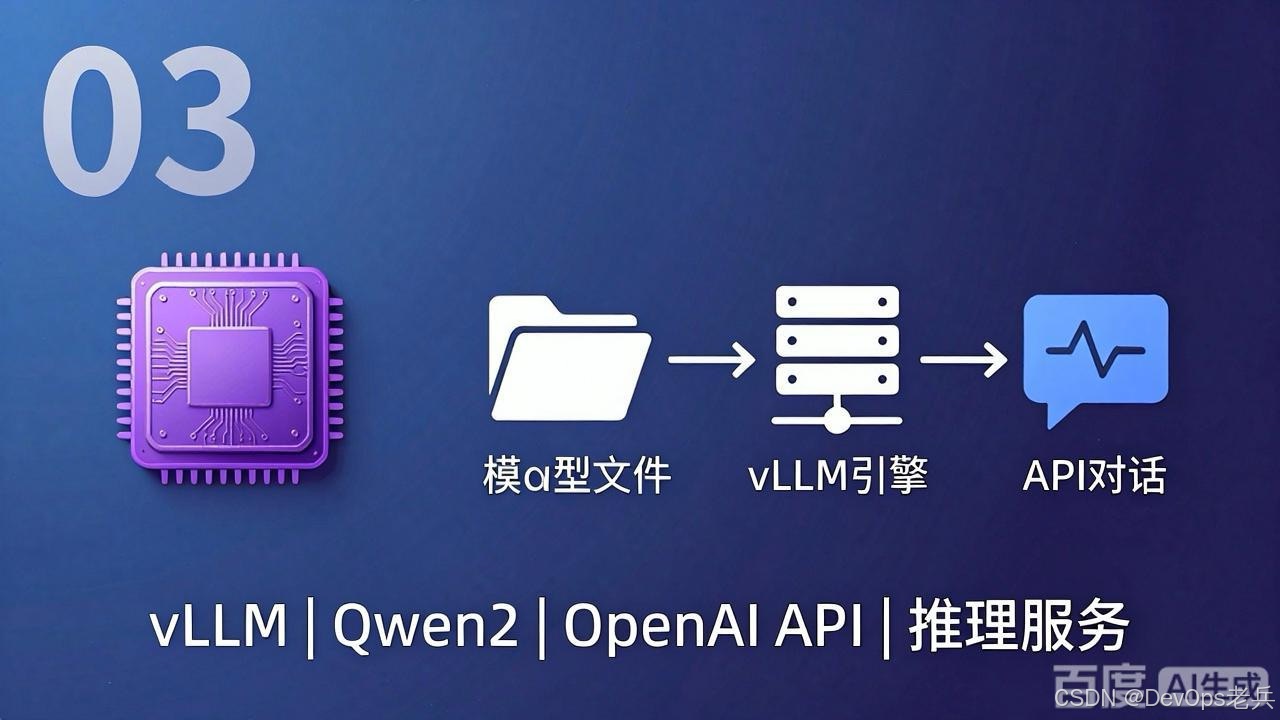
在AutoDL T4 GPU上部署vLLM推理服务,使用Qwen2-1.5B模型实现OpenAI兼容API。详解模型下载、服务启动、多种API调用方式(对话/流式/角色设定),附T4环境踩坑记录(HuggingFace镜像、flash-attn兼容)。