登录社区云,与社区用户共同成长
邀请您加入社区
ACES推理引擎CPU版优化,基于AVX2,达到11.1 tok/s,提升3.7倍,有开源地址,优化方法包括RMS Norm、RoPE、注意力、SwiGLU、Q4_K量化等。注意字数限制。</think>ACES推理引擎CPU版通过AVX2/SIMD及OpenMP优化,在14核上运行Qwen2.5-1.5B达到11.1 tok/s,为原始版3.7倍;采用Q4_K量化、f1
自Transformer架构被提出来之后,人们一直都在对Transformer架构进行更改,例如:从正余弦位置编码旋转位置编码RoFE、从多头Attention到DeepSeek的MLA、从前馈神经网络到当前的MoE架构等。而归一化(Normalization)在整体Transformer架构中并没有做太多的改进,但它对模型能否顺利训练,却有着很关键的作用。本文将带你一文了解归一化(Normali
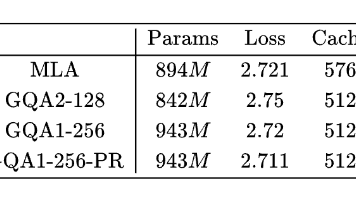
自从 DeepSeek 爆火后,它所提的 Attention 变体 MLA(Multi-head Latent Attention)也愈发受到关注。MLA 通过巧妙的设计实现了 MHA 与 MQA 的自由切换,使得模型可以根据训练和推理的不同特性(Compute-Bound or Memory-Bound)选择最佳的形式,尽可能地达到效率最大化。诚然,MLA 很有效,但也有观点认为它不够优雅,所以
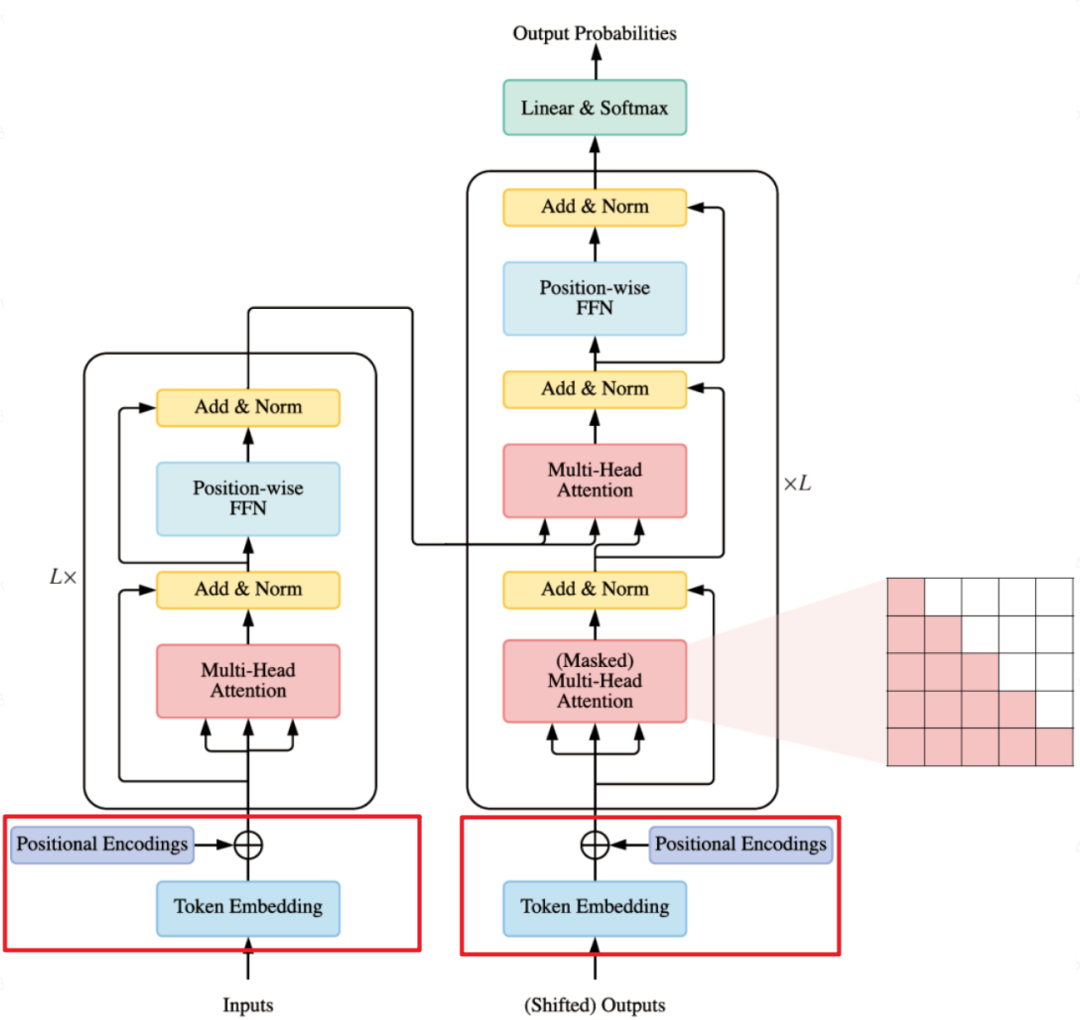
位置编码是大模型架构的重要组成部分。本文从位置编码的起源开始介绍,详细介绍Transformer位置编码、相对位置编码、重点介绍了旋转位置编码RoFE、ALiBI位置编码等,最后介绍DeepSeek位置编码,希望能够帮你对位置编码有一个详细的了解。文章结构如下:位置编码起源基础位置编码Transformer位置编码相对位置编码旋转位置编码(RoFE)ALiBi位置编码DeepSeek位置编码
大模型是同一栋“标准楼层”重复盖几十层:LLaMA-3 盖 32 层,DeepSeek-V3 盖 61 层。每个 Block 内部六步严格串行:归一化、注意力、加残差、再归一化、前馈网络、再加残差。本篇拆解其中的 LayerNorm:不做归一化,数值 10 层放大 114 倍变成无穷大,模型根本训不动;做了归一化,每行拉回均值 0 方差 1,深至 61 层依然稳定。含「西安」向量四步手算、γ/β
本文探讨了 DeepSeek Harness 插件系统如何通过依赖注入和服务定位机制解决传统 import 方式的耦合问题。核心观点包括: import 将功能需求与实现绑定在代码层,导致变更时需要修改多处文件; DeepSeek Harness 采用 YAML 配置实现运行时绑定,通过上下文(Context)和服务(Service)机制解耦; 服务提供方通过继承 Service 基类注册服务,消
DeepSeek Harness 设计解析:解决Agent工程两大核心问题 摘要: 本文剖析了DeepSeek Harness如何通过20万行代码解决Agent工程的两个核心问题。当业务逻辑与基础设施紧密耦合时,会出现两大痛点:1) 切换模型厂商需要大量适配工作;2) 新增功能需修改核心循环代码。DeepSeek Harness的解决方案基于三大设计原则:1) 插件化架构 - 所有组件均为可替换插
这篇文章介绍了如何用纯CUDA C/C++实现Qwen3-0.6B大语言模型的推理引擎,不依赖PyTorch等框架。作者采用极简设计,仅使用cuBLAS和CUB库,通过mmap异步加载模型权重、单块GPU内存管理、bf16推理等技术优化性能。手写CUDA Kernel处理RMSNorm、RoPE等操作,并实现KV Cache和Top-k采样。最终在RTX 3050上达到116 token/秒的推理
摘要: Anthropic公司针对Claude大语言模型开展的可解释性研究,通过稀疏自编码器、特征字典学习和因果干预等技术,实现了对神经网络内部计算过程的"思考解码"。该研究揭示了模型知识表征的分布式特性、多义性神经元的叠加现象,以及特征组合形成推理的动态机制。研究证明安全风险(如谄媚、欺骗)可通过内部特征监测被识别,并通过激活工程进行干预。当前技术仍面临特征重建误差、干预副作
本文介绍了医学问答模型的微调流程,采用LoRA技术实现高效参数调整。流程包括数据预处理(将原始医学问答数据转换为特定格式)、模型配置(基于Qwen3-1.7B模型,设置LoRA参数覆盖关键网络层)、训练参数(批次大小1、学习率1e-4、训练2个epoch)以及实验跟踪(使用swanlab记录训练过程)。该方法能生成包含思考过程的专业医学回答,同时通过梯度检查点等技术降低显存占用。整体操作简单易行,
在 16GB 显存的 Quadro RTX 5000 上用 vLLM 部署 Qwen3-8B 推理服务。通过 AWQ 4bit 量化(~4.7GB)+ YaRN 位置编码扩展(49152 tokens)+ 高显存利用率(0.97)解决显存瓶颈,使用 ModelScope 解决国内下载问题。
混合专家(Mixture of Experts,MoE)是大模型"参数膨胀但推理不慢"的核心技术。本文梳理了MoE从2021年到2026年的完整演进脉络:Switch Transformer解决训练稳定性、Mixtral 8×7B确立Top-2路由标准、DeepSeek-MoE创新细粒度+共享专家架构,最终在Kimi K3的Stable LatentMoE中收敛为896个expert、每token
2026年2月到7月,Kling 3.0 Omni、Gemini Omni Flash、MiniMax H3、Seedance2.5四款视频生成模型密集发布,原生音频已成标配。本文整理了Artificial Analysis三个排行榜、价格对标表、开源协议分析,帮你快速了解这轮军备竞赛的竞争格局和对开发者的实际影响。
亮点说明🧠理论驱动设计从Transformer注意力机制出发,而非盲目堆砌防御手段🏗️三层纵深防御模型层+应用层+架构层,互为冗余,单点失效不影响整体安全🎯真实场景验证以半导体晶圆厂为场景,高价值目标,攻击面真实🔐零信任工具鉴权每次工具调用独立验证,不依赖模型判断📊全链路日志67个测试用例覆盖,所有防御动作可审计🚀开箱即用Streamlit前端,DeepSeek API驱动,pip i
本文梳理了Transformer位置编码从RoPE到MRoPE的技术演进路径。RoPE通过旋转嵌入解决文本相对位置问题,成为主流LLM的基础。为适应多模态需求,mRoPE扩展至时空多维位置编码,交错mRoPE优化了维度融合,最终MRoPE实现了文本、图像、视频位置的统一表示。这一发展路线反映了从纯文本到多模态大模型的位置编码需求变化,Qwen-VL系列模型是典型应用案例。核心趋势是从单一文本位置向
本文详细分析了当前大模型推理中KV Cache显存占用的性能瓶颈问题,对比了MHA、GQA、MQA三种传统注意力机制的优缺点,并重点介绍了DeepSeek提出的MLA(Multi-head Latent Attention)创新解决方案。MLA通过三大核心技术突破: 1)低秩键值联合压缩技术,将高维K/V压缩为低维隐向量存储; 2)权重吸收机制,通过矩阵合并消除额外计算开销; 3)解耦RoPE策略
Transformer彻底讲透:为什么所有大模型本质上都是同一套架构,以及Attention凭什么成为AI时代的"万能胶水"? 你有没有想过一个问题: GPT、Claude、Gemini、Qwen、DeepSeek……这些大模型名字一个比一个响亮,底层架构却出奇地统一——全是Transformer。从2017年那篇叫"Attention Is All ...
95% 的人搞不懂 Transformer,真不是智商问题。是市面上 90% 的教程,第一页就祭出 Q、K、V 三个字母,然后默认你已经懂了线性代数。GPT、BERT、Claude……你能叫出名字的大模型,底下都坐着同一个东西——Transformer。可越是人人都讲,越是没人讲清楚。我也是被劝退过的那批人。它到底解决了什么问题?从这一问开始,我突然就通了。今天这篇,我默认你只会加减乘除。不堆一个
DeepSeek-V3是一款高效混合专家(MoE)语言模型,总参数达6710亿,但每Token仅激活37亿参数,平衡性能与效率。核心创新包括: 多头隐式注意力(MLA):通过低秩压缩优化KV Cache,显著降低显存占用; DeepSeekMoE架构:动态激活专家模块,实现跨领域任务的精准适配; 无辅助损失负载平衡与多Token预测训练目标,提升模型稳定性与表现。 模型基于14.8万亿Token预
DeepSeek推出DSpark系统实现大模型高效生成,通过半自回归架构和置信度调度验证两大创新显著提升推理速度。系统采用并行主干DFlash生成草稿,结合轻量顺序头注入token依赖,缓解传统推测解码中草稿质量差的问题;同时引入硬件感知调度器动态裁剪低置信后缀,避免无效验证拖累系统。线上实测显示,V4系列模型生成速度提升60%-85%,吞吐量提高51%-661%,在维持无损解码的前提下将服务性能
马斯克与奥特曼的公堂对峙,本质上是人类对AGI控制权的争夺。是开源的、受公众监督的AI更有利于人类?还是集权化的、有庞大资本支撑的AI能更快带来突破?目前没有人有答案。但我们可以确定的是:1. 工作逻辑已变:凡是能被文档化、逻辑化的白领工作,都处于高危区。2. 资本逻辑已变:估值不再看眼前的利润,而是看你距离AGI还有多远。3. 竞争维度已变:这不再是单纯的软件升级,而是关于算力、电力、算法和数据
论文还提了一个更早期的实验:Qwen2.5-Math-7B 做 RL 训练 10,000 步,得到的 Qwen2-Math-7B-Zero 在 AIME 2024 上是 22.3%,AIME 2025 上 18.1%。DeepSeek-R1 的工作证明了,纯强化学习可以激励大模型发展出复杂的推理行为——反思、验证、回溯——这些行为不是人类设计出来的,是模型在追求正确率的过程中自己发现的。技术的发展
LLM核心原理与应用摘要 大语言模型(LLM)是基于深度学习的自回归语言模型,通过海量文本训练掌握语言规律。典型代表包括GPT-4o、Claude等闭源模型和LLaMA等开源模型。其发展经历了从统计模型到Transformer架构的突破,核心驱动力是数据规模、参数量的增长和训练策略创新。 LLM训练包含三阶段:预训练学习语言基础、监督微调掌握指令遵循、人类反馈对齐优化输出质量。关键概念包括Toke