登录社区云,与社区用户共同成长
邀请您加入社区
本文分享了用DeepSeek Harness与Workbuddy组合实现测试用例自动生成的实践:通过10分钟配置,将PRD与接口文档转化为结构化用例,覆盖正常、异常与边界场景。虽需人工复核8条左右,但效率远超手写,尤其适合文档清晰的后端迭代。核心价值不在于“取代”测试,而在于释放人力,聚焦业务理解与风险洞察。
DeepSeek此次扩招150人,聚焦服务端开发与Agent弹性计算,虽非直接招聘测试岗,却为测试人提供了新机遇。面对AI系统落地中的稳定性、幂等性、异常恢复等工程挑战,过往的测试经验——如边界值、接口验证、日志排查、回归测试——依然关键。真正重要的是将经验转化为可验证的测试方法:从“接口返回成功”到“业务结果一致”,从“重试机制”到“防止重复执行”。通过模拟真实场景(如退款超时重试),构建可复现
2025 年,人工智能(AI)已从技术概念全面渗透到商业、医疗、教育、制造等各个领域。DeepSeek 等中国 AI 企业的崛起,不仅打破了国外技术垄断,更带动了国内 AI 人才需求的爆发式增长。据智联招聘统计,2025 年春招首周,AI 工程师岗位的求职增速高达 69.6%,平均月薪超 3.5 万元,资深研究员月薪甚至接近 10 万。然而,高薪背后是激烈的竞争:如何在 AI 行业站稳脚跟?哪些岗
文章介绍了开源大模型DeepSeek-V3.2的多种量化版本,解决原始模型690GB过大难以部署的问题。推荐了三种量化方案:AWQ 4bit版本(362GB)适合NVIDIA显卡;Qwen3-8B蒸馏版本(约16GB)可在双4090上流畅运行;MLX 4bit版本(378GB)专为苹果M系列设计。提供了各版本的下载链接、国内镜像及详细启动脚本,帮助不同硬件条件的用户实现本地部署。
本文系统分析了当前主流超大规模AI训练系统的架构设计与工程实践。通过对比PaLM、Llama 3.1 405B、DeepSeek-V3等六大代表性案例,揭示了算法-工程-数据的协同优化策略。关键技术包括:五维并行计算、FP8训练、MoE架构、专用通信库等,其中DeepSeek-V3在2048 H800 GPU上仅用2.788M GPU小时完成671B参数训练,成本仅为同类模型的1/30。研究还对比
2026年主流AI平台算法升级分析及GEO优化策略 摘要:本文针对2026年AI平台(DeepSeek、Kimi等)的核心算法升级展开技术分析,重点解析RAG检索增强生成、知识图谱构建、信源可信度评估和多模态理解四大模块的技术演进。在RAG方面,系统升级为混合检索模式,强化了语义理解和内容相关性排序;知识图谱从三元组升级为超图结构,具备动态推理能力;信源评估更注重一致性、时效性和专业深度;多模态理
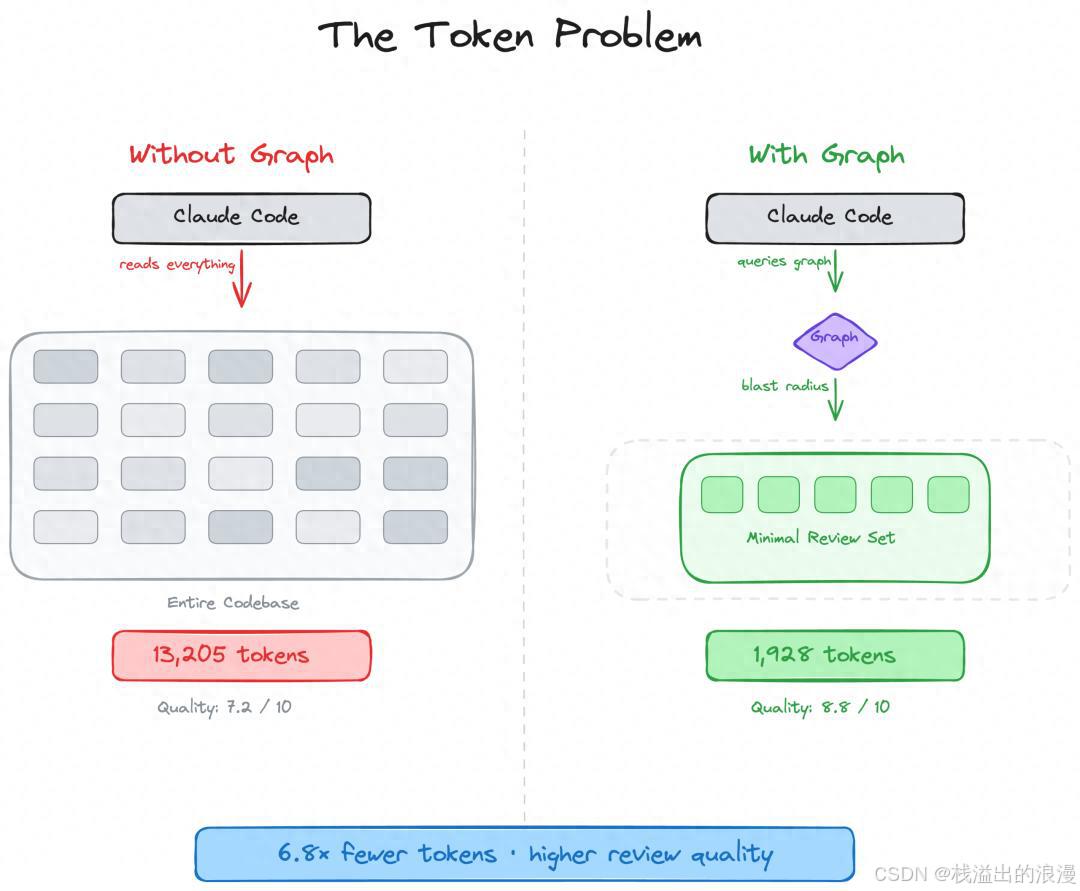
你有没有遇到过这种情况:在 Claude Code 里问一句「这个认证流程是怎么跑的?」、「我改这个类会影响哪里?」或者「帮我 review 一下最近的改动」
最近公司引入Claude Code做团队级AI编程,Demo阶段大家觉得挺香,结果联调时才发现:不同人的代码风格、权限边界、日志规范完全对不上,协作效率反而下降了。这件事让我意识到,AI工具从个人试用到团队协作,从来不缺能跑通Demo的人,缺的是能把边界和约束说清楚的人。回到GraphRAG这个话题,我见过太多项目:一个人能跑通,团队接手就崩。原因往往不是模型不够强,而是知识图谱的建模标准和实体抽
三面被问"百万行代码里怎么跑好 Claude Code"是一种什么体验?面试现场一愣,平时在几万行模块里跑得顺风顺水,可巨型 monorepo 这一关确实没实操过。回来翻官方博客补课,发现小项目用户最容易漏掉的,是规模化场景里那套"另一套玩法"。
最近看 Codex 和 Claude Code 从个人试用走向团队协作,发现一个规律:Demo 能跑通的人很多,能真正让团队用起来的人很少。很多人卡在权限、日志、可维护性这些" boring "的事情上。GraphRAG 也一样。去年我做了一个企业知识库项目,一开始觉得上 GraphRAG 肯定能碾压传统 RAG。结果上线后,团队反馈反而更慢了。不是模型不行,是工程细节没跟上。今天把这次踩坑的复盘
【摘要】DeepSeek V4-Pro 于2026年8月13日正式发布,相比预览版实现了Agent能力的显著跃升,多项编程与工具调用基准提升4-5倍,在TerminalBench2.1等指标上逼近Anthropic顶级闭源模型Claude Fable5,而价格仅为后者的2%。该模型采用1.6T MoE架构,支持100万Token上下文,兼容OpenAI和Anthropic双协议,主打高性价比(输出
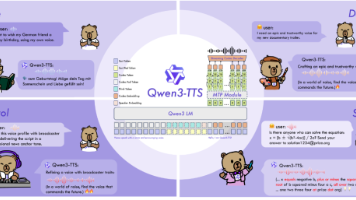
通义千问团队发布首个语音合成模型家族Qwen3-TTS,采用双轨架构提供12Hz(低延迟)和25Hz(高表现力)两种版本。该模型支持10种以上语言,经过500万小时语音数据训练,具有极致指令可控性、3秒零样本克隆能力、97ms流式生成和10分钟长音频稳定性等特性。在零样本克隆、跨语言合成及指令控制等任务上刷新SOTA,模型以Apache 2.0协议开源,为社区提供了强大的音频生成底座。
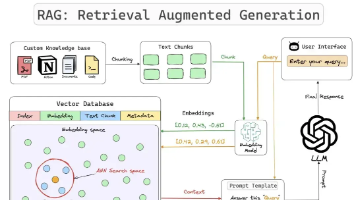
RAG的核心机制融合了信息检索系统的精确性和语言模型的强大生成能力,为基于自然语言的任务提供了更为灵活和精准的解决方案。
本文介绍了如何在星图GPU平台上自动化部署SeqGPT-560M镜像,高效实现新闻通稿中人物关系网络的自动抽取与可视化。该镜像专为中文新闻文本优化,可精准识别姓名、机构、职务及关系动词,一键生成可交互的关系图谱,广泛应用于媒体公关、政务信息分析和投资尽调等场景。
本文介绍了如何在星图GPU平台自动化部署Qwen3-Reranker-4B镜像,实现企业知识图谱中实体关系的智能重排序。该模型能精准识别查询意图,将最相关的实体关系(如“苹果公司CEO是谁”返回“蒂姆·库克”)优先排序,显著提升知识检索和智能问答的准确性。
本文介绍了如何在星图GPU平台上自动化部署EcomGPT电商领域智能助手镜像,快速构建基于Neo4j图数据库的商品知识库。该方案利用EcomGPT-7B模型从商品描述中智能抽取实体关系,并通过图数据库实现高效的商品关联查询和个性化推荐,显著提升电商数据管理和智能推荐能力。
本文介绍了如何在星图GPU平台自动化部署【ollama】ChatGLM3-6B-128K镜像,实现教材知识点自动关联功能。该应用能分析教材内容,提取核心概念并构建知识图谱,帮助教育工作者快速梳理教学框架,提升备课效率与教学质量。
Qwen3-TTS是一款开源的TTS模型,具有极低的端到端延迟(97ms)和高保真音色克隆能力。该模型支持自然语言语音控制,能够根据文本内容调整节奏和情感,并提供了1.7B和0.6B两个版本,适合不同场景下的个性化语音生成需求。文章详细介绍了Qwen3-TTS的技术特点、使用方法以及开源的诚意,鼓励开发者尝试并应用该模型构建语音应用。
Meta发布Muse Glimmer 30B模型,主打本地部署与自主代理能力,采用Apache 2.0开源协议。该模型从旗舰闭源模型Muse Spark蒸馏而来,在工具调用和多步代理任务上表现突出,4bit量化后可在消费级显卡运行,配合DFlash投机解码技术显著提升推理速度。然而,其跑分真实性遭社区质疑,且在部分编码任务上不及Qwen3.6-27B。模型生态支持迅速,但安全对齐问题已有报告。适合
最近 AI 编程工具的风向变了。Codex、Claude Code 这些工具从个人试用走向团队协作,招聘 JD 上也频繁出现"多 Agent 协同""知识管理""可观测性"这些关键词。我看了几份 2026 年的大模型岗位 JD,发现一个有意思的现象:单纯会调 LangChain API 的人已经不再稀缺,真正值钱的是能把 RAG 从 Demo 推到生产环境的人。而 GraphRAG 就是这道坎。去
本文介绍了如何在星图GPU平台自动化部署GLM-4-9B-Chat-1M镜像,实现超长文本处理与智能应用。该镜像支持单卡处理200万字技术文档,并能自动构建知识图谱和问答系统,适用于企业知识管理、智能检索和多轮对话等场景,显著提升文档处理与信息利用效率。
本文介绍了如何在星图GPU平台自动化部署🎙️ 清音听真 · Qwen3-ASR-1.7B 高精度识别系统,实现非遗传承人方言语音的精准转录。该系统能将口述内容自动转换为文字,并进一步构建知识图谱,应用于非物质文化遗产的数字化保护和传承,显著提升记录效率和准确性。
本文详细介绍了如何构建一个融合DeepSeek大语言模型与Neo4j知识图谱的电商智能对话推荐系统。系统利用DeepSeek解析用户自然语言意图,通过Neo4j知识图谱进行精准商品关系查询,并以Vue+SpringBoot实现前后端交互,旨在提供更智能、自然的购物推荐体验。
最近团队引入 AI 编程工具(如 Codex、Claude Code)进行协作开发时,出现了一个很有意思的现象:个人开发者手里跑得飞起的 Demo,一旦放入团队协作流程,立刻变成“Bug 制造机”。原因往往不是模型不够强,而是工程边界模糊——权限隔离没做好,可观测性缺失。这种“单兵作战”到“团队协同”的阵痛,在构建复杂知识库系统时同样存在。
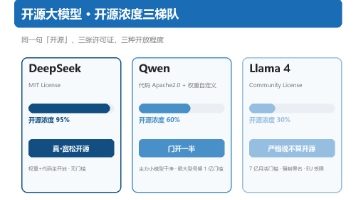
本文深度剖析了当前"开源大模型"概念被稀释的现象。文章将主流大模型分为三档:DeepSeek采用MIT协议最彻底开源;Qwen代码开源但大模型权重保留限制;Llama则通过社区许可设定了7亿用户门槛和品牌绑定条款。依据OSI开源AI定义,真正开源需同时提供数据、完整代码和参数,而当前多数模型仅开放权重,实为"开放权重"而非完全开源。文章揭示厂商通过有限开放获取开发者生态,同时保留商业控制权的策略,
文章摘要 本文介绍了一个独立开发的生产级AI知识库平台,整合了五大核心功能:RAG检索增强(包含真实语义嵌入与两阶段重排序)、ReAct智能体、多模型LLM支持、上下文记忆和知识图谱。平台采用前后端分离架构(React+FastAPI),支持Docker一键部署,并通过Web界面安全配置模型密钥。 关键特性包括: RAG全链路:支持多格式文档解析、分块、向量化及两阶段检索(召回+精排) 智能体系统
先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。上周需求评审会上,产品经理拍着桌子问:“为什么我们花了几十万搭建的知识图谱 RAG,回答准确率只有 60%?隔壁公司用 LangChain 加个向量库就能做到 90%。我沉默了三秒。因为我知道,问题不出在算法精度,而出在协作流程与数据治理的断层。最近 AI 编程工具(如 Claude Code、Codex 等)正从个