登录社区云,与社区用户共同成长
邀请您加入社区
DeepSeek涨价致月成本翻倍至48000元,缓存命中价最高涨300%。替代模型A、B月成本分别约36000元、30000元。建议个人开发者降本续用,中小团队评估迁移或混合方案,大型企业分步迁移并保留回滚预案。通过缓存复用、请求合并与模型分层调用,可降低40%成本。综合成本、能力与迁移难度,使用五维评分表决策更科学。
用DeepSeek辅助孩子学编程——3个能立刻用起来的提示词模板
从选题、沟通、代码质量等维度,总结参与开源贡献的实用建议。总结整段开源贡献旅程的感悟,鼓励读者迈出第一步。
LeetCode 82. 删除排序链表中的重复元素 II - Python3 实现。因为可能会删除头节点,所以使用哑节点(dummy) 简化边界处理。· prev 指向最后一个确定保留下来的节点。· curr 用于遍历链表。Python3 代码。
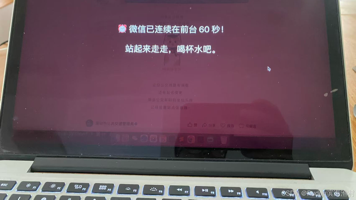
本项目基于Python与PyObjC,为macOS设计微信使用监控脚本:当微信在前台连续运行超60秒,自动弹出全屏提醒(持续15秒),帮助戒除网瘾。需下载并配置两个文件——主监控脚本wechat_monitor.py与开机自启plist文件,并设置权限与启动项。代码利用NSWorkspace检测前台应用,通过AppKit实现全屏警告界面,结合信号处理与线程控制,确保稳定运行。完整流程可复制咨询De
传统 WebShell 检测最大的问题:不是没有规则。而是:攻击者已经开始绕过规则。未来企业安全代码审计:本地大模型代码理解Prompt工程自动化扫描通过 Docker 部署 DeepSeek,将 AI 能力部署到企业内部,可以在保护源码隐私的同时,大幅提升代码审计效率。真正成熟的 AI 安全审计平台,不是简单调用 API。而是:构建属于企业自己的安全智能分析能力。如果在 Docker 部署拉取镜
<think>我们只需要根据内容生成摘要,≤150字。内容主题:Ollama本地大模型用于答辩,优势,适用场景,联系方式等。摘要要简洁概括。</think>Ollama 本地部署大模型,断网也能流式输出,规避 API 欠费、网络限制等风险,适合答辩演示。本科可选 qwen2.5:3b/7b 等,结合 Spring Boot 适配层实现本地优先、云端降级。论文可写本地推理、选型、双通道三节,强调自主
本文介绍基于DeepSeek API与Streamlit的AI对话助手源码,支持流式回复、深度思考、多模型选择及环境变量安全存储密钥。提供完整教程,含依赖安装、.env配置和运行方法,强调防泄露Key的重要性。
随着国产大模型生态的全面爆发,DeepSeek-V4、GLM-5.2、Seedance、Kling可灵、通义Qwen3、文心5.0等模型的迭代速度远超预期。但对于绝大多数企业和开发者而言,真正的挑战不在于“选哪个模型”,而在于“如何低成本、高稳定、合规地接入并调度这些模型”。2026年,API聚合平台已经从“可选工具”变成了“基础设施”。本文将基于技术能力、成本结构、稳定性、合规性四个维度,梳理当
<think>我们==需要生成一个不超过150字的摘要,基于提供的内容。摘要应简洁概括主要功能和设计要点。注意字数要求。先写一个草稿:本文介绍QwenPaw的多进程增强插件process-tools 0.4.3,解决内置shell工具在长任务、交互程序、后台进程方面的不足。核心设计将进程作为共享对象,提供exec/list/check/wait/communicate/notice六个工具,支持后
没什么好说的,就是实现上面第二张图的流程,唯一值得注意的就是for循环这里decode阶段sequence_length=1。(待完成)多模态支持(视觉塔/多模态预处理/多模态条件生成类/权重加载)(正在完成)QKVParallelLinear和GDN线性注意力层。(已完成)GemmaRMSNorm和MRoPE。(已完成)Qwen3.5架构介绍。(待完成)流式输出与多请求支持。(待完成)MTP支持
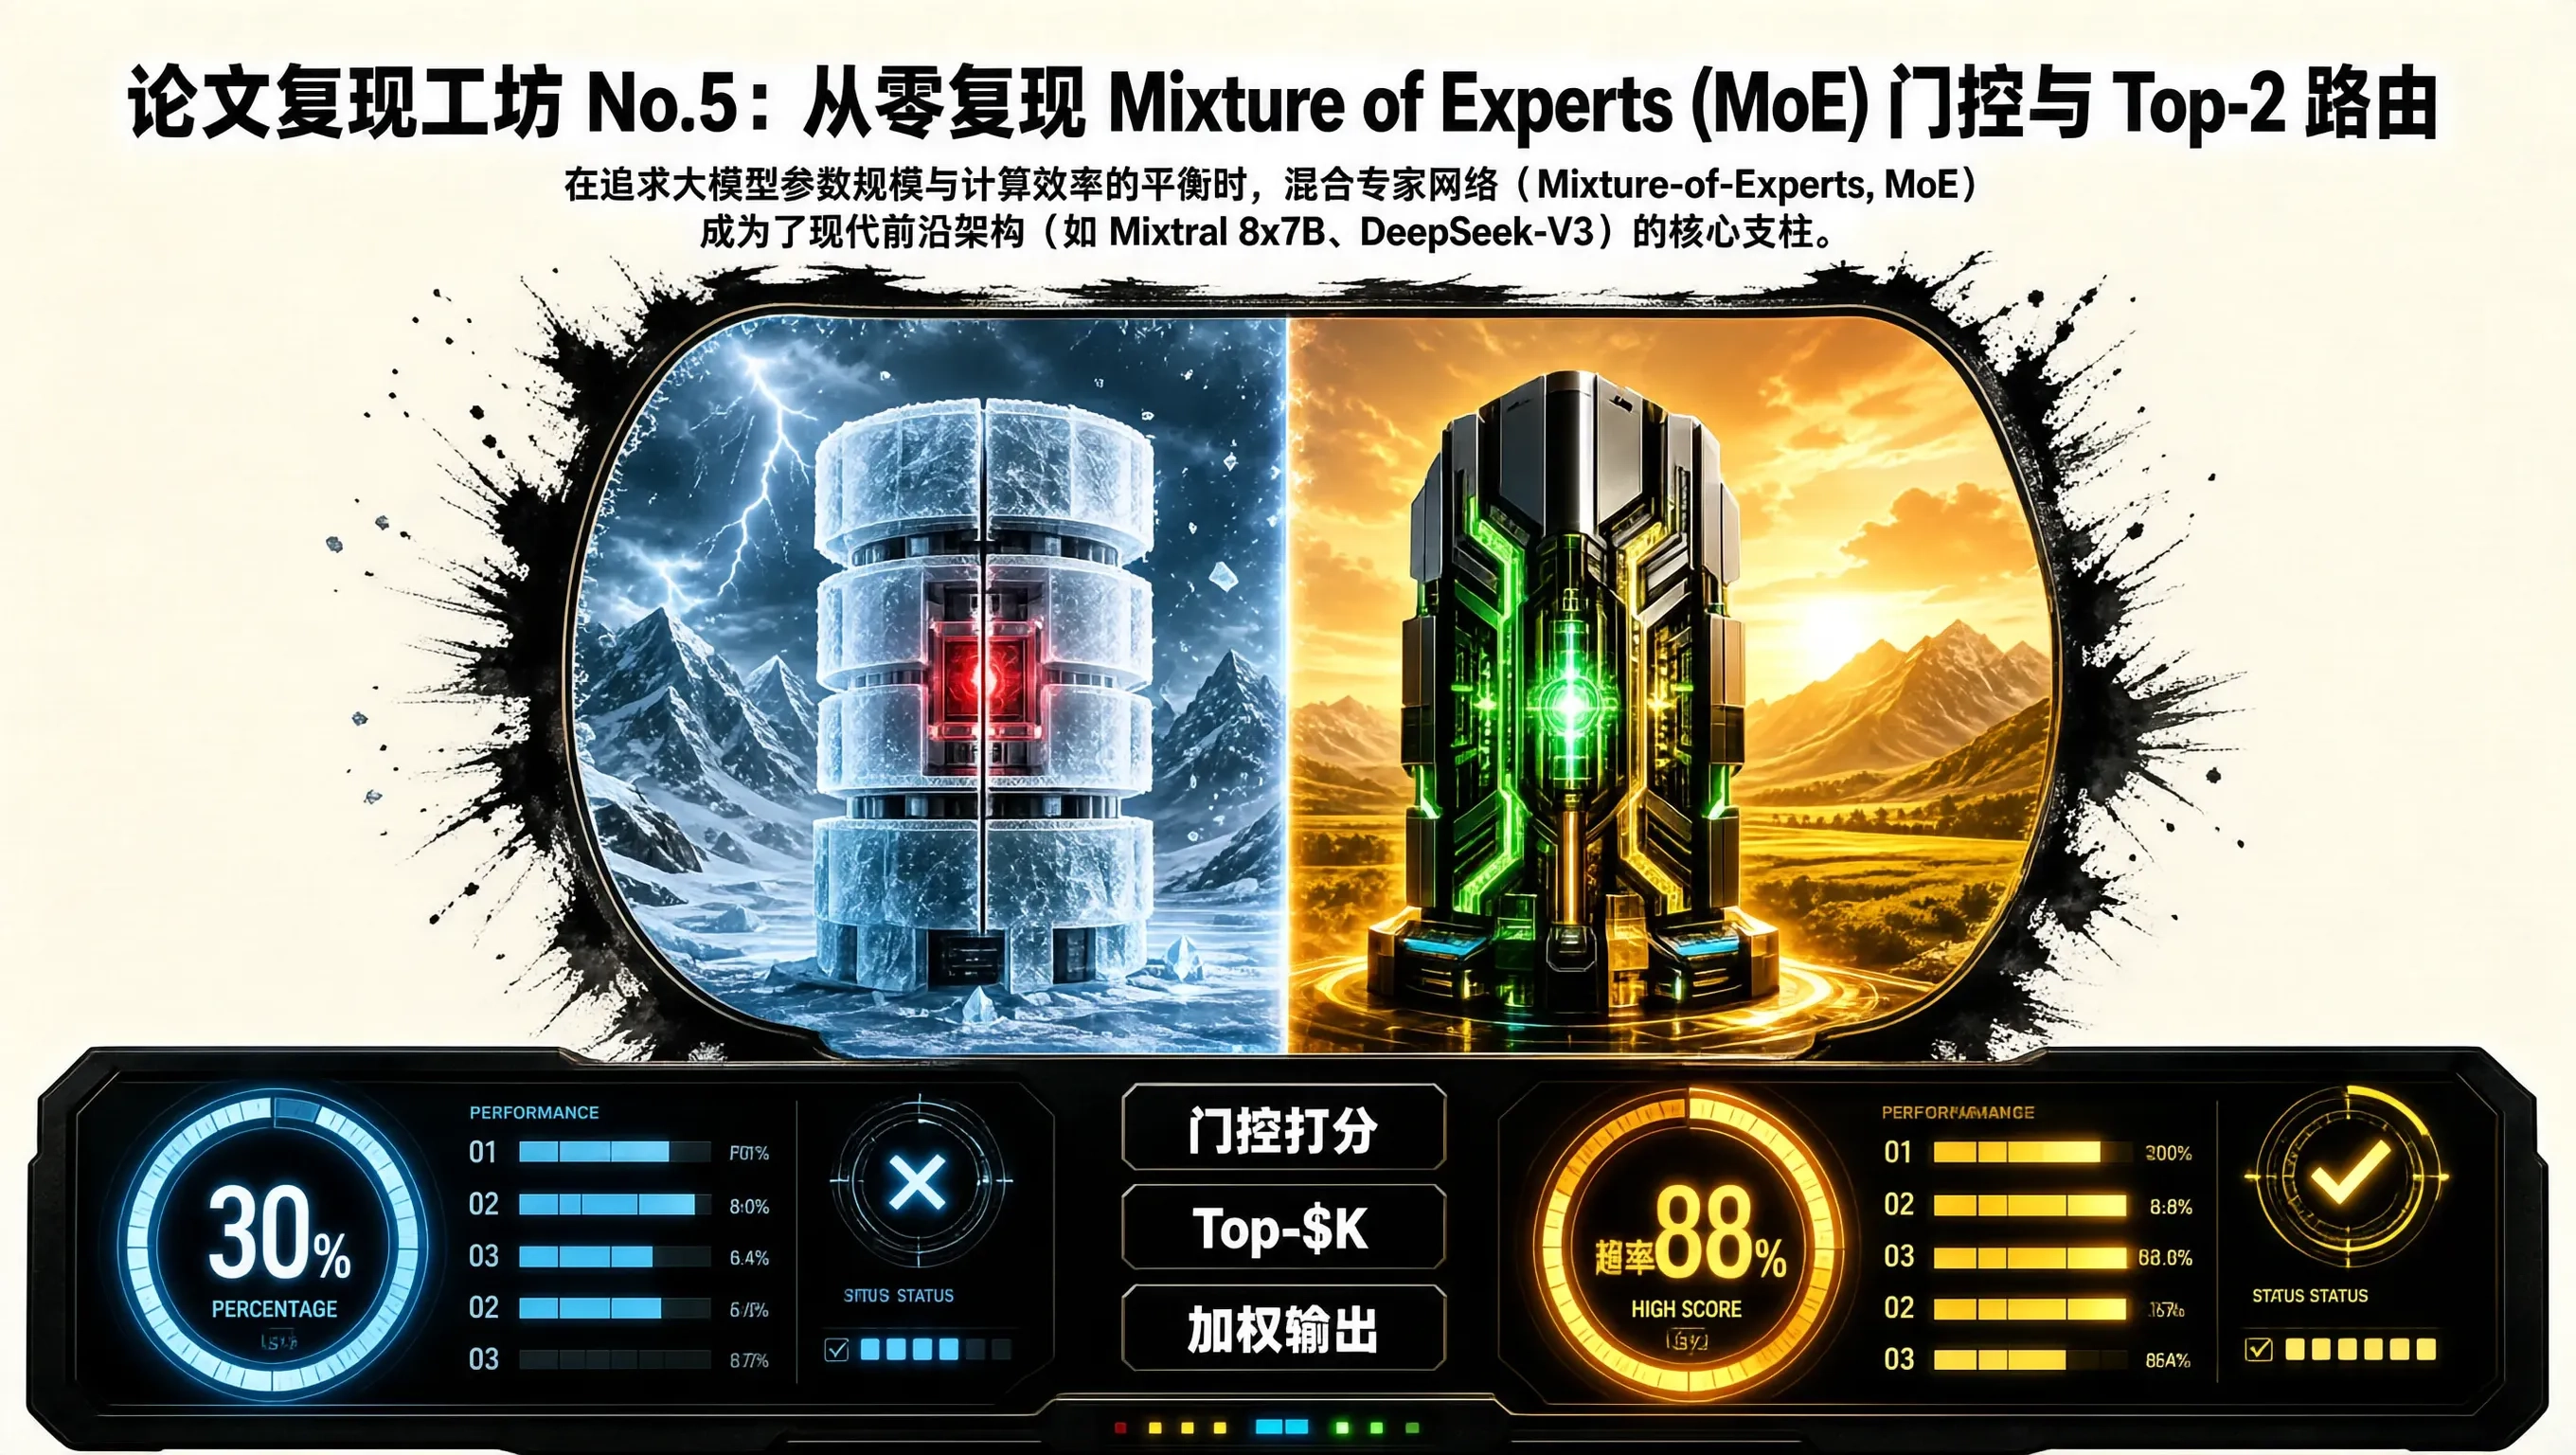
在追求大模型参数规模与计算效率的平衡时,**混合专家网络(Mixture-of-Experts, MoE)**成为了现代前沿架构(如 Mixtral 8x7B、DeepSeek-V3)的核心支柱。MoE 的核心思想是:在模型的 FFN 层维护 $N$ 个独立的专家子网络(Experts),对于每一个输入的 Token,门控路由器(Gating Router)仅动态挑选得分最高的 Top-$K$(通
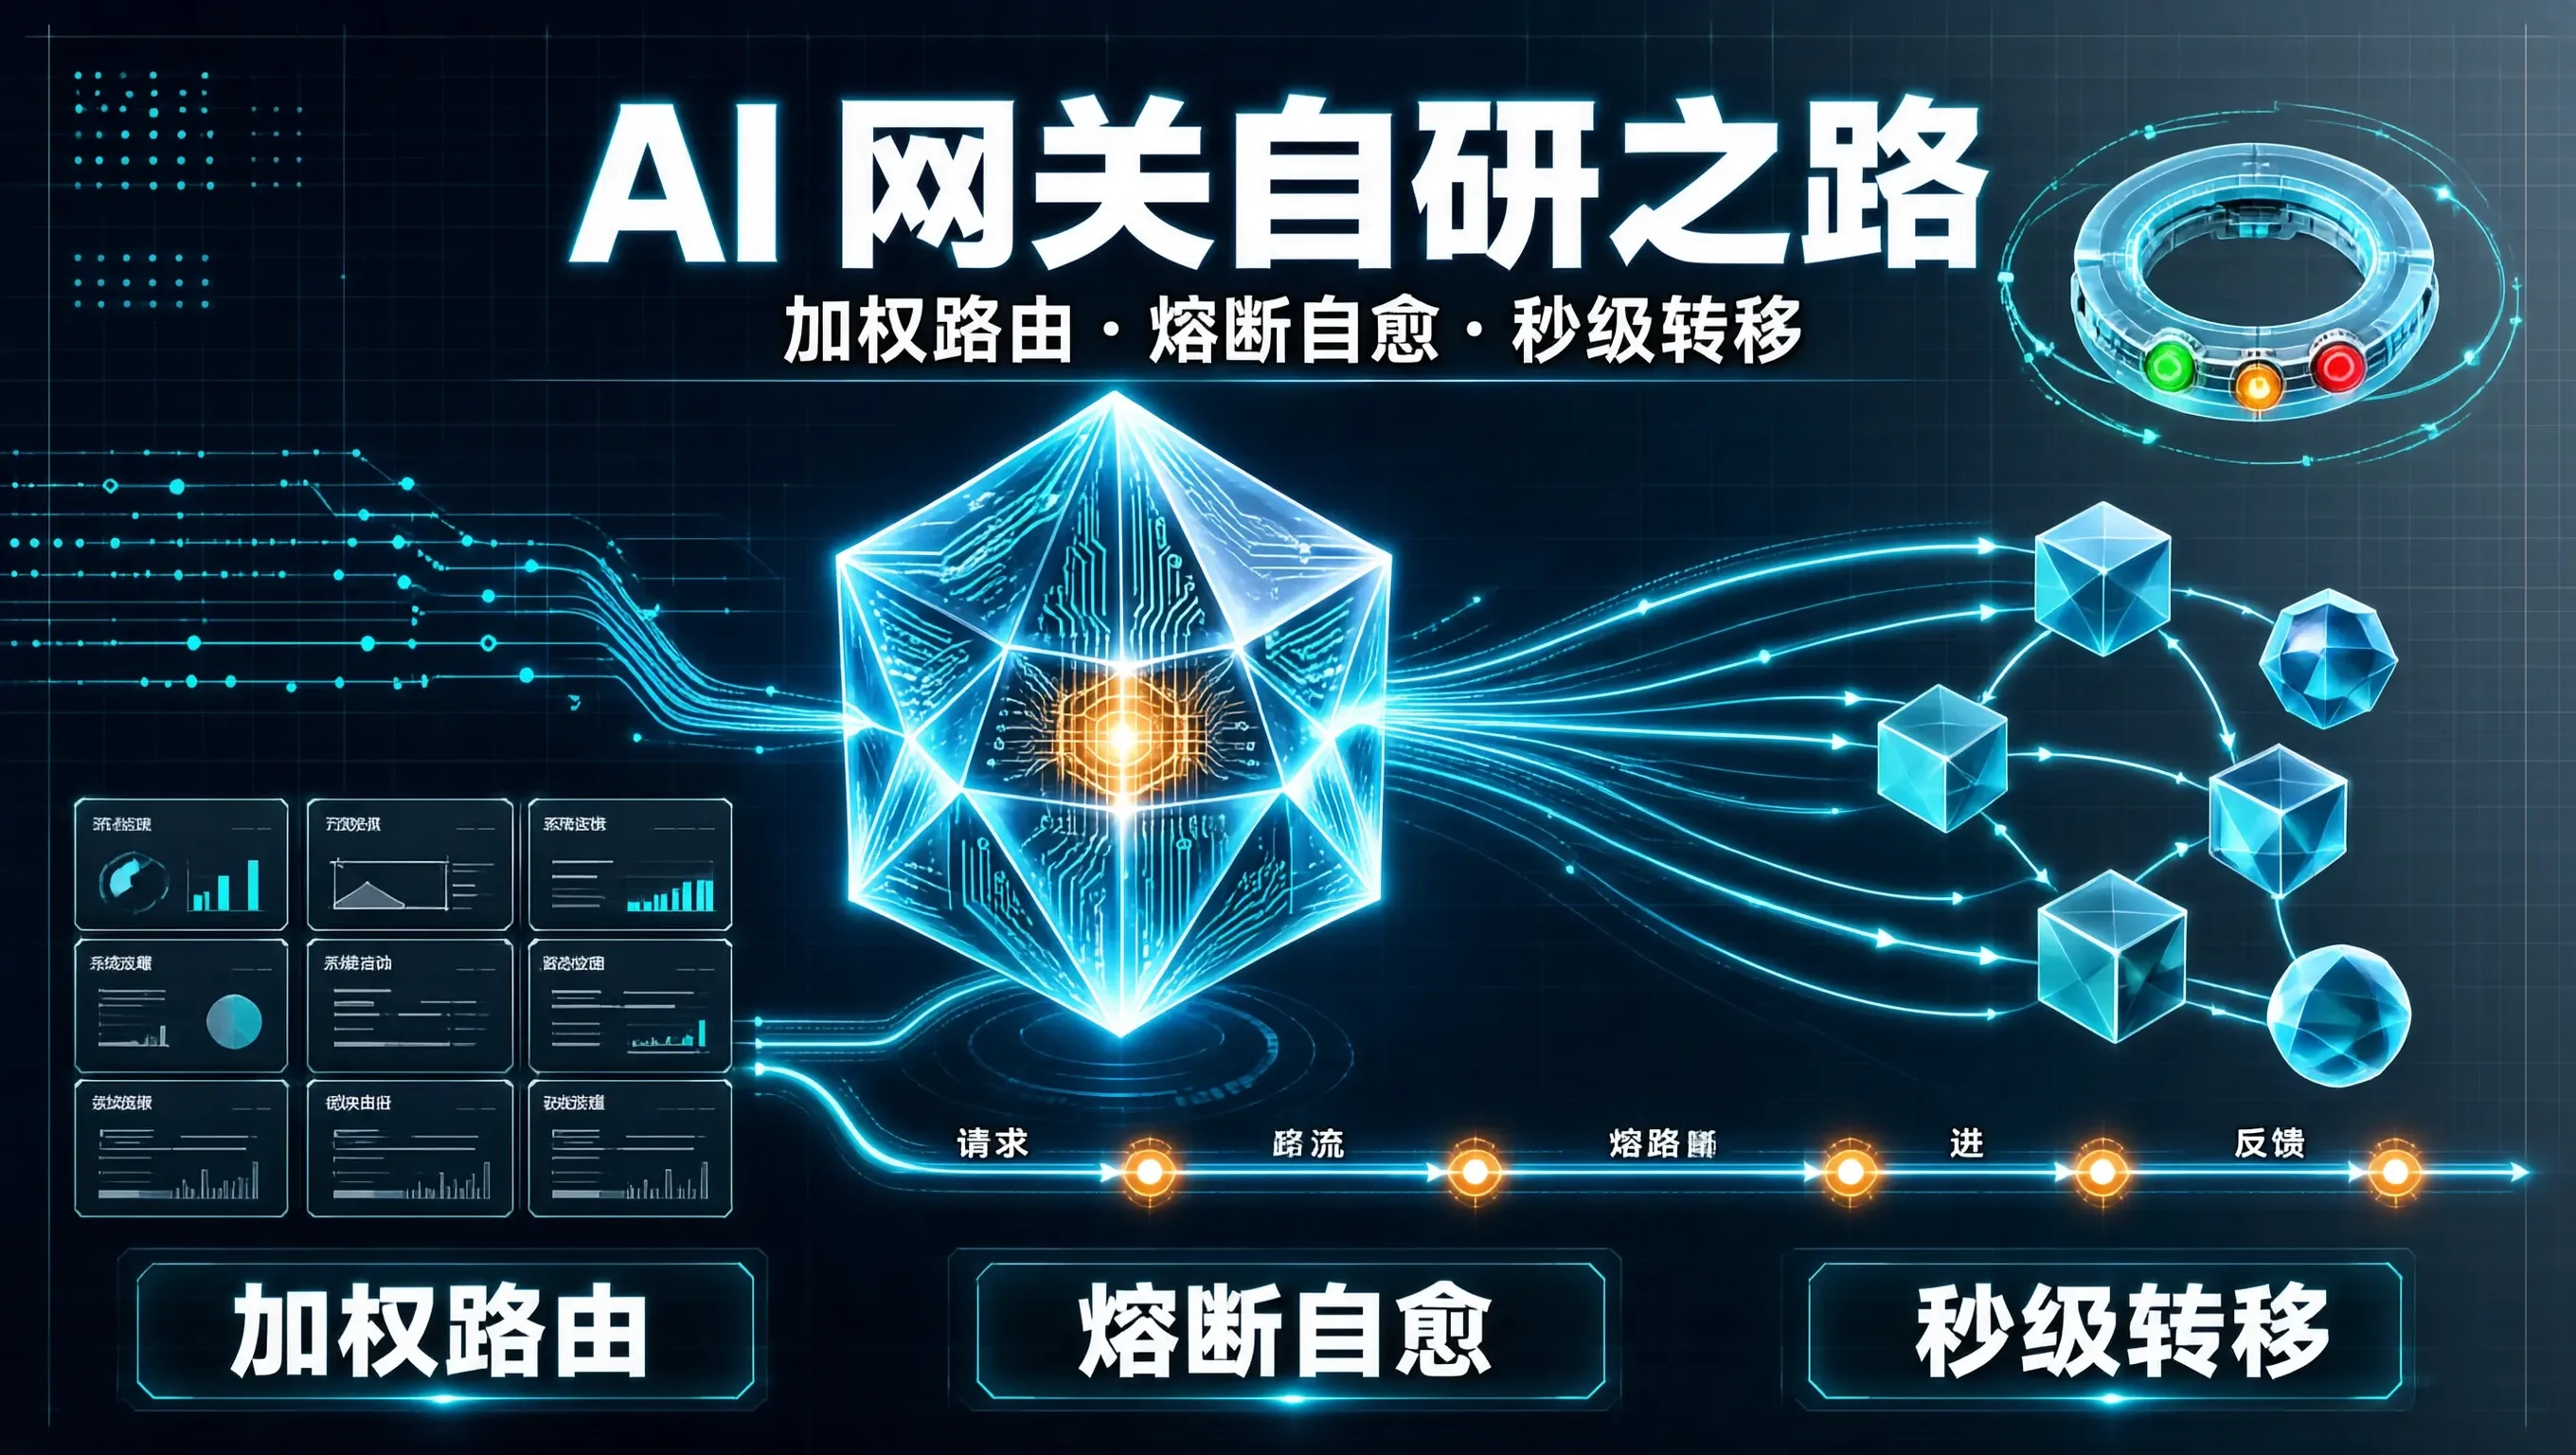
随着团队内大模型业务的高速扩展,我们逐步接入了多家公有云大模型供应商(阿里云百炼、腾讯混元、百度千帆、OpenAI、DeepSeek)以及团队本地自建的 vLLM 私有推理节点。针对这些痛点,我们用 Go 语言自研了一套轻量级、高吞吐的。单进程支持每秒 2 万并发路由,内存占用不足 80MB。今天我们把这套网关的核心代码完整开源分享。
只会调 API 不够,还要会"编排"! 本文用 DeepSeek 实测 LangChain:从消息类型、Runnable 接口到 LCEL 管道链,再到 bind_tools 工具调用,每步都有可直接运行的完整代码,零基础也能照着写。
ACES推理引擎CPU版优化,基于AVX2,达到11.1 tok/s,提升3.7倍,有开源地址,优化方法包括RMS Norm、RoPE、注意力、SwiGLU、Q4_K量化等。注意字数限制。</think>ACES推理引擎CPU版通过AVX2/SIMD及OpenMP优化,在14核上运行Qwen2.5-1.5B达到11.1 tok/s,为原始版3.7倍;采用Q4_K量化、f1
本文介绍如何在 Django 医学影像项目中接入 DeepSeek API。该系统区别于普通信息管理系统的关键,是在检测前后各加入一次 AI 能力:上传时由视觉 AI 验证图片是否为胸部 X 光片,CNN 分类后再由生成式 AI 给出通俗解释。一个 API Key 同时用于视觉图片把关、检测报告转写和健康科普问答,同时通过职责拆分和失败降级保证核心推理流程稳定。
│↓ ↓ ↓性能 易用性 AI│ │ │50–90% JS NumPy 支持 Python → JS30–90% JSON 智能默认 GPT / Claude│ 属性传播 ││ 类型转换 │↓Python 数据科学工作流↓Highcharts 可视化这比单纯增加几个 API 更值得关注。Highcharts for Python Toolkit v1.4.0 虽然是 Minor Release,但
把 AI 知识库搬回本机纯国内 永久免费的羽山数智方案,笔记层用 思源笔记,调度层用 Hermes,模型层跑 Ollama + Qwen。
考察点:技术敏感度,是否跟进行业动态。参考回答思路:它是 DeepSeek 在 2026 年 8 月 13 日发布的首款开源 Agent 产品,MIT 许可证。设计理念是"一切皆插件":Model Adapter、Tool Registry、Session Log、Agent Loop 全部可插拔、可替换、可检查,底层由 Cordis 插件治理框架驱动。它标志着 DeepSeek 从"造模型"走向
心血来潮使用了deepseek harness平台辅助开发了一款ai安全工具
针对“Claude Code能帮你执行交易了,但数据从哪来?”这一问题——答案是:通过 QuantDash 量化数据 API,你可以用 3 行 Python 代码为 Claude Code 接入 A股、美股、港股的全市场行情数据。QuantDash 提供原生 Pandas/Polars 支持、服务器端前复权处理、统一的多市场代码格式(如 600519.SH、AAPL.US、00700.HK),让
本文实现一套山西文旅RAG智能问答系统。项目以408条本地文旅问答为知识库,使用BGE-M3完成语义向量检索,使用BM25进行关键词检索,通过RRF融合两路排序结果,并根据代码配置选择本地知识回答或Qwen增强生成。文章包含系统界面、项目结构、核心代码、向量分布、检索命中率及延迟分析。
本文提出了一套AI辅助Web测试的方法论,核心是"AI探路,人工决策"的五阶段严格流程:系统探索(记录页面事实)、业务梳理(还原用户旅程)、用例设计(八维覆盖风险)、用例评审(九面检查)、真实执行(证据裁决)。强调阶段间不可跳跃,每个环节需通过评审才能推进,要求严格区分事实与推断,用Playwright等工具保留可验证证据(截图/视频),最终通过页面实际表现判定结果。该方法突出
对独立开发者来说,最大的价值就是:在官方正式发布前,能低成本摸到接近前沿的能力,尤其是 100 万上下文 + 多模态,对做复杂 agent 或代码理解类工具的人来说很有吸引力。如果你已经试用过,可以评论区交流一下经验,比如和Claude或其他模型对比怎么样?
本文是一份面向新手的CPU环境Qwen1.5-0.5B-Chat模型LoRA微调实战指南。主要内容包括:1)环境配置(Python3.10+CPU版PyTorch);2)数据集准备(10-15条高质量问答对);3)原生PyTorch训练流程(含LoRA配置与效果测试);4)模型合并(生成独立可部署模型);5)两种部署方案:轻量化GGUF+Ollama方案(适合日常调用)和FastAPI方案(适合深
当一个跑了一年多的基于 LLM 自动化流程积累了超过万条真实数据后,我产生一个想法:能不能用这些数据训练一个专用小模型,然后把 API 调用替换成本地推理,这样能够显著减少数据外出风险,同时也能学习到模型微调相关的知识(我承认这是一个主要目的)?因此有了本文,记录了从动机到落地的完整思路。
文章摘要: 小米发布 MiMo V2.5 大模型系列,包含 Pro(文本基座)、Omni(多模态)、TTS(语音合成)三款模型,支持百万级上下文、MIT 开源协议及私有化部署。开发支持云端 API(兼容 OpenAI)和本地部署,适合 Agent、长文档、多模态等场景。与 DeepSeek 对比显示,MiMo 在长文本、多模态、高峰时段成本优势显著,但数学推理仍依赖 DeepSeek。建议混合调用
本文基于2026年7月的实测数据,对比了6个主流视觉基座模型(Qwen3.8-27B本地版、qwen3-vl-32b-thinking、qwen3.5-plus、claude-opus-4-8、kimi-k2.6、ERNIE-4.0-8K)在视觉理解和Tool Calling任务上的表现。测试涵盖300张样图(CT切片、UI截图、发票OCR、菜谱理解、代码截图各60张)和20个Tool Calli
本文介绍 Claude Agent 的 4 种工具调用编排模式:Sequential、Parallel、Routing 和 Orchestrator-Workers。重点讲解 `readOnlyHint` 实现工具自动并行、`tool_choice` 强制调用路径,并总结 SDK 版本差异、性能提升及数据库写操作的安全实践。
DeepSeek Harness(dsh)是DeepSeek开源的Agent运行时框架,秉持“一切皆插件”理念,将模型适配器、工具、会话、主循环等全部组件化,基于Cordis实现可逆注册与依赖管理,支持动态组装、安全卸载与深度定制。
本文介绍了为DeepSeek Harness(DSH)设计的记忆增强架构,提出三层记忆系统(working/archival/core)和混合检索方案。核心思路是将索引转化为记忆通道,通过FTS5词法检索和sqlite-vec向量检索的RRF融合实现精准召回,同时利用事件元数据进行零成本标记。系统支持工具结果去重和KV-safe稳定注入,验证表明能有效提升上下文管理效率。该开源方案不依赖LLM元数
摘要:DeepSeek Harness 的中文检索功能存在缺陷,使用 SQLite FTS5 的 unicode61 tokenizer 时,连续汉字会被视为单个 token,导致子串查询(如「Token消耗」「索引优化」)无法命中。解决方案采用 trigram tokenizer 双表 + 1-2 字 LIKE 回退 策略: 问题根源:unicode61 将连续中文视为单个 token,短语查询
本文介绍了DeepSeek Harness(DSH)这一AI代理开发框架的核心概念与实践指南。主要内容包括: 框架定位:DSH采用"Model + Harness"架构,强调"一切皆插件"的设计理念,提供高度可定制化的开发底座,与开箱即用的成品Agent形成对比。 快速入门:详细说明了30分钟上手指南,包括环境准备、两种安装方式(npx快速启动/源码开发)、首次配置的5个关键步骤和验证任务。 四种