登录社区云,与社区用户共同成长
邀请您加入社区
同一份输入,缓存命中付 0.02 元,未命中付 1 元。50 倍的价差,是理解「中国模型调用量连续 20 周超过美国」最直接的一把尺子。
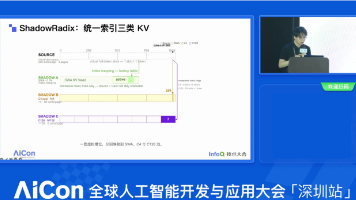
优化项解决的问题效果三种注意力KV管理混乱统一虚拟缓存,物理层独立管理逻辑地址到物理地址映射三套独立映射,支持动态压缩/释放三级缓存(HiCache)百万Token KV存不下前缀复用率超90%状态分离压缩/释放影响其他类型一份逻辑前缀,三套独立物理映射。
9月9日,DeepSeek 开放平台发布公告,宣布从北京时间 9月10日 12:00 起下调 flash 系列模型价格,其中输入缓存命中价格最高降幅达 60%。据报道,这距离上一次涨价还不到一个月——8月中旬 V4 Pro 正式版上线时,DeepSeek 刚同步上调过一批 API 价格,涨幅最高的一档达到 11 倍,当时在开发者圈子里引发了不少讨论。一涨一降之间,值得聊的不只是价格数字本身。
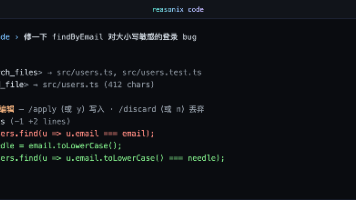
Reasonix 值得关注的地方,不只是它做了一个 DeepSeek Coding Agent,更在于它把"模型计费机制"放进了 Agent 的架构设计里。过去我们聊 Coding Agent,更多关注模型能力、工具调用、上下文管理和代码修改效果。但 Reasonix 提醒了一个更现实的问题:Agent 想要长期运行,成本本身也是工程问题。如果上下文组织不稳定,再便宜的模型也可能在长会话里慢慢变贵
编程中GPT-6 Astra缓存命中率低?试试VS Code扩展Claude Code Config
摘要: 国产大模型API的缓存计费机制存在显著差异,GLM、Kimi、DeepSeek为自动缓存,Qwen需手动配置显式缓存。DeepSeek最新调价后,缓存命中价仅为未命中价的3.3%(峰谷时段统一比例),四家模型的实际折扣比例相差近6倍。缓存命中率对成本影响巨大,例如80%命中场景下,DeepSeek总费用最低($21.56),而30%命中时Kimi费用激增至$279。Qwen3.8-27B目
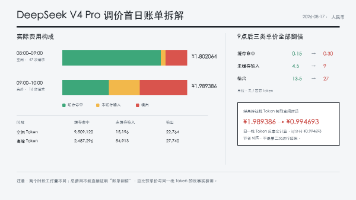
本文通过分析DeepSeek API在空闲时段(08:00-09:00)和高峰时段(09:00-10:00)的实际账单,验证了峰谷计价机制的实施情况。结果显示高峰时段三类Token(缓存命中输入、未缓存输入和输出)的价格均为空闲时段的2倍,且计费系统能准确切换。由于不同时段请求量和Token构成不同,不能简单比较两小时总费用差异。反事实计算表明,相同Token数在高峰时段费用会翻倍。文章最后给出错
deepseek-v4-flash: 请求1次,输入428,输出188deepseek-v4-pro: 请求5次,输入(命中缓存)88320,输入(未命中)34507,输出3216总费用:0.42元两轮对话,居然产生了88,320个缓存命中Token和34,507个未命中Token?明明只说了两句话,为什么Token消耗如此之大?更巧合的是,就在同一天(2026年8月17日),DeepSeek正式
跑分的是13个模型,覆盖Gemini 3、GPT-5、GPT-4.1和Gemma 3四个家族,每个模型开关thinking各跑一遍,每道题采样八次,攒出约450万条回答。出题全交给了模型:Gemini-2.5-Pro生成,Google搜索逐题验证,答案不唯一或题目有歧义的,连带整条事实一起丢弃。Gemini-3-Pro存下了94.5%的冷门事实,热门事实是99.5%,只差5个点。谷歌提出的「知识画
Qwen3.8 27B模型试用
DeepSeek V4 Pro 正式版上线,性能提升显著 8月13日,DeepSeek V4 Pro 正式版在APP、网页端和API同步上线,支持专家模式及多项API功能(Tool Calls、JSON Output等)。官方评测显示,V4 Pro在Agent/Coding任务上多数超越Claude Opus 4.8,整体接近Claude Fable 5,DeepSWE得分达63%。API定价采用
本文探讨了Postgres生产环境中高基数工作负载对pg_stat_statements的影响。高基数工作负载指持续生成超出pg_stat_statements.max容量的独特查询,导致无法保留关键性能指标。文章分析了独特性查询的来源,包括ORM生成的动态SQL、AI工具查询等,并通过Bluebox工具演示了Postgres 17与18版本在处理可变IN列表时的差异(17版生成671条独特语句,
但问题是,模型还得支持多轮对话啊。到了下一轮,模型需要记得自己上一轮想过什么。厂商又不想把每位用户的完整推理都保存在服务器上,于是采用了一种省事的办法:把加密推理块交给客户端保管,用户发起下一轮请求时,再把它原样传回API,服务端解密后交给模型继续处理。打个比方,模型每轮思考完,会把“草稿纸”锁进保险箱交给用户保管;下一轮对话时,用户再把保险箱递回来,模型就能接着往下想。用户全程拎着保险箱,却不知
摘要: 大模型推理中,KV Cache(键值缓存)和Prefix Caching(前缀缓存)技术通过缓存历史token的Key/Value,显著降低了重复计算成本,使主流模型的缓存命中率稳定在90%左右。当前技术方向包括优化显存管理(如PagedAttention)、跨请求复用(如vLLM和SGLang的方案)以及突破前缀限制的研究(如Prompt Cache)。商用模型(如GPT-4、Claud
文章摘要(140字): 7月大模型API市场迎来三大关键变化:智谱GLM-5.2上线1M长上下文窗口,实测合同审查漏检率从15%降至3%;词元国家标准落地统一计费标准;国产模型在OpenRouter调用量暴涨27倍。通过多模型路由策略(按任务复杂度分级调用GLM/Qwen/Claude等),综合成本降低67%。实测显示,国产模型在长文本处理、性价比上已超越部分海外旗舰,建议结合任务类型动态选型,优
本文基于真实业务监控Token数据,测算DeepSeek、通义千问、GLM、GPT-4o、Claude、MiMo单日使用成本,给开发项目模型选型、控费提供量化参考;各类大模型Token消耗成本对比分析(开发场景实测数据)
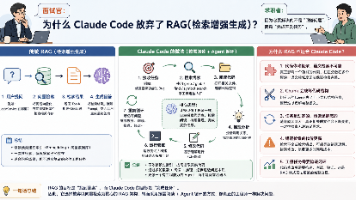
本文探讨了AI编程工具为何逐渐放弃传统RAG(检索增强生成)技术。传统RAG依赖向量数据库检索代码片段,但存在结构不匹配(代码需要精准结构而非语义相似)、索引滞后(代码频繁修改导致索引过时)等问题。新兴工具如Claude Code转向"智能体主动检索",利用大模型自身能力(如200K上下文窗口)和工具调用(grep/文件系统)直接探索最新代码,虽消耗更多Token但保证了精准性和时效性。这种转变反
DeepSeek-V3是一款高效混合专家(MoE)语言模型,总参数达6710亿,但每Token仅激活37亿参数,平衡性能与效率。核心创新包括: 多头隐式注意力(MLA):通过低秩压缩优化KV Cache,显著降低显存占用; DeepSeekMoE架构:动态激活专家模块,实现跨领域任务的精准适配; 无辅助损失负载平衡与多Token预测训练目标,提升模型稳定性与表现。 模型基于14.8万亿Token预
摘要(149字): 通过“图书馆借书”类比解释缓存机制:缓存未命中(Cache Miss)如同首个读者询问“Python网络爬虫”,馆员需从零整理答案,成本较高(如DeepSeek-V4未命中价为1元/百万tokens);缓存命中(Cache Hit)则像后续相似问题直接获取现存笔记,成本极低(0.02元)。优化关键在于前缀匹配——将系统指令、背景知识等稳定内容置于提示词开头,用户变量部分放在末尾
把这一圈走下来,会发现Prompt Cache 是 Claude Code 这套 harness 的地基,而不是一个可选的优化项。它的逻辑层层咬合:前缀匹配决定了"什么能复用"→ 字节级一致决定了"怎么才算复用"→ 定价倍率决定了"复用值多少钱"→ Fork 把这套机制推到极致,让多 agent 并行的边际成本逼近于零。承认缓存破坏不可逆,于是干脆锁定、不做无用功——和上一篇聊到的"断路器"异曲同
上周师妹去面腾讯微信读书的大模型开发岗,三面的时候被问了一道场景题。面试官说:如果用 Claude Code 来辅助写一本书,内容很长,容易超过上下文长度,你怎么处理?
基于第一性原理的拆解,LangGraph状态存储需要解决的核心问题可以分为通用存储问题与生成式AI专用存储问题我们首先对LangGraph的抽象状态空间进行数学形式化定义:TT:所有Thread的集合,Tt1t2tnTt1t2...tnnnn为Thread的总数;StSt:第ttt个Thread的所有可能状态的集合,称为“状态子空间”,S⋃t∈TStS⋃t∈TSt称为“全局状态空间”;
摘要:DeepSeek API 返回 429 错误时,可通过查看错误类型(如限流或余额不足)、指数退避重试、控制并发请求(不超过2个/秒)、设置备选模型(如Claude Haiku或GPT-4o-mini)以及检查账户配额来解决。常见原因包括请求频率超限、账户余额不足或配额耗尽。建议利用响应头信息预判限流情况,或使用请求队列和指数退避算法优化重试策略。多模型Fallback架构可确保高可用性,避免
本文介绍如何利用AI工具Claude Opus 4.8辅助整理遗留项目的交接文档。针对SpringBoot+MySQL+Redis项目的典型问题(配置过时、资料分散),作者提出分步骤处理方案:先整理项目依赖和启动条件,生成待确认问题清单,再基于已验证信息编写README初稿,最后沉淀常见问题排查流程。文章强调AI只应作为辅助工具,需人工验证所有关键配置,并提供了多模型协作建议和风险边界提醒,核心主
当一次 Agent 任务跑两个小时、烧掉几十次 LLM 调用、写过磁盘、调过外部 API,Worker 重启那一瞬间,你希望发生什么?长回答就是这篇文章要讲的事情——从 Replay Boundary 第一性原理出发,拆解 LangGraph、Temporal、Anthropic Claude Managed Agents、Microsoft Durable Task 这四个主流方案的工程做法,再
每次调用API时,你都在为相同的系统提示词反复付费,相同的上下文被反复处理,相同的token被反复计费。,特别是对于:- 具有大型系统提示的应用(1000 tokens以上)- 高频重复调用的场景- 多轮对话类应用2026年,随着各大模型厂商对缓存机制的完善,这项技术已经从"高级技巧"变成了"标准配置"。不使用Prompt缓存的AI应用,就像不使用CDN的Web应用一样,是对资源的不必要浪费。:缓
针对电力规程问答场景中通用大模型幻觉频发、大模型API响应超60秒、长尾问题覆盖不足等痛点,本文设计并实现了一套五级兜底架构的RAG问答系统。系统采用Redis缓存、BM25关键词、Milvus混合检索(稠密+稀疏)、千亿大模型API、人工座席五级逐层兜底,保证100%回答率。技术层面,通过bert-base-chinese微调实现94%准确率的意图分流,BGE-M3+Milvus保障语义与关键词
DeepSeek三大使用方式全解析:选对工具效率翻倍 移动端、网页端和API调用是DeepSeek的三种核心使用方式,各有独特优势: 移动端适合碎片化场景,提供语音输入、拍照识图等便捷功能,但不宜作为主力工具 网页端是功能最全面的工作台,支持文件上传、代码高亮、多会话管理等深度功能 API调用面向开发者,可实现自动化处理和企业级集成 关键选择策略: 日常轻量使用:移动端+网页端组合 深度开发需求:
但如果你正好有一台 128GB 的 Mac,又恰好对 DeepSeek V4 Flash 感兴趣,ds4 确实给了一种非常具体的玩法:把 Claude Code 接到本地,让 284B 的 MoE 模型在自己的桌面上写代码、调工具,不联网,不付费,不送数据。如果你顺着这个线索去想,会发现整个 ds4 的存在本身就是一个论据:单人项目用 AI 工具,能在合理时间内做出一个 Metal 推理引擎,跑通
3.配置有两种方式,我们看一下源码,ChatMemoryRepository 下面有几个实现类,我下面配置的是 JedisRedisChatMemoryRepository。本来想让AI写一下下面步骤的,测试了豆包,deepseek这些都不行,AI写的东西都是瞎写的,,我都无语了,只能直接手动写了,啥也做不了,不得不吐槽。最后看一下效果,只要多发几次消息,redis里面有这个缓存就行。6.cont
看起来你下载的是 Redis 的**源代码包**(从文件夹 `src`、`tests` 以及文件 `INSTALL` 可以看出来),这个版本是给 Linux / macOS 系统准备的,需要通过编译才能使用。你在 `C:\Users\WangShuo>` 路径下直接运行 `redis-server.exe`,系统提示找不到命令,这是因为**当前目录不是 Redis 所在的目录**,而 Redis
白云智算是openai风格, 代理服务器的作用是将其转为Anthropic 风格。