登录社区云,与社区用户共同成长
邀请您加入社区
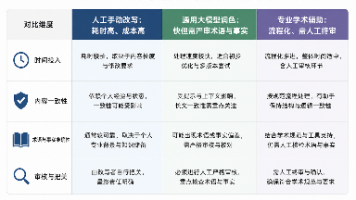
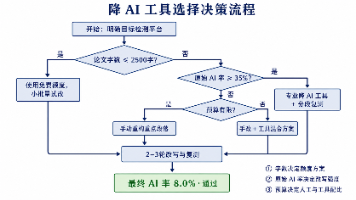
如果时间充裕,完全可以用上面的DeepSeek指令免费改写,能省下不少开支。但如果已经到了最后截止日期,或是论文格式复杂(比如带图表、公式),建议优先选择专业工具,避免因手动修改打乱格式或达不到预期效果,影响提交进度。我的实用建议是:先用指令把大段的理论背景内容改一遍,再用言笔降AI做最后的收尾优化,既能保住原本的格式,又能确保AI率和查重率双双达标。如果想多对比几款工具,笔灵、某降AI、PAPE
DeepSeek润色后的论文如何安排AI率自查?本文围绕单段检测与全文自查,梳理润色后的检查顺序、报告对照和复测安排,帮助作者定位需要进一步调整的内容。
刚进实验室的研一新生最容易陷入迷茫。不知道怎么确定研究方向,看不懂海量外文文献,不会设计合理的实验方案,数据处理和绘图一窍不通,写第一篇学术论文更是无从下手。别慌,亲测这五个工具能帮你快速入门科研,少走至少三年弯路。
2026年知网的AI率检测算法彻底更新了底层逻辑!以前靠同义词替换、中英互译就能蒙混过关,现在人家靠语义识别抓AI痕迹——哪怕你把每个字都改了,只要段落逻辑框架没动,查重报告照样会标红。死磕单个字词根本没用,得从逻辑重构入手才是正道!我花了一周时间测试各种方法,总结出两套靠谱方案:一套是零成本的豆包+Gemini逻辑优化法,适合时间充足的同学;另一套是赶DDL的专业工具急救法,直接花钱换省心。以下
测完这么多工具,最后给大家几条实用的选择方向:追求稳妥与高质量:优先选言笔降AI,语义重构比单纯换词更彻底,还能同步降重,关键售后有保障——7天内不限次数免费重写,AI率没降到20%以下全额退款,完全不用担心踩坑。想找免费方案:动手能力强的可以用DeepSeek(记得搭配精准提示词),也可以试试言笔降AI、Checkbug的免费体验额度。留学生或英文写作需求:优先选QuillBot和ESSAURA
本文围绕deepseek辅助科研主题,指出传统关键词检索精读的科研路径易形成认知天花板,推荐了一套高效科研新路径:以复旦切问学术为起点,通过灵感发现功能获取研究方向、生成可执行研究计划,依托其论文复现功能一键完成算力适配、环境搭建、实验跑通全流程;再用SciSpace批量解构核心论文挖掘共性创新空白,辅以Research Rabbit等工具构建动态学术知识图谱,帮助科研人员建立先见森林后见树木的系
针对研究生读文献易陷入方向模糊、难辨关键的痛点,本文介绍了deepseek科研相关的三类文献筛选工具:通过WisPaper剔除伪关键论文、快速识别仅需了解的背景类文献,聚焦真正有研究推进价值的内容;借助Connected Papers可视化定位研究网络中的核心节点论文;最后用Google Scholar在验证阶段核查论文引用动态与相关质疑,为科研人员提供清晰的文献处理逻辑,助力科研提质增效。
AI 应用监控 = 传统四指标 + AI 专属四指标,模型层比应用层更重要;网关是埋点的最佳位置,所有请求都经过它,指标最全;Prometheus + Grafana 2 小时能跑通,成本几乎为零(都跑在 Flexus 上);告警分级是灵魂:P0 立即、P1 15 分钟、P2 当日、P3 周会,别让"狼来了"毁掉告警;监控是省钱工具:思维链和 Token 成本监控,直接转化为真金白银的节省。AI
<think>我们要求根据内容生成≤150字的文章摘要。内容较长,需提炼核心:Astra对开源模型出的题不是智力benchmark,而是能否从理解世界到构造/操作/验证世界(图形/Agent闭环)。分别提到DeepSeek(推理强需补视觉闭环)、Kimi(Visual Agentic Intelligence)、Qwen(完整生态/本地AI Runtime)。结论:竞争从模型智能转向系
维普官方刚发布了一则重磅通知!2026年2月5日,个人AIGC检测服务完成了全面升级!不少同学还没反应过来,拿着之前准备好的稿子去检测,直接傻了眼——明明内容没改动,AI率却飙升得离谱,找导师询问也得不到明确答案,只能猜测是检测算法收紧了。其实真不是你的论文出了问题,是维普的检测标准彻底更新了!这次升级到底改了啥?看官方说明,核心逻辑特别明确,就是针对市面上的主流大模型而来:一是全面覆盖国内外主流
<think>用户要求根据提供的长文生成一篇不超过150字的摘要。我需要阅读全文并抓住核心要点:作者构建了一个电商竞品分析工具,利用Qwen3.8-Max多模态模型和通义万相生图,上传Excel评论表格后约18秒生成痛点雷达图、晒图视觉洞察、合规文案和主图提示词,成本约0.13元。文章还分享了技术选型、Prompt设计经验和踩坑记录。 摘要需要控制在150字以内,中文。需要涵盖工具功能
以时空节拍旗下时空镜3D数智人交互平台为例,其"智慧大脑"模块采用"大模型+智能体+问答库"三层架构,在DeepSeek等大模型底座之上接入扣子智能体,让数字人既能通过问答库保证专业口径的准确性,又能通过智能体实现任务级的主动执行;再往前一步,还有"多智能体协同"的想象空间:一个数字人前台背后,可以挂着排班调度、知识检索、业务办理等多个后台Agent协作运转,用户面对的始终是一个"人",而复杂度被
一个成熟的 AI 系统,真正难的部分往往不是接入某个模型,而是让不同模型、工具和扩展能力在同一套规则下稳定协作。RelayRouter 的公开页面展示了一种值得研究的思路:通过统一接口、模型目录、能力分类、错误说明、异步任务文档和多语言示例,把复杂的 AI 服务包装成可理解、可迁移的开发者契约。DeepSeek Harness 则以“一切皆插件”为核心架构,由 Cordis 提供支持。两者并非同类
本文针对2026年Q3长文档处理场景,对比分析了5款支持1M上下文的AI模型(DeepSeek-V4-Flash、Kimi-K2.5、GLM-5.1、Qwen3.6-Max-Preview、Claude-Sonnet-4-6)在成本、性能和适用场景上的表现。文章通过实际案例(21万字合同处理)展示了1M上下文直灌相比传统RAG切片方案的成本优势(从50美元降至0.02美元),详细介绍了各模型的定价
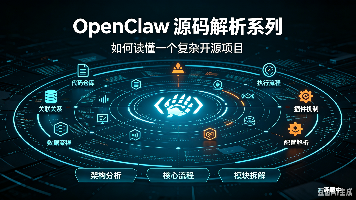
OpenClaw可以形象地理解为一家AI服务公司:Gateway是总机调度中心,负责接收和处理来自微信、Telegram等Channel渠道的消息;Agent是具备不同性格和职责的AI员工,依靠Provider供应商(如OpenAI、DeepSeek等)提供的LLM大脑进行思考;员工通过Skill技能包调用Tool工具完成任务,并借助Memory记忆文件和Session会话记录维持工作连贯性。整个
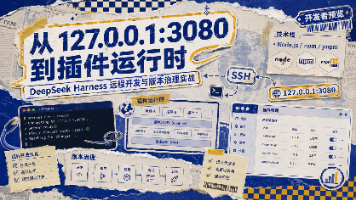
DeepSeek Harness 是由 DeepSeek AI 的 dsh 团队开发的开源代理框架,采用“一切皆插件”的架构,并由 Cordis 提供支持。它可以通过 Node.js 和 npm 快速启动 Web UI,也可以使用 pnpm 从源码构建。本文选择远程开发与工程治理作为主线,解释、SSH 端口转发、--no-open、源码构建产物、插件兼容性和开发者预览版风险之间的关系,同时补充插件
DeepSeek发布首款视觉模型V4-Flash-Vision-Exp,主打"视觉不加价"策略,每张图片处理最高仅0.001元。该模型支持票据OCR、图表理解等场景,API兼容OpenAI,3步即可接入。虽然官方宣传多模态能力接近Opus-4.8,但实际基准测试显示2胜2负。作为实验版本,开发者需注意实际业务测试。此次定价策略显著降低了多模态开发门槛,可能影响行业生态格局。
本文基于2026年7月的实测数据,对比了6个主流视觉基座模型(Qwen3.8-27B本地版、qwen3-vl-32b-thinking、qwen3.5-plus、claude-opus-4-8、kimi-k2.6、ERNIE-4.0-8K)在视觉理解和Tool Calling任务上的表现。测试涵盖300张样图(CT切片、UI截图、发票OCR、菜谱理解、代码截图各60张)和20个Tool Calli
GEO的平台矩阵,不是一个月做完就结束的事情。它是你的品牌在AI时代的”数字分身”——每一个平台,都是你伸向AI的一根触角。你不需要在10个平台都做得完美。你只需要:选对2-3个核心平台持续深耕,同时保持其他平台的最低存在度。百家号+知乎+抖音,是大多数行业的基准配置。把这两个平台做透,豆包和DeepSeek就会开始记住你。然后你再做小红书做口碑,视频号做转化,头条号做覆盖,CSDN做B端背书。三
针对影视写实素材生成场景,本文选取 KREA 2 TURBO、Z-Image-Turbo、Qwen-Image-2512 三款模型,基于同一段民国隐忍痛苦微表情的写实提示词,开展面部精细化表情还原对比评测。测试目标为生成 “强忍悲痛、眼含水光但无泪珠滑落” 的克制类微表情。评测结果表明:KREA 2 TURBO 无法完成目标微表情渲染;Z-Image-Turbo 表情还原效果最优,可较好控制情绪幅
本文介绍了微软 MAF(Microsoft Agent Framework)框架如何适配国产大模型基座(Qwen3-Max、Kimi-K3、MiMo-V2.5、MiniMax-M3、ERNIE-4.0-8K)的实践经验。文章首先分析了MAF作为AutoGen与Semantic Kernel合并产物的技术架构,重点阐述了5个核心对象(Agent、Thread、Tool、Workflow、Proces
2026年AI绘画模型选型完全指南:SDXL/FLUX/SD3.5/Qwen-Image四大主流模型四维度实测对比(显存门槛·画质·速度·商用授权),按4G/6G/8G/12G/16G/24G显存直接对号入座,附用途选型决策树。
【摘要】助研君(gradu.cn)是一款按字数计费的论文降重降AI工具,特别适合处理摘要、结论、致谢等易被AI检测标红的小篇幅内容。这些部分因固定句式、模板化表达或排比结构易触发系统标记,通过分段复制标红内容、选择降AI模式生成改写结果,可低成本精准消红。工具支持保留核心术语和数字,对摘要调整句式顺序、结论补充证据边界、致谢替换真实细节等差异化处理。相比整篇套餐,按需付费模式更经济,尤其适合交稿前
文章摘要 本文详细介绍了如何在CherryStudio中配置Claude MCP中转服务,实现Sonnet/Opus/Haiku模型的稳定工具调用。主要内容包括: 背景:2026年Q3后,Claude模型在代码理解和长文档处理方面变得不可或缺,但官方接口网络不稳定,尤其是工具调用场景。 技术架构: CherryStudio作为本地客户端 MCP协议实现外部工具调用 通过selltoken.top等
Agent 任务可能因为模型超时、进程重启、开发者下班或权限等待而中断。恢复时若只读取最后一条消息,很容易遗漏未完成工具、未写入事件和已经变化的工作区。当前仓库版本是否与中断时一致。是否有工具进程仍在运行或已经产生副作用。最后一个检查点之后有哪些未确认事件。权限租约、密钥和外部服务状态是否仍然有效。上下文策略和插件版本是否发生变化。人工是否修改了任务目标或停止条件。只有这些检查通过,才能从检查点继
本文对比了MCP v0.7和A2A两种AI协议在5大旗舰模型(Claude/Qwen/GLM/Kimi/豆包)上的适配表现。测试显示,MCP v0.7在单工具调用场景下延迟更低(200ms级),而A2A在多Agent协同任务中更具优势但延迟较高(400ms+)。Claude原生支持MCP接入最快(0.5h),其他模型需1-2h;A2A接入工时普遍是MCP的1.5-2倍。作者建议纯工具场景用MCP,
本文对2026年五大主流AI基座模型(Claude、GPT、DeepSeek、Kimi、讯飞星火)在Agent Loop场景下的表现进行了横向对比测试。研究发现,模型性能差异主要体现在协议适配成本、循环收敛能力和价格三个方面:Claude和GPT协议成熟但价格昂贵,DeepSeek性价比最高;讯飞星火适配成本最高且易死循环,Kimi存在长上下文截断问题。文章提出了三层路由策略和熔断机制的生产级解决
dsh-rpg-workstation 是一款为 DeepSeek Harness 打造的 RPG 游戏化插件,将每次完整对话回合转化为经验值,支持等级成长、14 项成就、连击加乘(3/7/30 天分别 ×1.1/×1.25/×1.5)及每日任务(每完成一项 +20 XP)。右下角浮动面板实时展示战绩,包含称号、经验条、签到日历、周报告和成就列表;数据本地持久化(~/.dsh/rpg-data.j
过去Flash的价值主要是快。现在它的角色正在变化。它开始同时承担:推理。代码。工具。长上下文。多模态理解。对于开发者来说,这比“跑分又涨了多少”更值得关注。因为Agent真正需要的,不是每一步都调用最强模型。而是一个足够聪明、足够快、工具完整、成本可控,并且能够稳定跑完几十轮任务的执行引擎。Google于2026年7月21日正式发布Gemini 3.6 Flash GA,模型ID为gemini-
今天的AI热点非常容易让人产生一种错觉。好像每天只要追上最新型号就够了。但真正做平台以后,会发现完全不是这样。模型越强,风险越需要被治理。推理越快,服务等级越需要被调度。模型越多,事实核验和Registry越重要。所以真正成熟的多模型平台,最终竞争的不会只是“接了多少模型”。而是能不能在正确的任务、正确的风险、正确的延迟要求下,调用一个真正存在、真正适合、真正可控的模型。
DeepSeek Harness 的 PTC 模式值得关注,不是因为它让 Agent 变成了一个更复杂的聊天窗口,而是因为它把工具编排显式地放到了程序层。对于稳定的文件筛选、测试汇总和报告整理,这种方式可能减少上下文重复和调用等待;对于不稳定或高风险的任务,它也可能放大一次错误,绕过开发者原本能看到的中间步骤。