GraphRAG 实战:知识图谱+RAG,从单人 Demo 到团队协作的进阶路径
聊《我把GraphRAG接进项目后,先推翻了几个想当然》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
最近 AI 编程工具的风向变了。Codex、Claude Code 这些工具从个人试用走向团队协作,招聘 JD 上也频繁出现"多 Agent 协同""知识管理""可观测性"这些关键词。我看了几份 2026 年的大模型岗位 JD,发现一个有意思的现象:单纯会调 LangChain API 的人已经不再稀缺,真正值钱的是能把 RAG 从 Demo 推到生产环境的人。而 GraphRAG 就是这道坎。
去年我也做过 RAG 项目,效果一直卡在某个瓶颈上。今年把知识图谱接进去之后,情况明显不一样了。今天把这段时间踩的坑和总结的方法论写出来,给同样在走这条路的人参考。
目录
- 传统 RAG 的瓶颈:为什么 Demo 能跑,团队接手就崩
- 知识图谱建模:别一上来就搞复杂,先从核心实体开始
- 实体关系抽取:自动化是关键,别指望人工标注
- 图检索增强:多跳推理才是 GraphRAG 的核心价值
- 评估与优化:别只看准确率,要看业务指标
- 总结:GraphRAG 不是银弹,但有明确的使用场景
传统 RAG 的瓶颈:为什么 Demo 能跑,团队接手就崩
我先说一个真实场景。
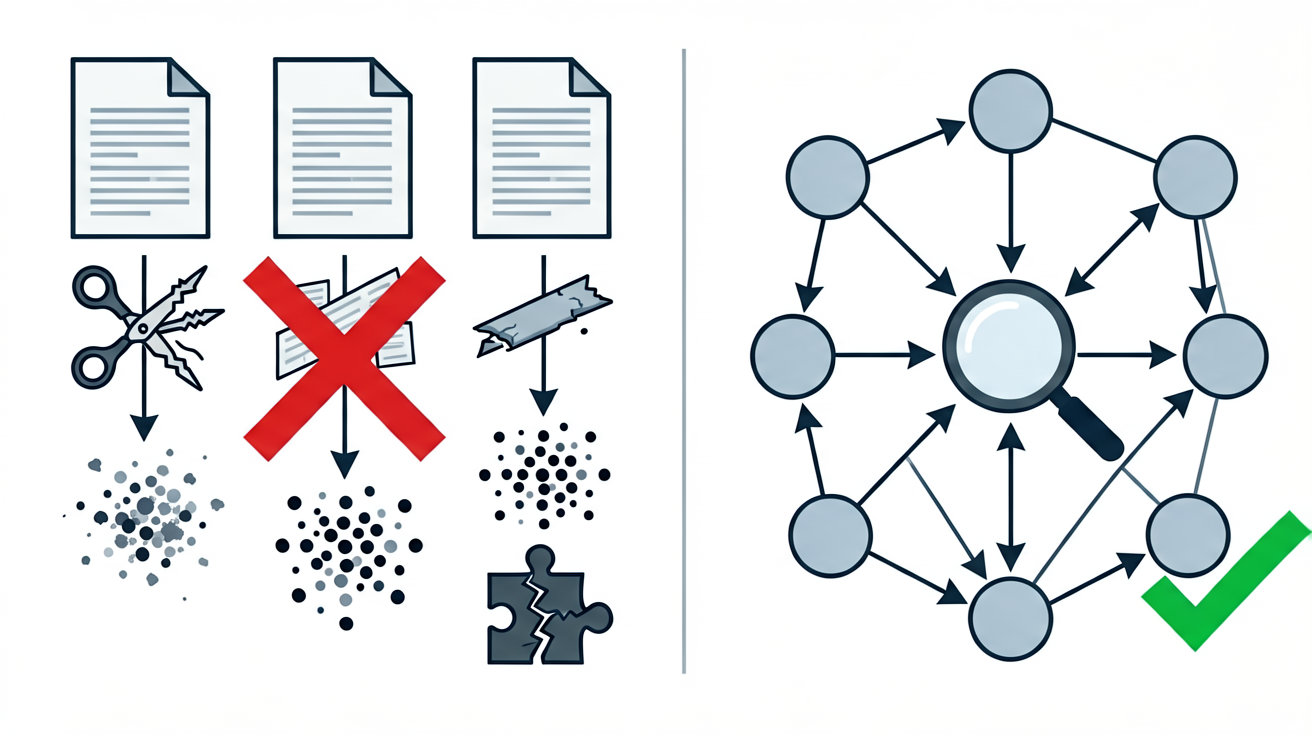
我负责的公司内部知识库项目,用的是传统 RAG:文档切片→向量化→检索→生成。单人 Demo 阶段,效果还不错,准确率 80% 左右。后来团队接手,接入更多业务方,问题就来了。
第一个问题:切片逻辑太粗暴。一段 500 字的文档被切成三段,上下文丢失严重。检索时召回的内容碎片化,模型根本拼不完整。
第二个问题:多跳推理做不了。用户问"A 系统的接口调用 B 系统,B 系统又调用 C 系统,C 系统的负责人是谁",传统 RAG 只能召回包含某个关键词的片段,根本没法做链式推理。
第三个问题:知识更新成本高。文档改了一处,要重新切片、重新向量化,整个索引都要重建。团队协作时,多人同时更新文档,冲突和覆盖问题层出不穷。
这三个问题,本质上是传统 RAG 的"扁平化"缺陷:它只保留了文本的局部信息,丢失了全局结构和关系。
知识图谱建模:别一上来就搞复杂,先从核心实体开始
很多开发者接到 GraphRAG 需求时,第一反应是"我要建一个完整的知识图谱"。这个想法很危险。
我见过太多项目,一开始就设计复杂的本体模型,结果半年过去,图谱还是空的。原因很简单:没有业务驱动,纯技术视角的建模根本推不动。
我的建议是:从核心业务实体出发,先做最小可用版本。
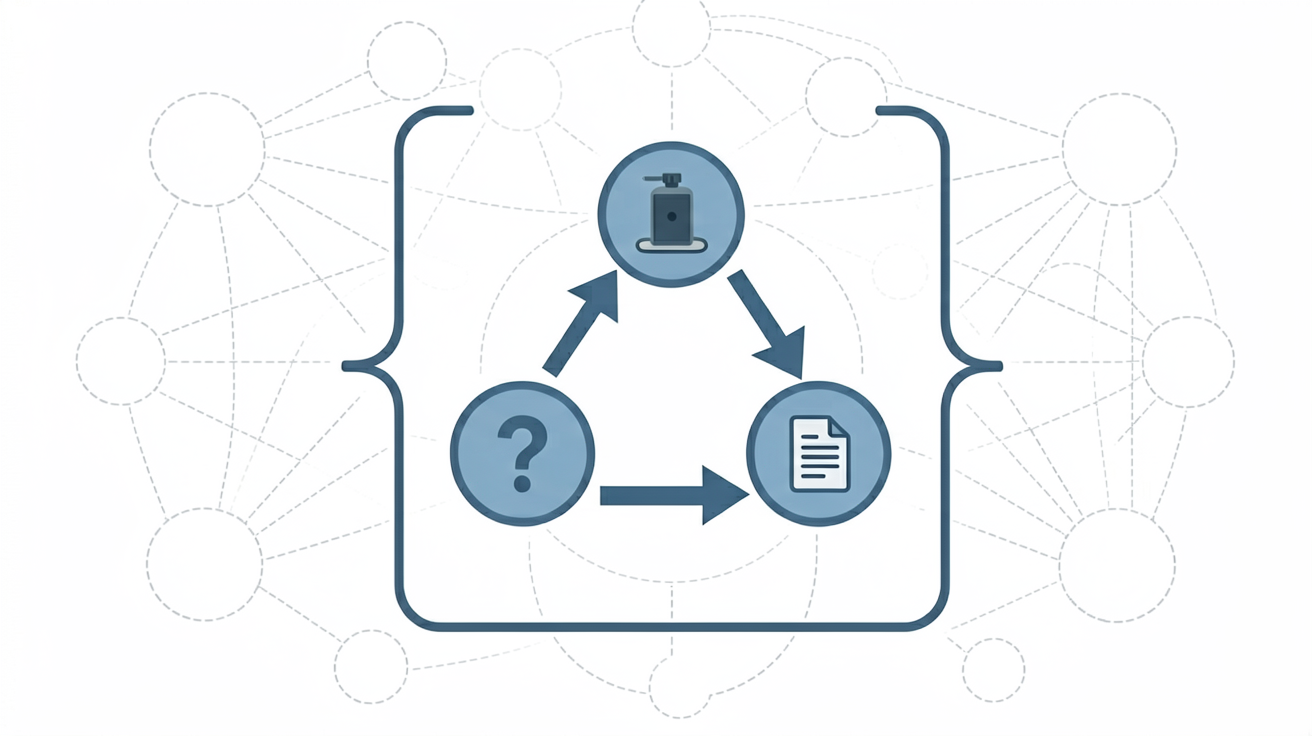
举个例子。我负责的客服知识库项目,核心实体就三个:产品、问题、解决方案。关系也简单:产品-包含-问题,问题-有-解决方案。先建这个骨架,跑通流程,再逐步扩展。
建模时注意几个原则:
第一,实体粒度要适中。太粗(比如"产品")信息量不够,太细(比如"产品A-功能B-参数C")维护成本爆炸。找到那个"足够回答业务问题"的粒度就行。
第二,关系要有业务含义。"相关""关联"这种万能关系不要出现,每段关系都要能回答"为什么这两个东西有关系"。
第三,先跑通再优化。别追求完美的本体设计,先用最简模型把检索链路跑通,再根据实际查询反馈迭代。
实体关系抽取:自动化是关键,别指望人工标注
建好模型之后,下一步是抽取。这是最耗时的环节。
我尝试过几种方案:
第一种是全人工标注。效果最好,但成本太高。一个中型知识库,几万条文档,标注团队要干几个月。
第二种是 LLM 抽取。用 GPT-4 或国产大模型,让模型直接从文本中提取实体和关系。效果不错,但成本不低。按我的项目量,每月要几千块 API 费用。
第三种是混合方案。先用 LLM 做初筛,再用规则做校验,最后人工抽检。这个方案平衡了成本和质量,是我目前用的。
代码层面,我用的是 spaCy 做NER,配合自定义规则做关系抽取。以下是核心逻辑:
import spacy
import json
from typing import List, Dict

nlp = spacy.load("zh_core_web_sm")

# 自定义实体类型
nlp.add_pipe("entity_ruler").add_patterns([
    {"label": "PRODUCT", "pattern": "产品A"},
    {"label": "PRODUCT", "pattern": "产品B"},
    {"label": "ISSUE", "pattern": "登录失败"},
    {"label": "ISSUE", "pattern": "接口超时"},
])

def extract_entities(text: str) -> List[Dict]:
    doc = nlp(text)
    entities = []
    for ent in doc.ents:
        entities.append({
            "text": ent.text,
            "label": ent.label_,
            "start": ent.start_char,
            "end": ent.end_char
        })
    return entities

def extract_relations(entities: List[Dict], text: str) -> List[Dict]:
    relations = []
    # 基于位置的简单关系抽取
    for i, ent1 in enumerate(entities):
        for ent2 in entities[i+1:]:
            if ent1["label"] == "PRODUCT" and ent2["label"] == "ISSUE":
                relations.append({
                    "head": ent1["text"],
                    "rel": "has_issue",
                    "tail": ent2["text"]
                })
    return relations
注意:这段代码只是示意,实际生产环境需要更复杂的抽取逻辑和校验机制。
图检索增强:多跳推理才是 GraphRAG 的核心价值
传统 RAG 的检索是"向量相似度匹配",GraphRAG 的检索是"图遍历+向量检索"的混合。这才是它真正值钱的地方。
举个例子。用户问:"产品A的登录失败问题,解决方案是什么?"
传统 RAG 的做法:把问题向量化,在向量库里找最相似的片段。可能召回包含"登录失败"的文档,但不一定能准确关联到"产品A"。
GraphRAG 的做法:
1. 先从查询中提取实体:"产品A"、"登录失败"
2. 在知识图谱中定位这两个实体
3. 沿关系边遍历,找到"产品A → has_issue → 登录失败"这条路径
4. 从"登录失败"节点出发,找到关联的"解决方案"
5. 把检索到的子图结构化为上下文,送给 LLM 生成答案
这样做的优势很明显:检索结果有结构、有逻辑,不是碎片化的文本片段。模型生成答案时,能利用这些结构信息做推理。
代码层面,我用 NetworkX 做图遍历,配合 Neo4j 做图存储:
import networkx as nx
from neo4j import GraphDatabase

class GraphRetriever:
    def __init__(self, uri, user, password):
        self.driver = GraphDatabase.driver(uri, auth=(user, password))

    def get_subgraph(self, entity_name: str, depth: int = 2) -> nx.Graph:
        """获取实体的子图"""
        with self.driver.session() as session:
            # 查询实体的邻居节点
            result = session.run(
                """
                MATCH (n {name: $name})-[*1..$depth]-(m)
                RETURN n, m
                """,
                name=entity_name,
                depth=depth
            )

            G = nx.Graph()
            for record in result:
                nodes = record["nodes"]
                for i, node in enumerate(nodes):
                    G.add_node(node["name"], label=node["labels"][0])
                if len(nodes) == 2:
                    G.add_edge(nodes[0]["name"], nodes[1]["name"])
            return G

    def close(self):
        self.driver.close()
评估与优化:别只看准确率,要看业务指标
很多项目做完 GraphRAG 之后,说"准确率提升了"。但提升多少?怎么测的?没人说清楚。
我的建议是:建立业务导向的评估体系。
第一,定义评估集。从真实用户查询中选 100-200 个典型案例,标注标准答案。这个集要覆盖常见场景和边界情况。
第二,设计评估维度。不只是准确率,还要看:
- 多跳推理成功率:涉及多跳的问题,答案是否正确
- 检索召回率:相关文档是否被召回
- 生成质量:答案是否准确、完整、可读
- 响应时间:图检索是否引入过多延迟
第三,建立对比基线。传统 RAG 的结果要作为 baseline,GraphRAG 的结果要与之对比。
我做过一个实验。测试集 200 个查询,传统 RAG 准确率 72%,GraphRAG 准确率 85%。多跳推理问题提升最明显,从 45% 提升到 78%。
优化方向:
- 实体链接:提高实体识别准确率
- 图索引:优化图遍历效率
- 提示工程:设计更好的图上下文格式
总结:GraphRAG 不是银弹,但有明确的使用场景
写到这里,我想说清楚几点:
第一,GraphRAG 不是所有 RAG 项目都必须做的。如果你的业务问题简单,传统 RAG 够用,没必要折腾。
第二,GraphRAG 适合多跳推理、关系复杂、知识更新频繁的场景。比如企业知识库、客服系统、技术文档检索。
第三,从 Demo 到生产,最大的挑战不是技术,是团队协作。知识图谱的构建、维护、评估,需要产品、研发、业务多方配合。招聘 JD 上频繁出现的"可观测性""权限管理""团队协作",其实就是这个意思。
第四,学习路径建议:先掌握传统 RAG,再学知识图谱基础,最后做 GraphRAG 实战。别一上来就搞复杂的图模型,基础不牢,地动山摇。
我见过太多项目,一上来就追求"先进"的技术栈,结果 Demo 都跑不通。先把简单的东西做扎实,再逐步升级,这才是靠谱的路径。
GraphRAG 是 RAG 进化的一个重要方向,但它不是终点。随着多 Agent 协同、工具调用、记忆管理等技术的成熟,未来的知识库系统会更智能、更协作。但无论怎么变,解决真实业务问题、满足用户实际需求,始终是技术选型的第一原则。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 12
 0
- 0


 已为社区贡献9条内容

所有评论(0)