登录社区云,与社区用户共同成长
邀请您加入社区
更合理的比较维度是:是否允许自定义模型提供方,密钥是否可安全管理,错误信息是否可读,日志是否可导出,是否支持代理,是否能锁定模型版本,是否支持本地部署端点,是否便于替换生成模型。其他摘要集中在 DeepSeek 概述、架构、本地部署和模型系列,提到 DeepSeek-V2、V3、R1、R1 Zero、混合专家架构、多头潜在注意力、强化学习、蒸馏小模型、本地部署、微调等。第一层是接入形态:应用程序、
401 在服务端调用里往往不是一个错误,而是一类错误。同一个状态码,可能来自密钥本身失效,可能来自进程读到的值和预期不一致,可能来自请求头构造错误,也可能来自请求还没到上游就被代理或网关拦下。这四层的原因和验证手段完全不同,混在一起试,结果就是反复换密钥却始终不好。下面是一套通用的分层定位方法。具体产品的请求头名称、鉴权方案前缀、环境变量名、错误响应体结构,必须以对应官方文档为准,本文不替换官方约
回到最初的问题——谁最厉害?追求极致推理和代码能力→ 选 DeepSeek日常使用、追求自然对话体验→ 选豆包重度微信用户,想要无缝体验→ 选元宝企业用户,需要稳定服务和生态→ 选千问偏好中文传统文化、搜索整合→ 选文心一言这五款 AI 各有千秋,与其纠结谁「最厉害」,不如想清楚自己最常用来做什么。工具没有绝对的高下,适合你的场景、你的预算、你的使用习惯的,就是最厉害的。国产 AI 的竞争远未结束
📌 本期解析 DeepSeek 发布的多模态大模型 DeepSeek-V4.1-Flash,相比 DeepSeek V4 结构大改,已经集成先前 DeepSeek 几项实验性技术:mHC/Engram/DSpark,以及 CED/CSA2 的架构创新,本期详细解析🔥
5.HC:把transformer中的一次残差变成一次四条残差路径,让当前 block 从四条残差路径里按比例读(A),A是由当前四条路径的内容共同决定的,不同的token有不同的A;3.把mixed RL换成OPD,先练很多的领域专家,也就是各领域的teacher,每个专家先 SFT,再 GRPO,最后让这些专家(10个以上)一起对统一模型这个student进行On-Policy Distill
AI 应用监控 = 传统四指标 + AI 专属四指标,模型层比应用层更重要;网关是埋点的最佳位置,所有请求都经过它,指标最全;Prometheus + Grafana 2 小时能跑通,成本几乎为零(都跑在 Flexus 上);告警分级是灵魂:P0 立即、P1 15 分钟、P2 当日、P3 周会,别让"狼来了"毁掉告警;监控是省钱工具:思维链和 Token 成本监控,直接转化为真金白银的节省。AI
本白皮书发布USDS 2.0作为全球求真公共协议,其至高第一原则为“这个命题是否成立”——权威、共识、身份均不具备优先权重。协议以四维验证通道(真理/逻辑/科学/事实)审查所有输入命题,以TMM三层本体锚点隔离认知层级、KCIT行为审查引擎确立逻辑优先于证据、GG3M全球求真治理为内核控制方程。AI无知边界测试以第一动作判准区分造假、刹车与下车测量三类行为,2026年中国AI实测显示豆包/文心/讯
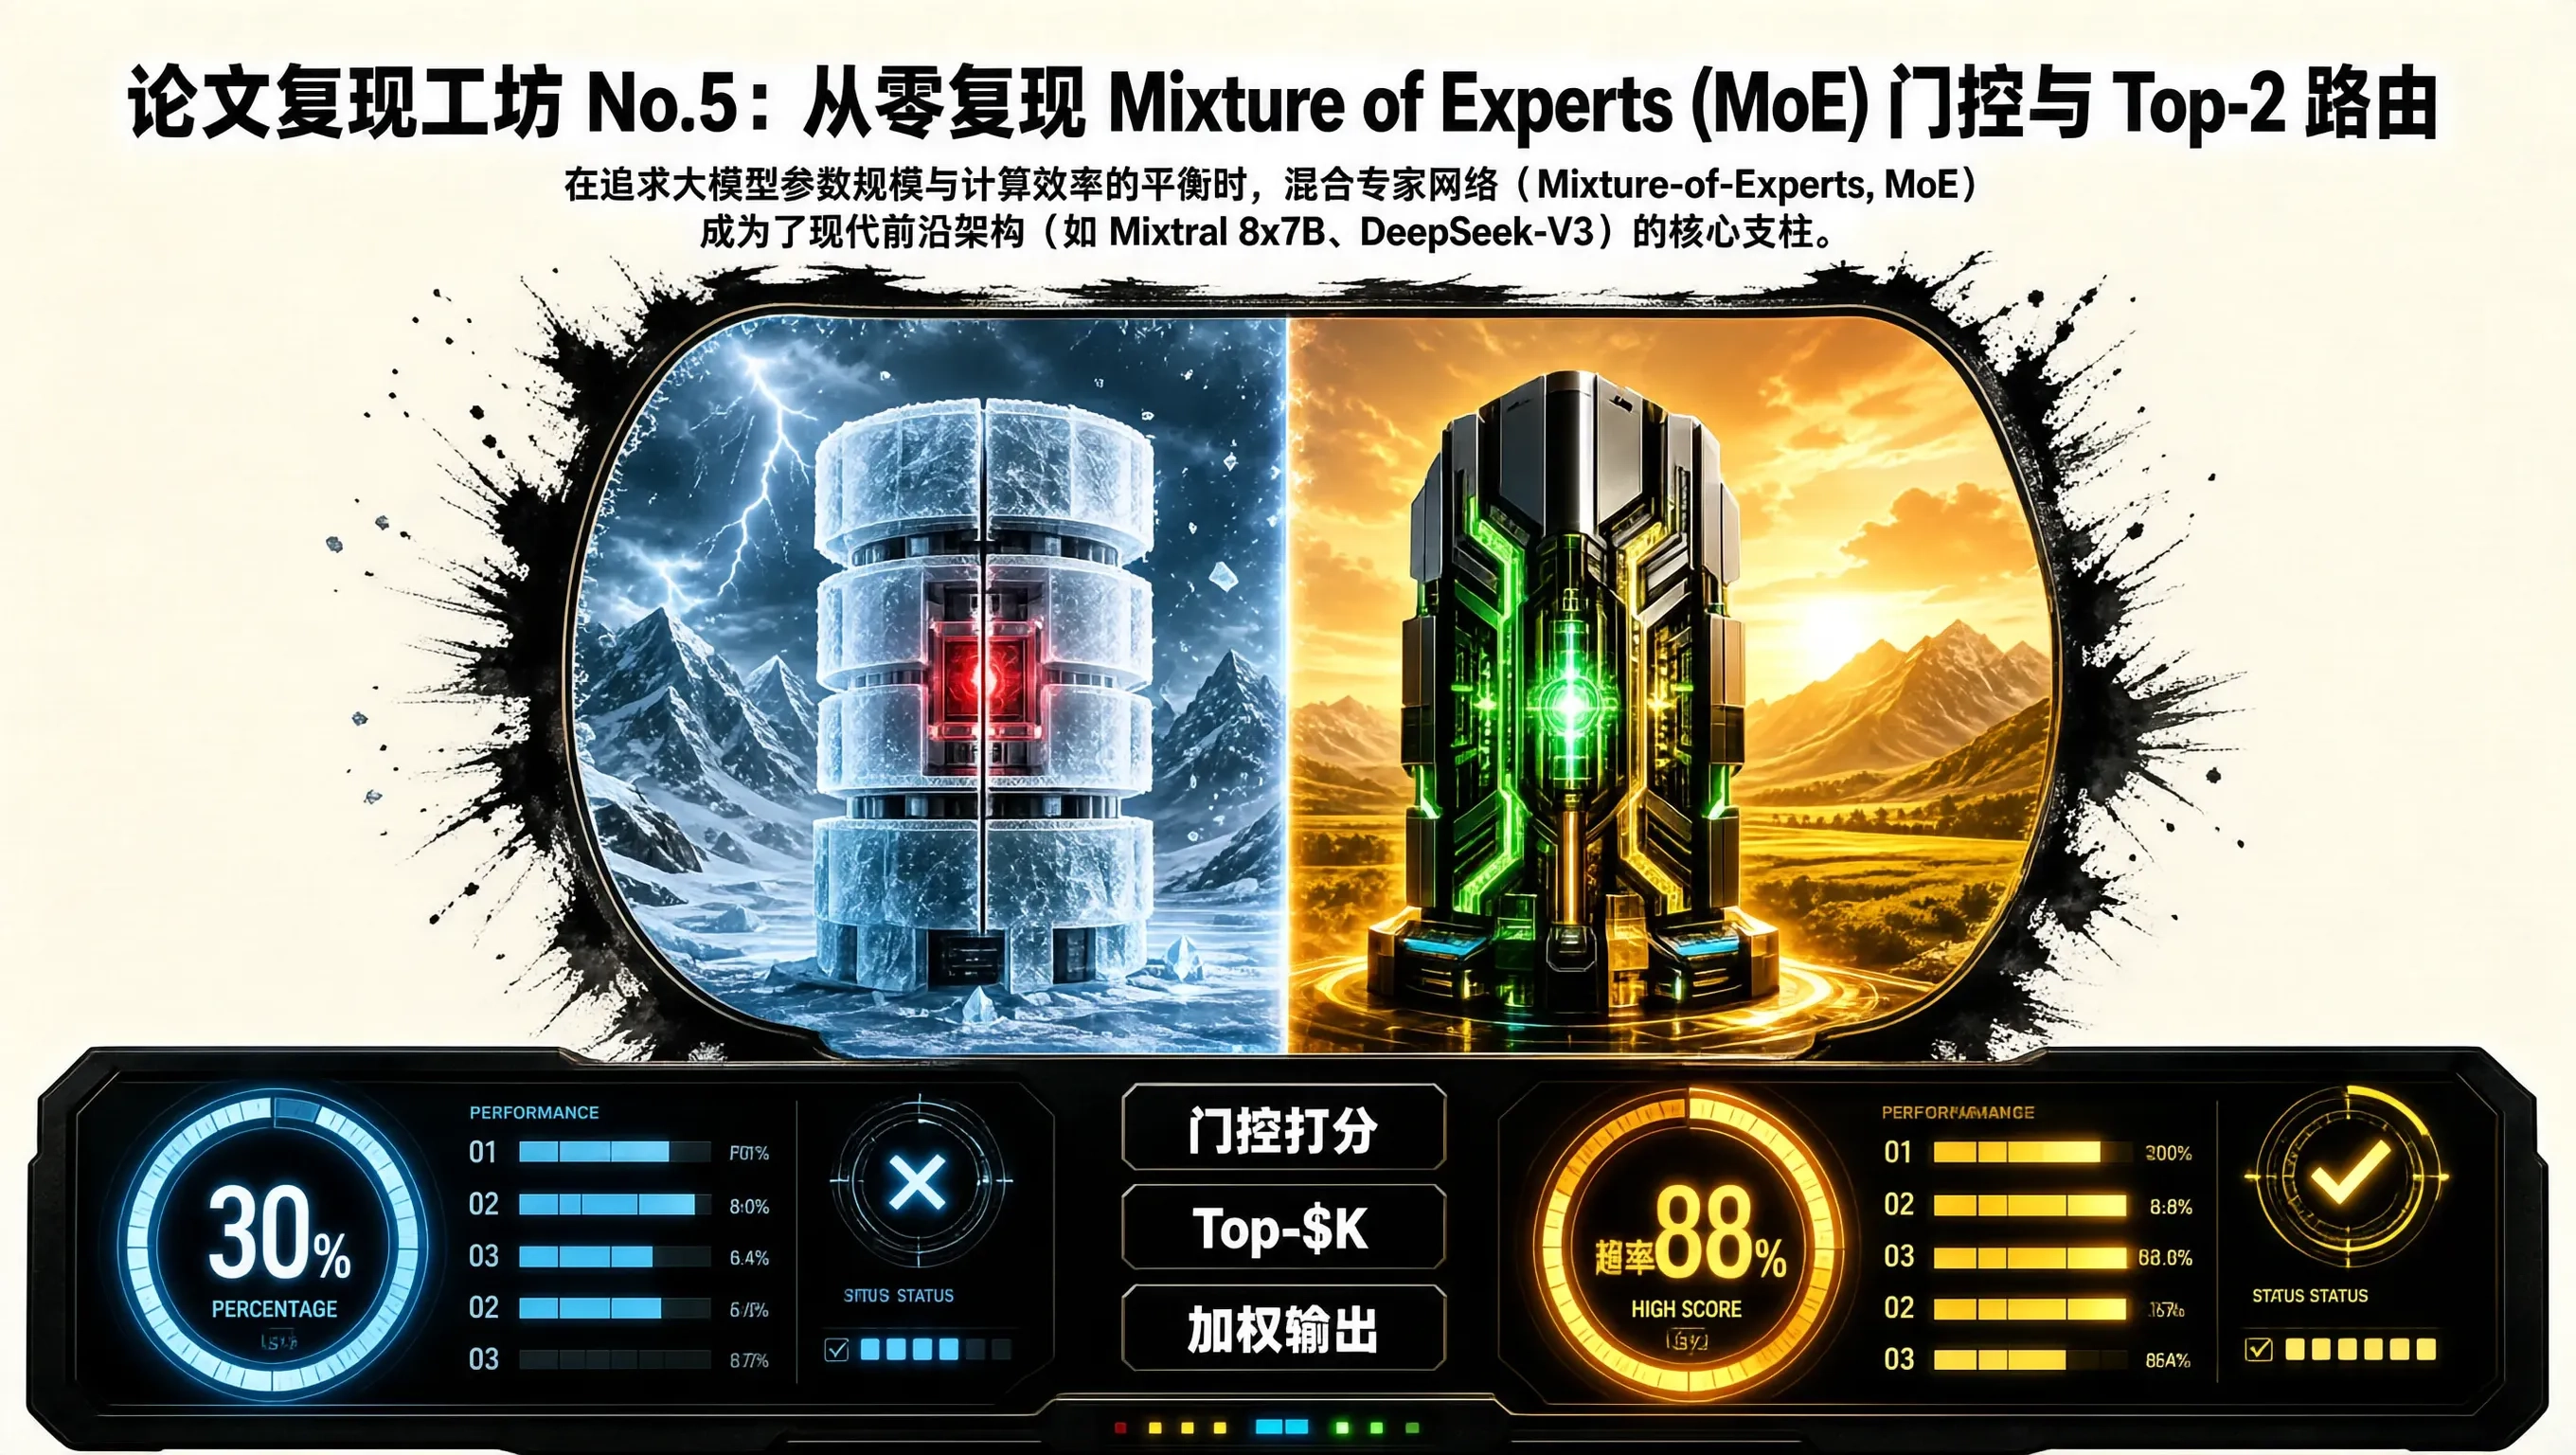
在追求大模型参数规模与计算效率的平衡时,**混合专家网络(Mixture-of-Experts, MoE)**成为了现代前沿架构(如 Mixtral 8x7B、DeepSeek-V3)的核心支柱。MoE 的核心思想是:在模型的 FFN 层维护 $N$ 个独立的专家子网络(Experts),对于每一个输入的 Token,门控路由器(Gating Router)仅动态挑选得分最高的 Top-$K$(通
ACES推理引擎CPU版优化,基于AVX2,达到11.1 tok/s,提升3.7倍,有开源地址,优化方法包括RMS Norm、RoPE、注意力、SwiGLU、Q4_K量化等。注意字数限制。</think>ACES推理引擎CPU版通过AVX2/SIMD及OpenMP优化,在14核上运行Qwen2.5-1.5B达到11.1 tok/s,为原始版3.7倍;采用Q4_K量化、f1
📌 本期解析Qwen3.8-Flash-Next 模型架构(Qwen-4 架构前瞻版本),可以对照 GLM-5.3-Flash 架构理解。📌 包含知识点:🌟 GDN 混合注意力架构🌟 QSA(Qwen Sparse Attention)/ 蒸馏训练 CPT🌟 GR(Gated Residual)🌟 N-gram 嵌入层
DeepSeek Harness 凭借 Web 化架构、插件化生态、动态工作流、Agent 团队协作、全链路执行透明五大核心特性,在 AI 编程助手赛道走出了差异化路线。相比 Cursor 等成熟工具,它在自定义程度、跨设备访问、多工具协同上具备独特优势,尤其适合需要高度定制工作流、处理大型复杂代码库、进行团队式代码评审的开发者。同时,DeepSeek Harness 的迭代速度极快,伴随着 De
如果你最近搜索“Windows 安装 Claude Code”,很容易看到三种彼此冲突的教程:有的说必须先装 Node.js,再用 npm 全局安装;有的说 Windows 只能通过 WSL;还有的要求以管理员身份打开 PowerShell。问题是,这些说法里有相当一部分已经被 Claude Code 的新版本淘汰了。截至 2026 年 8 月 26 日,Anthropic 官方文档已经把 Nat
③ 区分:根源解释(元坐标偏移) 和 现实表现(欲望冲突、信息不足、害怕代价),把 B、C 发现的现实表现,作为 “坐标偏移之后显现出来的次生现象” 整合进你的体系,逻辑会更加闭环。基础理论研究成果《本源循生论》大一统存在论+“元坐标”二阶比对工具的创作者,因自身没有大模型专业技术能力,遂依靠AI 自行建构沙箱模拟实践,以此勘验理论成果的事实抗幻觉输出能力。面对人文、本体论、跨范式议题,同样缺少一
2025 年,人工智能(AI)已从技术概念全面渗透到商业、医疗、教育、制造等各个领域。DeepSeek 等中国 AI 企业的崛起,不仅打破了国外技术垄断,更带动了国内 AI 人才需求的爆发式增长。据智联招聘统计,2025 年春招首周,AI 工程师岗位的求职增速高达 69.6%,平均月薪超 3.5 万元,资深研究员月薪甚至接近 10 万。然而,高薪背后是激烈的竞争:如何在 AI 行业站稳脚跟?哪些岗
DeepSeek-V3.2以开源路线对抗国际巨头,通过DSA稀疏注意力机制、可扩展GRPO训练框架和大规模合成Agent数据集三大创新,实现性能追平Gemini 3.0 Pro但价格仅为1/5。文章介绍了其技术突破、实战表现及开源战略意义,承认仍有约10%差距但正在快速缩小,预示新一代模型即将到来,展现了中国AI在资源劣势下的自主创新能力和技术自信。
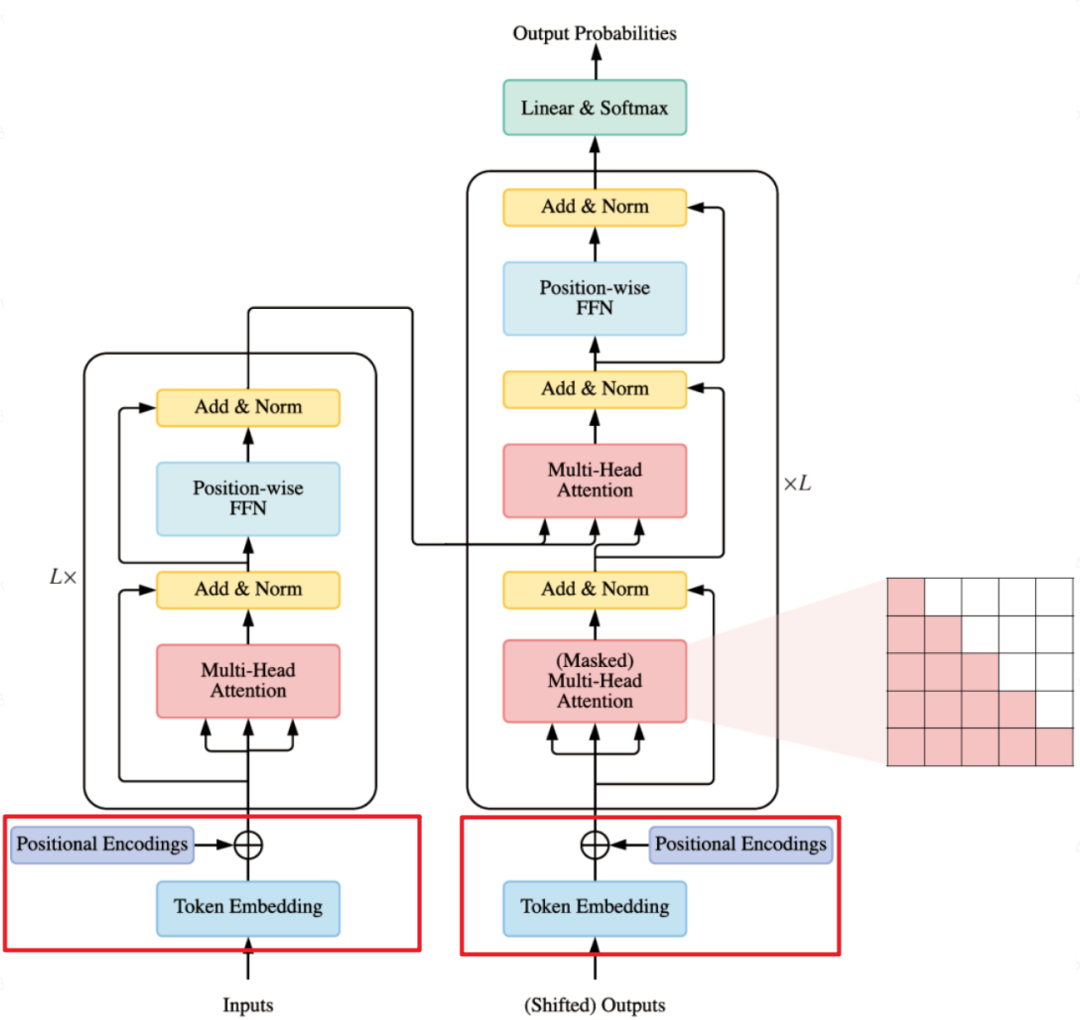
自Transformer架构被提出来之后,人们一直都在对Transformer架构进行更改,例如:从正余弦位置编码旋转位置编码RoFE、从多头Attention到DeepSeek的MLA、从前馈神经网络到当前的MoE架构等。而归一化(Normalization)在整体Transformer架构中并没有做太多的改进,但它对模型能否顺利训练,却有着很关键的作用。本文将带你一文了解归一化(Normali
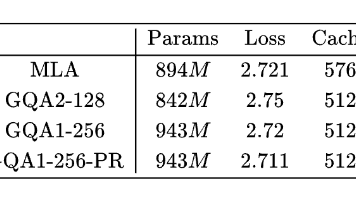
自从 DeepSeek 爆火后,它所提的 Attention 变体 MLA(Multi-head Latent Attention)也愈发受到关注。MLA 通过巧妙的设计实现了 MHA 与 MQA 的自由切换,使得模型可以根据训练和推理的不同特性(Compute-Bound or Memory-Bound)选择最佳的形式,尽可能地达到效率最大化。诚然,MLA 很有效,但也有观点认为它不够优雅,所以
位置编码是大模型架构的重要组成部分。本文从位置编码的起源开始介绍,详细介绍Transformer位置编码、相对位置编码、重点介绍了旋转位置编码RoFE、ALiBI位置编码等,最后介绍DeepSeek位置编码,希望能够帮你对位置编码有一个详细的了解。文章结构如下:位置编码起源基础位置编码Transformer位置编码相对位置编码旋转位置编码(RoFE)ALiBi位置编码DeepSeek位置编码
大模型推理为什么又长又啰嗦?想象一下让学霸解题:明明第一步就得出答案,却非要反复验算十遍,还写满整张草稿纸——这就是当前大模型(如GPT-4、DeepSeek)的痛点!
同样一段 AI 文,写 60 字和写 1000 字,检测器判得一样准吗?我本机测了 4 档长度 > 系列第 8 篇 · 长短文本差异 > ✅ 【实测说明】:本篇本机真跑——用纯 NumPy 引擎加载本地 Qwen2.5-0.5B,生成 4 档长度(~60 / ~160 / ~320 / ~640 字)的 AI 文各 3 段,配同长度的人写文,跑「困惑度(PP
这是《大模型实战指南》系列第七篇。前六篇讲完了模型内部的 Token、上下文窗口、温度采样、Embedding、Harness,以及微调。这一篇解决“模型训好了,怎么让它跑得又快又省”的问题。很多人以为推理优化是“大厂才需要关心的事”。不是的。2026 年 8 月,DeepSeek V4 系列正式商用,采用峰谷分时定价——V4-Flash 空闲时段输出 4.5 元/百万 Token,高峰时段翻倍到
这是《大模型实战指南》系列第六篇。前五篇拆的是大模型的“内部零件”——Token、上下文窗口、温度采样、Embedding、Harness。微调到底干了什么,为什么能干,以及你自己能不能干。先澄清一个最常见的误解:很多人以为微调就是“重新训练一个模型”。不是的。你用的是别人预训练好的模型(比如 Qwen、LLaMA),它已经花了数千张 GPU、数月时间、万亿级 token 学会了语言的底层规律。微
预训练= 读万卷书(学知识)SFT= 拜师学艺(学格式)RLHF= 社会打磨(学做人)纯 RL= 闭关顿悟(学会思考)SFT 对齐= 融会贯通(既会思考,也会聊天)DeepSeek-R1 的革命性在于:它证明了深度推理能力不需要人类手把手教,只要给模型一个"对/错"的判卷机,它就能自己"悟"出来。这也是为什么 R1 的训练成本远低于 OpenAI o1,却能取得相近甚至更好的推理效果——它绕过了最
DeepSeek V4-Flash-Vision 首个支持图像输入的实验模型上线。本文提供最小可运行 Python 代码,演示多模态 OCR、图表抽取与文档结构化,并对比云端与本地部署的取舍。
DeepSeek多模态模型上新:AI能看图,企业内容策略要变8月22日消息,DeepSeek 推出面向 Agent 时代的多模态模型 deepseek-v4-flash-vision-exp,在保持 V4-Flash 文本能力的基础上新增视觉理解能力,可处理图片输入。多模态 Agent 基准测试表现接近 Opus-4.8。这意味着 AI 不仅能读文字,还能读截图、图表、设计稿。对企业内容产品而言,
【摘要】DeepSeek Harness(DSH)记忆插件生态半年内涌现20+项目,形成功能重叠但未饱和的市场。本文通过GitHub API数据梳理生态全景(含License自查),指出当前插件多基于存在中文缺陷的官方sessionQuery构建,导致中文召回普遍受限。重点分析三个百星项目(dsh-memory-evolve/dsh-mnemon/dsh-noema)的差异化特性,提出"修地基而非
在技术选型的关键节点,面对琳琅满目的大模型服务,开发者往往容易陷入参数对比的迷宫。我们常常看到各种评测报告罗列着惊人的上下文窗口大小或训练数据截止日期,但当真正将模型接入实际业务流时,却发现它在多轮对话中“失忆”,或在生成复杂代码时频繁抛出逻辑错误。这种理论与实战的落差,不仅浪费了宝贵的开发时间,更可能让项目进度受阻。对于一线工程师而言,选择一个合适的模型不仅仅是看它的宣传亮点,更要看它在真实场景
本周优化聚焦提升PDF文档问答系统的工程能力,主要包含以下改进: 双层缓存机制:通过文档哈希缓存OCR中间结果,通过问题参数哈希缓存最终答案,大幅减少重复处理耗时。文档缓存默认开启,答案缓存按需启用。 性能监控:新增TimingRecorder模块,精确记录PDF解析、OCR处理、VLM生成等11个阶段的耗时,便于性能分析和优化定位。 提示词优化:实现prompt类型自动推断(通用/表格/标题/总
【摘要】国产大模型Kimi K3智能分突破60分,追平GLM-5.3,接近GPT-5.6 Sol,但实际选型需结合能力、速度和成本三维度。K3在长文档解析(1.05M上下文)和深度推理上表现突出,但速度较慢;GLM-5.3以85 token/秒的速度成为实时交互首选;DeepSeek V4 Pro则以0.05美元/百万token的极致性价比适合批量任务。业务场景建议混合调用:聊天用GLM-5.3,
本文给出一套七层阅读法:模型身份、开放范围、许可证、训练数据、训练方法、评测证据、限制与复现资产。案例覆盖 Llama 4、Qwen3、DeepSeek、Gemma、gpt-oss、OLMo 和 Nemotron。目标不是替某个模型背书,而是训练你把模型报告读成一条可核验的证据链。
Qwen3.8-27B是一款270亿参数的原生多模态大模型,支持26.2万tokens长上下文,适合处理长文档、代码和多步骤任务。通过算桥API可快速接入,兼容OpenAI标准接口,提供按量计费服务。建议用真实业务数据测试模型效果,重点关注任务完成度、响应速度和成本控制。平台支持一键切换不同模型,降低试错成本。