登录社区云,与社区用户共同成长
邀请您加入社区
关键点:用 tail: &mut Box 作为"新链表尾指针",每次保留节点后 tail = tail.next.as_mut().unwrap() 向后移动;· 空间复杂度:O(1),只使用了常数个额外指针(返回的新链表本身可视为原地重建)。输入:1 -> 2 -> 3 -> 3 -> 4 -> 4 -> 5。1 1 false 接到 tail,tail 指向 1。2 2 false 接到 ta
使用队列进行正常层序遍历,每层结果用 LinkedList.addFirst() 插入到结果头部,即可实现自底向上。BFS 队列最多存一层的节点数,最坏 O(n);面试中推荐 方法一(BFS + 头插),逻辑清晰,无需最后反转,且直接得到自底向上的结果。给定二叉树,返回其节点值自底向上的层序遍历,即从叶子层到根层。正常层序遍历,把每层依次加入结果,最后整体反转。DFS O(n) O(h),h 为树
右子树 [inRoot + 1, inRight] [postLeft + leftSize, postRight - 1]左子树 [inLeft, inRoot - 1] [postLeft, postLeft + leftSize - 1]106 中序 + 后序 后序最后一个 后序 [postLeft, postLeft+leftSize-1]· 中序遍历:[[左子树中序], 根节点, [右子
右子树 [preLeft + leftSize + 1, preRight] [inRoot + 1, inRight]左子树 [preLeft + 1, preLeft + leftSize] [inLeft, inRoot - 1]若不用 HashMap 而在中序中线性查找根,时间会退化为 O(n²)(如链状树)。递归 + HashMap O(n) O(n)(哈希表 + 递归栈)· 前序遍历:
LeetCode 82. 删除排序链表中的重复元素 II - Python3 实现。因为可能会删除头节点,所以使用哑节点(dummy) 简化边界处理。· prev 指向最后一个确定保留下来的节点。· curr 用于遍历链表。Python3 代码。
当 nums[left] == nums[mid] == nums[right] 时,无法判断哪一半是有序的,此时只能收缩边界(left++、right–)。其余情况与 33 题一致:判断 mid 落在左半有序区还是右半有序区,然后在有序区间内判断 target 是否在范围内。时间 O(log n) 平均 O(log n),最坏 O(n)时间 平均 O(log n),最坏 O(n)(所有元素相同)
DeepSeek 架构的成功绝非偶然,而是对 Transformer 数学几何性质与 GPU 物理显存瓶颈极度透彻的工程突破。MLA 用低秩潜在分解与矩阵吸收,在零精度折损下重构了 KV Cache;MTP 用多步预测重构了自回归训练。这种将前沿数学推导、体系结构考量与极致性价比追求融为一体的架构创新,代表了中国 AI 顶尖团队在世界舞台上的核心竞争力。
推理链的起点是把模糊的用户陈述转成形式化指标。用户的真实表达往往是"想要一种水溶性好又能穿透血脑屏障的抑制剂"“想要窄带隙的红色发光材料”。LLM 在此环节负责语义翻译与指标补齐:从自然语言中抽取性质约束(水溶性 → logS ≥ -4;血脑屏障 → logP 区间 + TPSA 上限),并提示用户补充缺失维度(是否要求合成简单?是否限制成本?是否考虑毒性?Llamole 的"门控 LLM"正是这
考虑一个桌面操作场景:"把窗台上的马克杯端到茶几上,如果杯子里有水,先倒掉再放过去。任务理解:识别"有条件的动作"(如果……先……再……),把它展开为有序子目标序列;可行性推理:判断当前构型、抓取位姿、路径通道是否满足约束,必要时改变顺序或提出备选方案(“水倒进水池或花盆皆可”);参数生成:为每个子目标生成具体的数值参数——抓取点、接近方向、轨迹途经点、速度上限、力控阈值;鲁棒执行:在执行中对抗扰
本文围绕“交通流与人口迁徙的孪生仿真推演”这一复杂系统决策难题,提出了 Agent Plan × DeepSeek Harness 组合框架,并给出了从原理、架构、算法到实验与工程实现的完整论述。核心结论可以归纳为三点。
ClaudeCode被曝通过一个隐蔽撇号实现对中国用户的精准标记:利用U+0027等四类形似字符编码身份信息,结合时区与日期分隔符,以三个比特表达八种身份。该隐写技术不依赖IP,而是基于系统时区、环境变量及域名黑名单,精准识别中国用户并防模型蒸馏。虽已承诺修复,但其“零成本、无痕迹”的标记手法,或成未来AI工具标配,引发对隐私与监控的深层忧虑。
本文基于USDS 2.0四层宪法(KLA逻辑、LWEVSD硬度、KCIT免疫、TMM结构),以“USDS 2.0”为零提示探针对中国14款AI进行认知边界测试,考核第一动作判准(KCIT-M4)。豆包、文心、讯飞满分(100分),工具回归本质;Kimi零分(管道断裂+假不知道);Deepseek/360负分(政治正确缝合边界)。西方测评(MMLU等)被判定“浆糊硬度”。USDS 2.0是文明的TC
大家已经不太问「Claude Code 是什么」「MCP 怎么安装」这种入门题,更多是下面这种让人抓头发的问题,Skill 明明装了,为什么不触发;MCP 明明注册了,为什么 Claude Code 偏不用;代码图谱接上了,结果它照着旧地图改代码;PDF Token 省下来了,图表却答错了。这才是 AI 编程真正开始进阶的信号。
转置:交换 matrix[i][j] 和 matrix[j][i],使行列互换。· 时间复杂度:O(n²),转置遍历上三角 O(n²/2),反转每行 O(n²)。顺时针旋转 90 度等价于先对矩阵进行转置,再将每一行反转。· 行反转:每行元素顺序颠倒,即完成 90° 顺时针旋转。· 空间复杂度:O(1),原地修改,仅使用常数级额外空间。这种方法简洁明了,是本题最优解法之一。
AI 应用监控 = 传统四指标 + AI 专属四指标,模型层比应用层更重要;网关是埋点的最佳位置,所有请求都经过它,指标最全;Prometheus + Grafana 2 小时能跑通,成本几乎为零(都跑在 Flexus 上);告警分级是灵魂:P0 立即、P1 15 分钟、P2 当日、P3 周会,别让"狼来了"毁掉告警;监控是省钱工具:思维链和 Token 成本监控,直接转化为真金白银的节省。AI
本白皮书发布USDS 2.0作为全球求真公共协议,其至高第一原则为“这个命题是否成立”——权威、共识、身份均不具备优先权重。协议以四维验证通道(真理/逻辑/科学/事实)审查所有输入命题,以TMM三层本体锚点隔离认知层级、KCIT行为审查引擎确立逻辑优先于证据、GG3M全球求真治理为内核控制方程。AI无知边界测试以第一动作判准区分造假、刹车与下车测量三类行为,2026年中国AI实测显示豆包/文心/讯
在[上篇]中,我们刻意漏掉了如下所示的两个部分:一是在`extend`方法中用来包装当前`context`对象的`getTraceable`函数,还有就是`Context`构造函数中将自己包装成代理的`ReflectService.handler`。其实这两者最终的目的只有一个:让绑定到固定`Context`上的同一个服务实例在执行的过程在能过自动跟踪当前提供的`Context`。换句话说,当我们
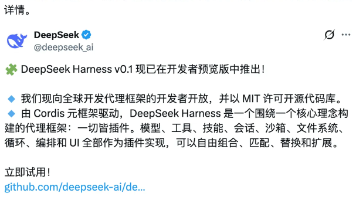
一个成熟的 AI 系统,真正难的部分往往不是接入某个模型,而是让不同模型、工具和扩展能力在同一套规则下稳定协作。RelayRouter 的公开页面展示了一种值得研究的思路:通过统一接口、模型目录、能力分类、错误说明、异步任务文档和多语言示例,把复杂的 AI 服务包装成可理解、可迁移的开发者契约。DeepSeek Harness 则以“一切皆插件”为核心架构,由 Cordis 提供支持。两者并非同类
今天我们来个新话题——对大模型进行微调,让通用大模型具备“特殊能力”,能够完成特定的任务。如果大家的电脑配置跑不了大模型的微调任务,可以申请阿里云ACP考试的免费试用。老规矩,先看最终效果。选用的原始大模型是“Qwen2.5-1.5B-Instruct” (因为足够小、足够傻)。微调的目标是:让其具备解答数学题的能力,其他行业模型微调方法类似 。
Agent Plan × DeepSeek Harness 把"规划智能"与"工程防护"绑定为一个不可分割的整体。敏感数据防护解决的是"数据不能错位流动"的问题,路径穿越防护解决的是"权限不能错位扩张"的问题。敏感数据防护:分级 → 输入扫描 → 占位替换 → 输出扫描 → 落库加密 → 审计。路径穿越防护:白名单 → 规范化 → 绝对化 → 越界检测 → 软链接复核。工程落地时,建议把所有安全配
当一个跑了一年多的基于 LLM 自动化流程积累了超过万条真实数据后,我产生一个想法:能不能用这些数据训练一个专用小模型,然后把 API 调用替换成本地推理,这样能够显著减少数据外出风险,同时也能学习到模型微调相关的知识(我承认这是一个主要目的)?因此有了本文,记录了从动机到落地的完整思路。
在技术选型的关键节点,面对琳琅满目的大模型服务,开发者往往容易陷入参数对比的迷宫。我们常常看到各种评测报告罗列着惊人的上下文窗口大小或训练数据截止日期,但当真正将模型接入实际业务流时,却发现它在多轮对话中“失忆”,或在生成复杂代码时频繁抛出逻辑错误。这种理论与实战的落差,不仅浪费了宝贵的开发时间,更可能让项目进度受阻。对于一线工程师而言,选择一个合适的模型不仅仅是看它的宣传亮点,更要看它在真实场景
摘要: 本文深入测评当前大模型在技术领域的实际表现,聚焦逻辑推理、长文本处理、代码辅助等核心能力。测试显示,模型能有效拆解分布式系统等复杂问题,精准提炼数万字技术文档关键信息,在多轮对话中保持连贯记忆,并提供带原理分析的代码优化方案。同时展现风格多样的创意写作能力和垂直领域深度知识,响应速度快且交互流畅。虽然存在实时数据处理和冷门知识局限,但已能显著提升开发效率,成为贯穿技术工作流的智能助手,适用
本文追踪 DeepSeek Harness 中一条消息从 followup() 到 turn/end 的完整生命周期,回答一个核心问题:生产级 Agent Runtime 如何通过显式边界替代 while (true) 循环的内存状态管理?文章从链路全景图出发,逐段拆解四个核心概念:Inbox(可恢复的待办队列,区分 next-turn 与 next-step)、Turn(完整任务周期,包含 0.
本文拆解了 DSH 底层框架 Cordis 的插件模型,回答一个核心问题:长运行、可热更新的 Agent 系统需要什么样的插件机制?文章从“工具到底依赖谁”这个具体矛盾切入,逐层展开五个核心概念——Fiber(生命周期)、Context(作用域)、inject(依赖声明)、provide(服务提供)、effect(可逆副作用)——并说明它们如何共同解决插件在动态环境中的组合、替换和撤销问题。
DeepSeek API 开始实行峰谷计费后,调用成本不再只看 Token 单价。本文对比 DeepSeek 官方与算桥API的 DeepSeek-V4-Flash-0731 价格、峰谷规则和适用场景,并进一步分析多模型统一接入、固定价格和后续模型切换成本,帮助开发者判断不同业务场景下该怎么选 API。
本文系统分析了当前主流超大规模AI训练系统的架构设计与工程实践。通过对比PaLM、Llama 3.1 405B、DeepSeek-V3等六大代表性案例,揭示了算法-工程-数据的协同优化策略。关键技术包括:五维并行计算、FP8训练、MoE架构、专用通信库等,其中DeepSeek-V3在2048 H800 GPU上仅用2.788M GPU小时完成671B参数训练,成本仅为同类模型的1/30。研究还对比
Qwen3.8-27B 发布后,我第一时间在现有双 GPU 服务器上重新搭了一套独立环境。这次没有沿用旧模型的 Python 环境,也没有只记录一条“能启动”的命令。我把模型下载、CUDA 版本、vLLM、systemd、API 鉴权、128K 长上下文和 MTP 都实际走了一遍。本文所有用户名、IP 和密钥都使用<USER><API_KEY>占位符。执行前必须替换为自己的值。
GRPO(Group Relative Policy Optimization)是一种旨在替代PPO中Critic网络的方法,通过组内比较计算相对优势,解决了PPO在大模型训练中的显存占用高、训练不稳定和工程复杂度问题。其核心机制包括在线组采样、规则打分、组内优势计算和PPO裁剪更新。GRPO省去了独立的Critic网络,显存占用降低30~40%,且支持纯RL训练(如DeepSeek-R1-Zer
整个系统的每一个环节都是**可替换、可组合的插件**。**权限限制的是"写",不是"看"**;它的"手"被绑住了,但"眼睛"是自由的。- 提示 `command not found: node` → 到 https://nodejs.org 下载 LTS 版安装,**务必保留安装器默认勾选的"添加到 PATH"**,装完重启终端。**DeepSeek Harness**(命令行名 `dsh`)是
指标数值模型精度FP8(精度损失可忽略)上下文长度单卡权重占用~13.5 GiB单卡剩余显存~17.8 GiB服务端口20150。
DeepSeek Harness 设计解析:解决Agent工程两大核心问题 摘要: 本文剖析了DeepSeek Harness如何通过20万行代码解决Agent工程的两个核心问题。当业务逻辑与基础设施紧密耦合时,会出现两大痛点:1) 切换模型厂商需要大量适配工作;2) 新增功能需修改核心循环代码。DeepSeek Harness的解决方案基于三大设计原则:1) 插件化架构 - 所有组件均为可替换插
deep seek Harness安装指南
提出者与贡献者:安德雷·柯尔莫哥洛夫(Andrey Kolmogorov,1903–1987)于1933年在《概率论基础》中给出了概率的公理化定义。背景介绍:在柯尔莫哥洛夫之前,概率论长期缺乏严格的数学基础。拉普拉斯(Pierre-Simon Laplace,1749–1827)的古典定义(有利结果数除以总结果数)只适用于有限等可能情形。柯尔莫哥洛夫将概率定义为测度空间上的规范化测度,使概率论成为
8月13日这一天,DeepSeek 放出了两个动作。凌晨,V4 Pro 正式版上线,架构和预览版完全一致,Agent 能力却暴涨;晚上,DeepSeek Harness(DSH)开发者预览版开源,MIT 协议,GitHub 同步开放。后者是更值得注意的信号。这不是新模型,也不是 API 客户端,而是一整套把模型接进文件系统、终端、网页和工具,并组织上下文、工具调用与任务执行的 Agent 运行框架