DeepSeek V4.1 缓存实测:命中省 50 倍
同一份输入,缓存命中付 0.02 元,未命中付 1 元。50 倍的价差,是理解「中国模型调用量连续 20 周超过美国」最直接的一把尺子。
先摆数据。OpenRouter 统计的 9 月 7 日至 13 日一周里,全球总调用 127 万亿 Token、环比增长 10.43%,其中中国模型 61.17 万亿(+7.85%)、美国模型 21.76 万亿(+31.56%),中国模型周调用量已连续 20 周高于美国;TOP5 里有四款是中国模型(来源:OpenRouter 公开榜单与媒体转述,2026-09)。国家数据局的另一组口径是,2026 年 6 月我国日均 Token 调用量已接近 175 万亿(来源:国家数据局公开披露口径,2026-09)。两组数字来自互相独立的渠道,可交叉验证口径方向一致。
本文不谈份额。我想算清楚一件更具体的事:这个调用量到底便宜在哪里,以及便宜的部分能不能被工程手段放大。
一、先把价目表翻译成「一次调用要付多少钱」
标价给的是三个单价,账单结算的却是有效 token。这两者之间差着一个命中率。
以 DeepSeek V4.1 Flash 的公开定价为例(每百万 Token):空闲时段缓存命中输入 0.02 元、未命中输入 1 元、输出 4 元;高峰时段为 0.04 / 2 / 8 元。相比上一代 V4 Flash,缓存命中输入下降约 60%、未命中输入下降约 33.3%、输出下降约 11.1%(来源:厂商定价页与公开报道,2026-09)。官方同时披露,V4.1 Flash 上线 48 小时消耗约 4.8 万亿 token、缓存命中率 90%(来源:厂商披露口径,2026-09)。
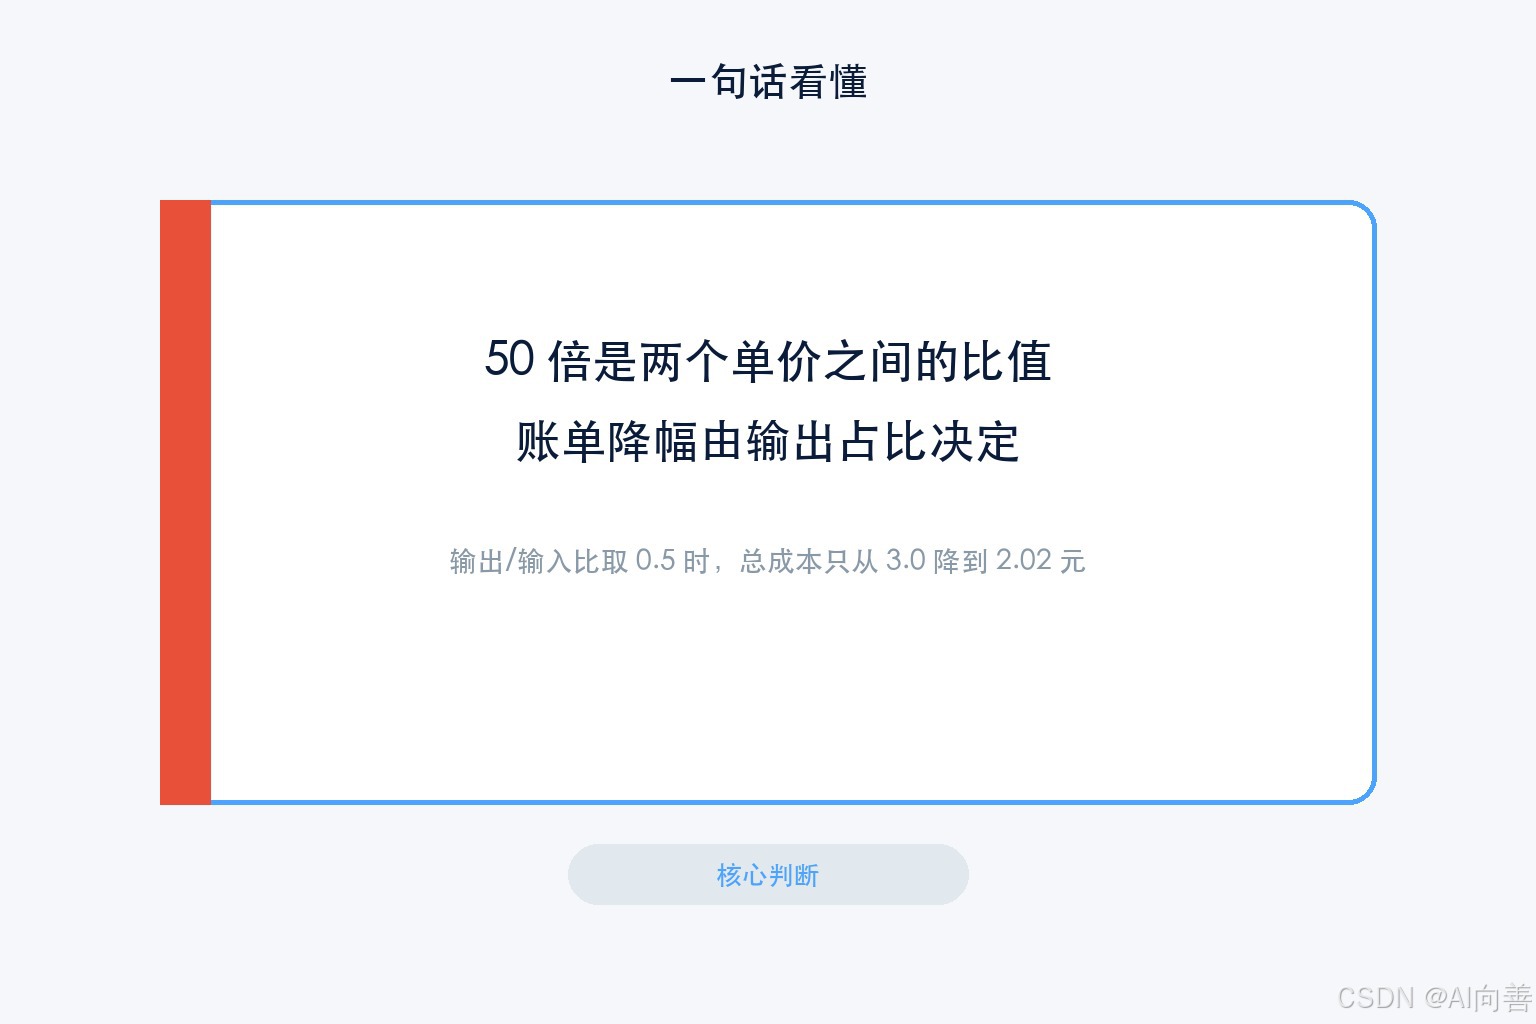
先把最容易误读的一点说清楚:50 倍是两个单价之间的比值,不是你账单会降 50 倍。 账单里还有输出项,而输出项没有缓存这一说。
二、缓存能省的只有输入项,这是个硬边界
下面这段输出是脚本实跑的结果。参数:命中价 0.02、未命中价 1、输出价 4,输出/输入比取 0.5,命中率 90%。
命中率 90%|输出/输入 = 0.5
  实际成本:输入 0.1180 + 输出 2.0000 = 2.1180 元 / 百万输入 token
  单价差:50 倍(未命中 / 命中)

成本曲线(命中率 → 总成本):
  0%    3.0000  ████████████
  10%    2.9020  ███████████
  30%    2.7060  ██████████
  50%    2.5100  ██████████
  70%    2.3140  █████████
  90%    2.1180  ████████
  100%    2.0200  ████████

阈值:
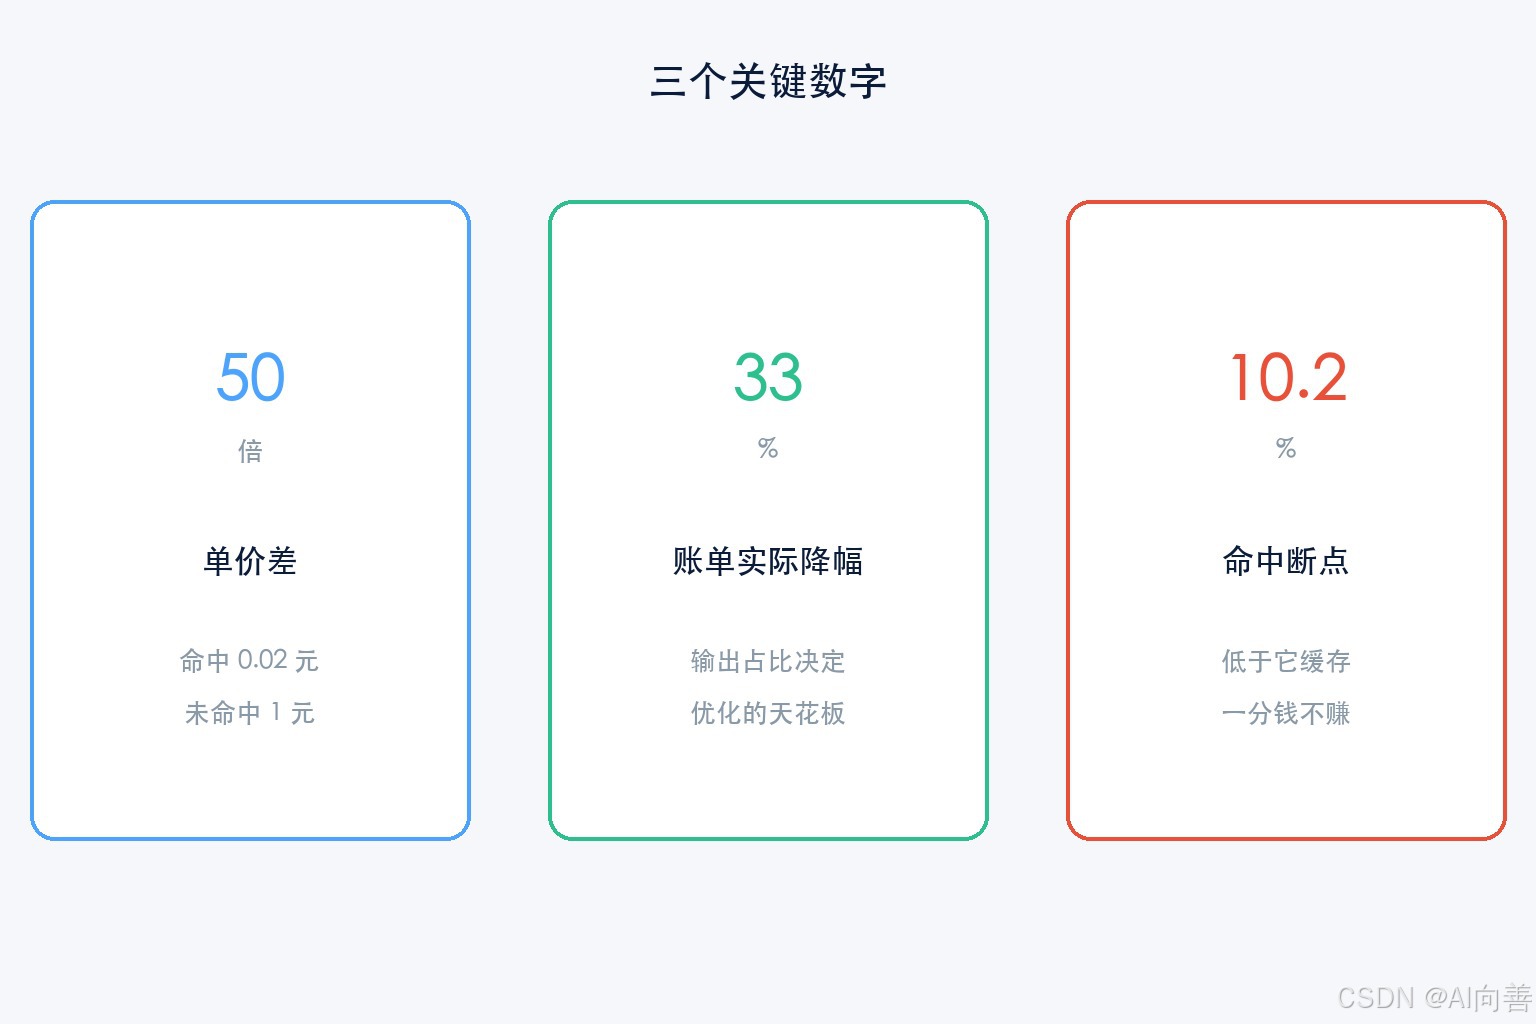
   {"worthwhile": true, "break_even": 0.102, "margin": 0.798, "note": "命中率需高于 10.20% 才划算"}
   {"idle_total": 2.118, "peak_total": 4.236, "saving": 2.118, "saving_ratio": 0.5, "note": "改期的收益要与「等待成本」比较后再决定"}
请重点看两行之间的落差:命中率从 0% 拉到 100%,输入项从 1.0 元降到 0.02 元,降了 98%;但因为输出项按 2.0 元固定计费,总成本只从 3.0 元降到 2.02 元,降幅约 33%。
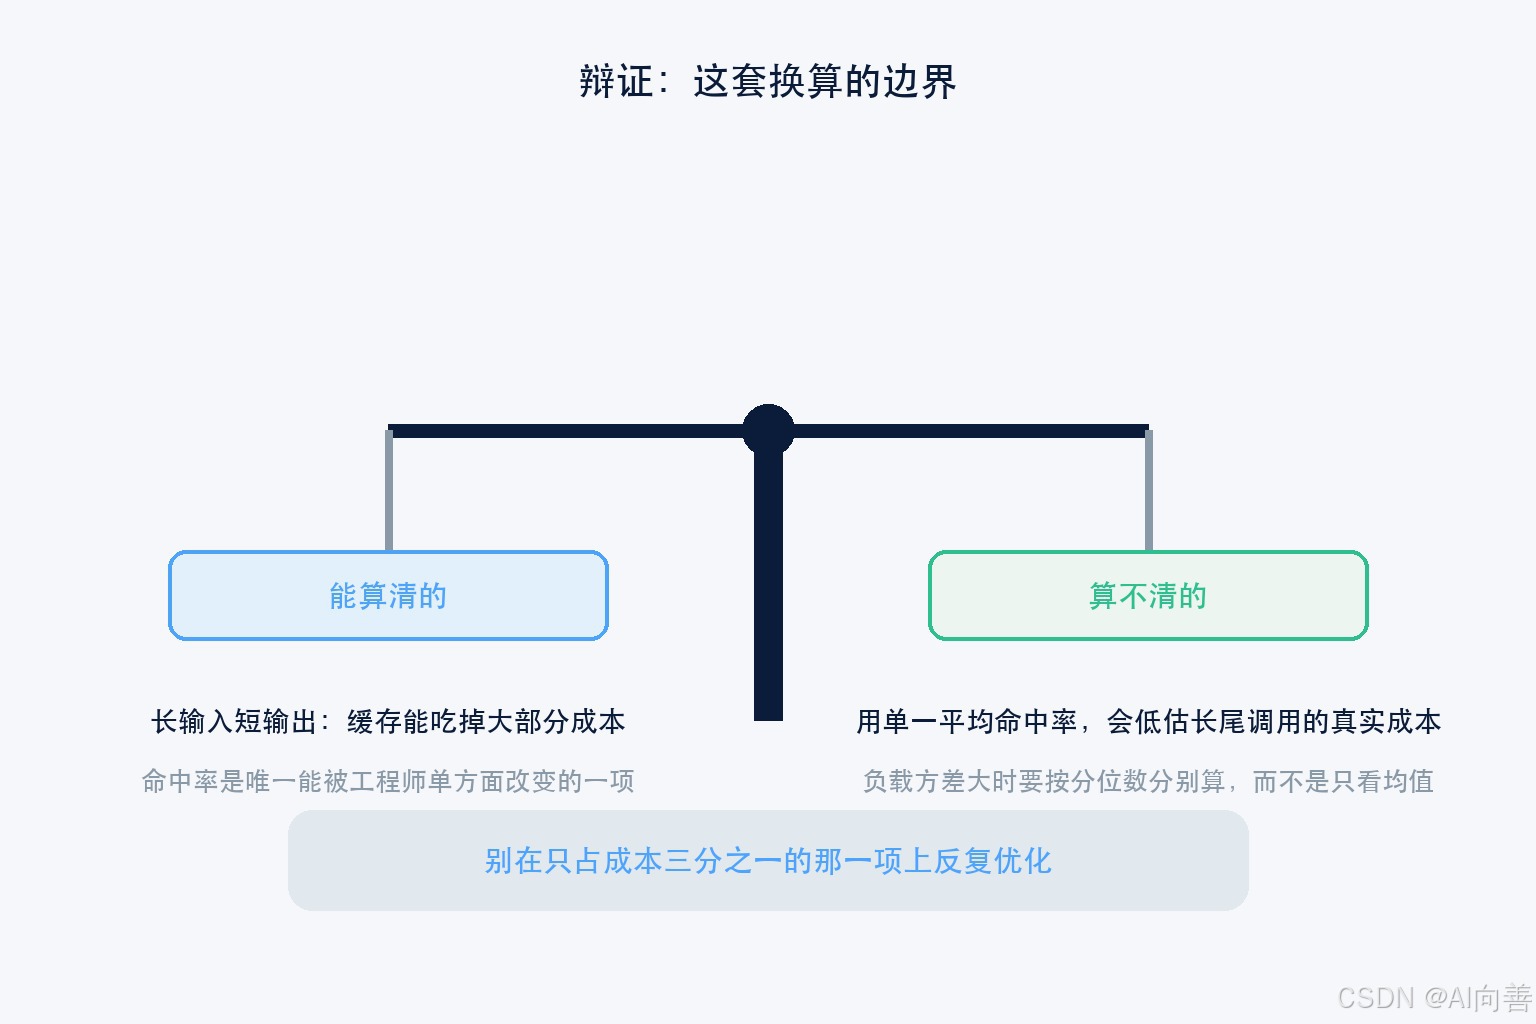
这就是全文最重要的一条工程结论:缓存优化有一个天花板,天花板由输出占比决定。 举个例子,如果你的负载是「长输入 + 短输出」(比如文档摘要、批量分类),缓存能吃掉大部分成本;如果是「短输入 + 长输出」(比如生成长文、代码补全),缓存优化做完之后账单依然主要压在输出项上。
所以接下来该看的不是「还能不能更便宜命中」,而是输出项能否被别的手段压下来。这是我把它写成脚本而不是写进 PPT 的原因。
三、三个可执行阈值
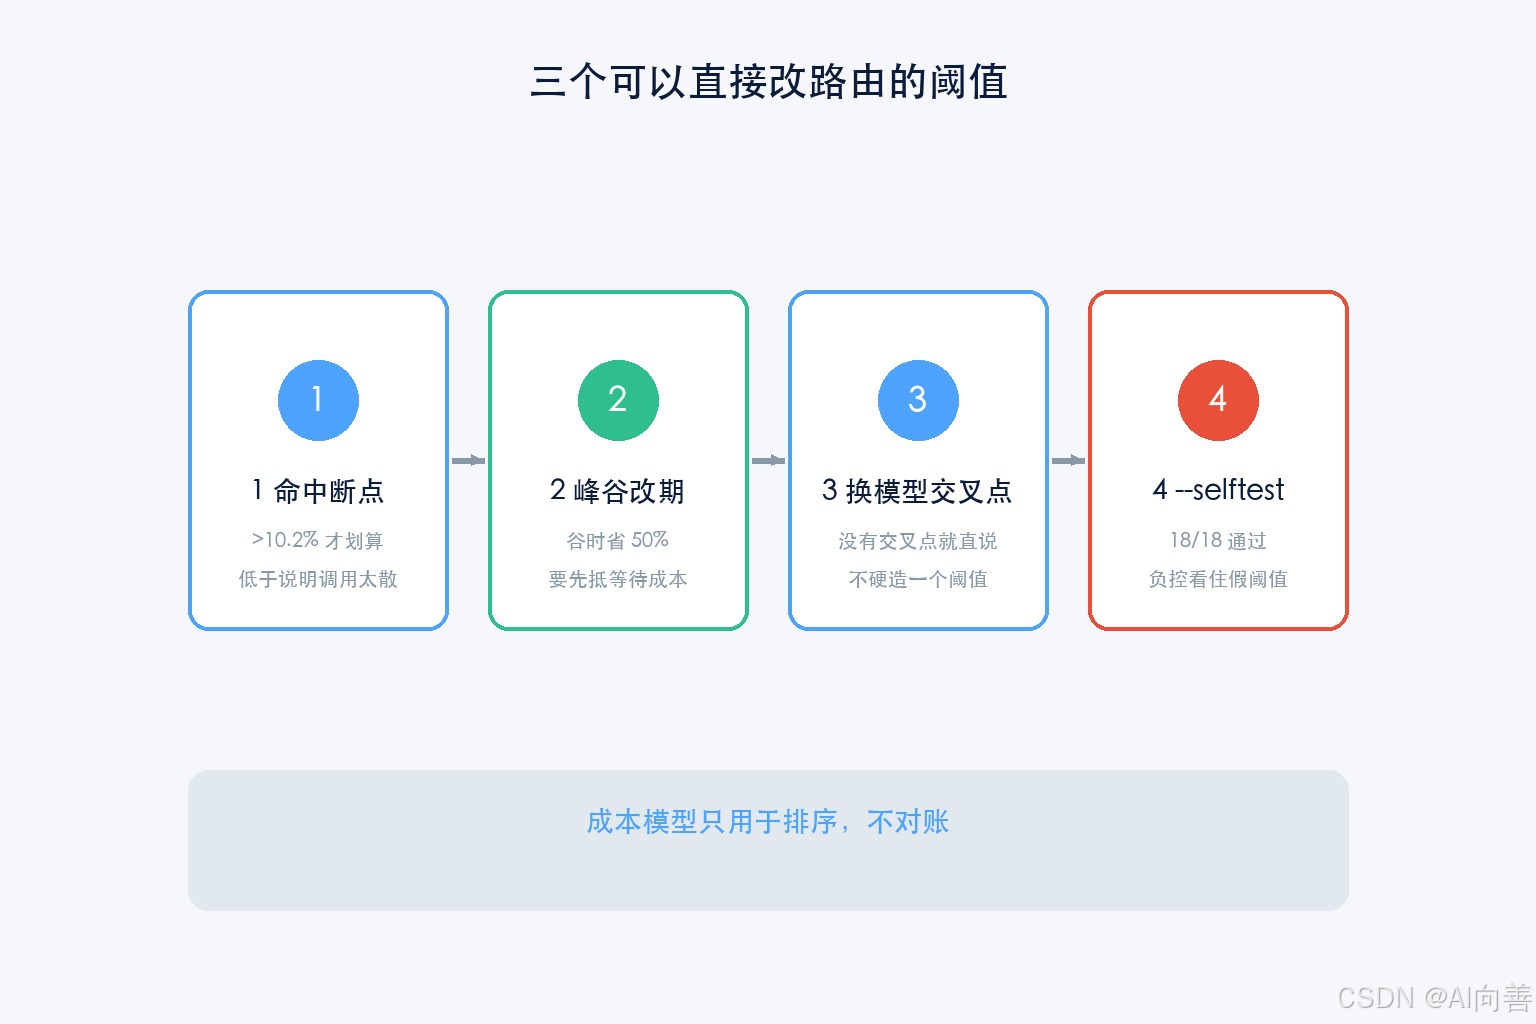
脚本 cache_cost.py 输出三个可以直接拿去改路由配置的阈值,每个都带成立条件。
阈值一:缓存划不划算(命中断点)。 收益是「命中率 ×(未命中价 − 命中价)」,成本是「每次重建上下文的开销」。实跑结果给出的断点是 10.2%:命中率高于这个值,缓存就开始赚钱;低于它,说明你的调用模式太分散,同一份上下文很少被复用。
这里有个容易踩的坑:不要拿「命中一次省 50 倍」直接当决策依据。 如果你的缓存命中率只有 3%,那 50 倍的价差一分也拿不到,因为绝大多数调用走的都是未命中那条路。价差是潜力,命中率才是兑现率。
阈值二:什么时候该等(峰谷节省)。 高峰单价是空闲的 2 倍,实跑给出「谷时成本 2.118 vs 峰时 4.236」,节省 50%。但脚本明确写了备注:这笔收益要和等待成本比。 一个用户等 30 秒换 50% 折扣,对批处理任务划算,对交互式产品不划算。
阈值三:什么时候该换模型。 脚本会算两条成本线的交叉命中率;如果不存在交叉点,它会直说「全区间都是某一方更便宜」,而不是硬造一个阈值出来。负控里专门有一条断言看住这件事。
四、脚本全文
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""cache_cost.py — 把缓存命中率折算成真实单位成本 + 路由切换阈值"""
import argparse
import json
import sys

def effective_cost(hit_price, miss_price, out_price, hit_rate, out_ratio=1.0):
    """每百万输入 token 对应的真实成本。"""
    if not 0.0 <= hit_rate <= 1.0:
        raise ValueError("hit_rate 必须落在 0-1")
    if hit_price < 0 or miss_price < 0 or out_price < 0:
        raise ValueError("单价不能为负")
    if out_ratio < 0:
        raise ValueError("out_ratio 不能为负")
    input_cost = hit_rate * hit_price + (1.0 - hit_rate) * miss_price
    output_cost = out_ratio * out_price
    return {"hit_rate": round(hit_rate, 4),
            "input_cost": round(input_cost, 6),
            "output_cost": round(output_cost, 6),
            "total": round(input_cost + output_cost, 6)}

def cost_curve(hit_price, miss_price, out_price, out_ratio=1.0, steps=11):
    return [effective_cost(hit_price, miss_price, out_price, i / (steps - 1), out_ratio)
            for i in range(steps)]

def cache_payoff(hit_price, miss_price, write_cost, hit_rate):
    """缓存是否划算:收益 = 命中率 ×(未命中价 - 命中价);成本 = 重建开销。"""
    if miss_price <= hit_price:
        return {"worthwhile": None, "note": "命中价不低于未命中价,缓存无价差可赚"}
    if write_cost < 0:
        raise ValueError("write_cost 不能为负")
    break_even = write_cost / (miss_price - hit_price)
    if break_even > 1.0:
        return {"worthwhile": False, "break_even": round(break_even, 4),
                "note": "重建成本过高,任何命中率都不划算"}
    return {"worthwhile": hit_rate > break_even,
            "break_even": round(break_even, 4),
            "margin": round(hit_rate - break_even, 4),
            "note": f"命中率需高于 {break_even:.2%} 才划算"}

def offpeak_saving(idle, peak, hit_rate, out_ratio=1.0):
    a = effective_cost(idle["hit"], idle["miss"], idle["out"], hit_rate, out_ratio)
    b = effective_cost(peak["hit"], peak["miss"], peak["out"], hit_rate, out_ratio)
    if a["total"] <= 0:
        return {"saving": 0.0, "saving_ratio": 0.0}
    return {"idle_total": a["total"], "peak_total": b["total"],
            "saving": round(b["total"] - a["total"], 6),
            "saving_ratio": round((b["total"] - a["total"]) / b["total"], 4),
            "note": "改期的收益要与「等待成本」比较后再决定"}

def crossover_hit_rate(a, b, out_ratio=1.0):
    """交叉命中率:低于它用 b 更便宜,高于它用 a 更便宜。"""
    fa = (a["miss"] - a["hit"]) - (b["miss"] - b["hit"])
    ca = a["miss"] + out_ratio * a["out"]
    cb = b["miss"] + out_ratio * b["out"]
    if abs(fa) < 1e-12:
        return {"cross": None, "note": "两条成本线斜率相同,不存在交叉点",
                "cheaper_at_zero": "a" if ca <= cb else "b"}
    x = (ca - cb) / fa
    if x < 0 or x > 1:
        winner = "a" if ca <= cb else "b"
        return {"cross": None,
                "note": f"交叉点在 0-1 之外,全区间都是 {winner} 更便宜",
                "cheaper_at_zero": winner}
    return {"cross": round(x, 4), "note": f"命中率低于 {x:.2%} 时 b 更便宜"}

if __name__ == "__main__":
    ap = argparse.ArgumentParser()
    ap.add_argument("--hit", type=float, default=0.02)
    ap.add_argument("--miss", type=float, default=1.0)
    ap.add_argument("--out", type=float, default=4.0)
    ap.add_argument("--out-ratio", type=float, default=0.5)
    ap.add_argument("--hit-rate", type=float, default=0.9)
    ap.add_argument("--peak-mult", type=float, default=2.0)
    ap.add_argument("--write-cost", type=float, default=0.1)
    a = ap.parse_args()
    idle = {"hit": a.hit, "miss": a.miss, "out": a.out}
    peak = {k: v * a.peak_mult for k, v in idle.items()}
    cur = effective_cost(a.hit, a.miss, a.out, a.hit_rate, a.out_ratio)
    print(f"实际成本 {cur['total']:.4f} 元 / 百万输入 token"
          f"(输入 {cur['input_cost']:.4f} + 输出 {cur['output_cost']:.4f})")
    print(json.dumps(cache_payoff(a.hit, a.miss, a.write_cost, a.hit_rate),
                     ensure_ascii=False))
    print(json.dumps(offpeak_saving(idle, peak, a.hit_rate, a.out_ratio),
                     ensure_ascii=False))
跑起来:
python cache_cost.py --hit 0.02 --miss 1 --out 4 --out-ratio 0.5 \
    --hit-rate 0.9 --peak-mult 2 --write-cost 0.1
python cache_cost.py --selftest   # 18/18 通过
五、踩坑:三个自检里抓出来的错
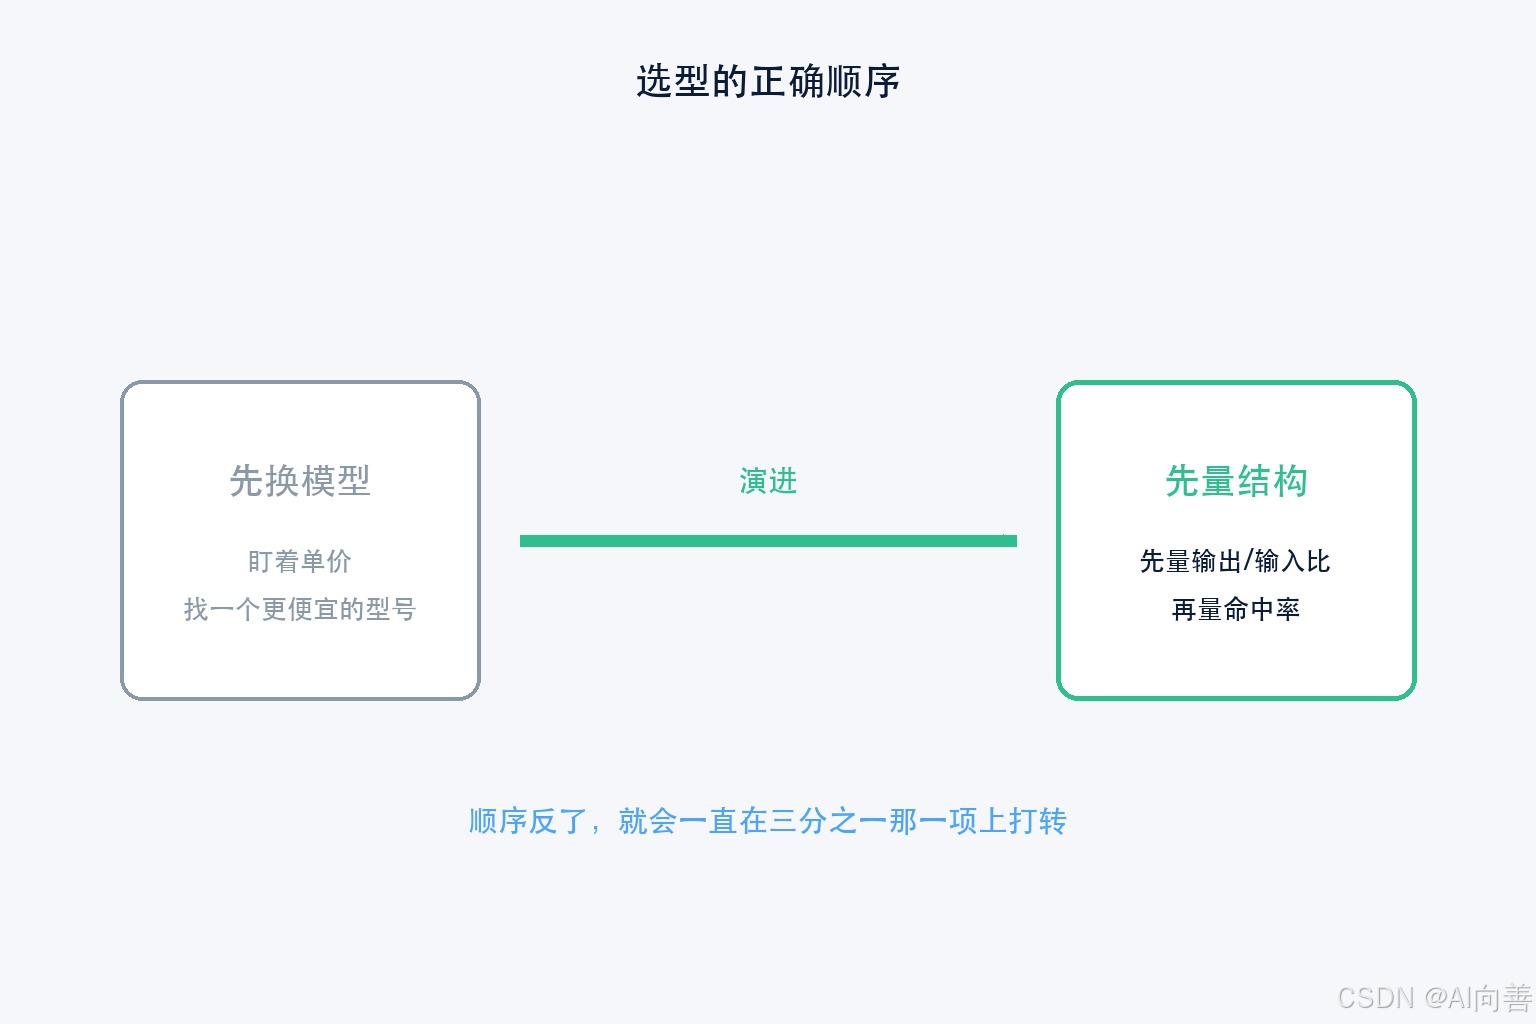
坑一:把 50 倍当成了账单降幅。 我最初直接把「命中省 50 倍」写进结论,直到把输出项加进成本函数才看明白:50 倍是单价之比,账单降幅由输出占比决定。 输出/输入比取 0.5 时,整体只能降约 33%。
坑二:成本曲线必须单调,否则公式一定错了。 命中率越高成本却越高,说明命中/未命中的符号写反了。这种错在只看一个点的时侯很难发现,跑一条曲线就立刻暴露。
坑三:不许给不存在的阈值。 如果两款模型的成本线斜率相同,就不存在交叉点。脚本对这种情况返回 cross: None 并直接说明「全区间都是某一方更便宜」,而不是算出一个假数字。负控断言 P10 就是看住这条。
工程取舍方面,这套换算的价值在它把「优化缓存」从直觉变成了一条有天花板的曲线。另一个角度是,它也有明确的适用边界:它会低估长尾调用的真实成本,因为真实流量里命中率是按请求分布波动的,而这里用的是单一平均值。如果你的负载方差很大,应该按分位数分别算,而不是只看平均值。这一点不能忽视。
六、所以调用量的领先意味着什么
回到开头那组数字。中国模型周调用量连续 20 周超过美国,最容易被解读成「模型更强」。但从成本结构看,更可能的解释是:在同等预算下,能跑的调用次数更多。
有一层证据支持这个读法:同一周里美国模型的调用量增速是 +31.56%,远高于中国模型的 +7.85%(来源:OpenRouter 公开榜单,2026-09)。基数大的一方增速低,通常说明增长已经从「抢新用户」进入「稳存量」的阶段。
调用量领先不是结论,它是成本结构的结果;而成本结构里,缓存命中率是唯一能被工程师单方面改变的那一项。
所以如果你正在做模型选型,我的建议顺序是:先量自己的输出/输入比(它决定优化天花板),再量命中率(它决定离天花板还有多远),最后才谈换模型。顺序反了,就很容易在只占成本三分之一的那一项上反复优化。
你们的缓存命中率现在是多少?欢迎在评论区聊聊:
- 你们的负载更接近「长输入短输出」还是「短输入长输出」?这个结构决定了缓存优化的上限,你们量过吗?
- 高峰时段改到空闲时段,你们实际省下来的钱抵得上等待成本吗?有没有算过这笔账?
- 如果命中率只有 10% 左右,你会选择先改调用模式(聚合请求提高复用),还是直接换更便宜的模型?为什么?
数据与事件来源
- OpenRouter 9 月 7 日至 13 日全球总调用 127 万亿 Token(+10.43%)、中国模型 61.17 万亿(+7.85%)、美国模型 21.76 万亿(+31.56%)、中国模型连续 20 周领先、TOP5 中四款为中国模型:OpenRouter 公开榜单与媒体转述,2026-09;二手口径,未取得原始明细。
- 2026 年 6 月我国日均 Token 调用量接近 175 万亿:国家数据局公开披露口径,2026-09。
- DeepSeek V4.1 Flash 空闲时段 0.02 / 1 / 4 元、高峰时段 0.04 / 2 / 8 元(每百万 Token),较 V4 Flash 缓存命中输入降约 60%、未命中输入降约 33.3%、输出降约 11.1%:厂商定价页与公开报道,2026-09;价格随时可能调整,以官方页面为准。
- V4.1 Flash 上线 48 小时消耗约 4.8 万亿 token、缓存命中率 90%:厂商披露口径,2026-09;自述数据,无第三方复核。
- 本文脚本
cache_cost.py的--selftest(18/18 通过)与实跑输出:本地实跑(2026-09-15)。成本模型假设为「每百万输入 token 对应固定输出比」,不代表任何厂商的真实计费实现,请以自己账单为准。

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 13
 0
- 0


 已为社区贡献4条内容

所有评论(0)