登录社区云,与社区用户共同成长
邀请您加入社区
新的 Agent 工具出现时,很多人会习惯性地让几个产品跑同一个任务,再比较谁响应更快、回答更长、代码更顺眼。这种方式适合判断“今天用哪个工具”,却不一定能回答另一个更重要的问题:某个运行时是否适合成为团队长期依赖的底座。DeepSeek Harness 的相关素材里有一个值得注意的判断:如果目标只是让 AI 完成网页、PPT、报告或代码,WorkBuddy、Codex 这类成品工具通常更直接;
公开评测中,DeepSeek 新一代模型的研究生级推理(GPQA)成绩从上代的约 59 分提升到约 73 分,这类推理能力的增强,直接反映在“把复杂问题讲明白”的水平上。这篇文章不吹不黑,把提升的部分、没提升的部分,以及真正改变游戏规则的变量,逐层拆开讲清楚。真正成熟的方案,从来不是把大模型接上就完事,而是用大模型负责“怎么说”,用知识库负责“说什么”,用本地部署解决“能不能用”。没有大模型时,每
《生成式引擎优化实践中的内容适配困境与解决方案》摘要: 在生成式引擎优化(GEO)实践中,企业常面临不同AI平台的内容适配难题。研究发现,豆包偏好结构化、步骤化的本地化内容,而DeepSeek更倾向逻辑严谨的深度分析,二者在内容结构、信息权重上存在根本性差异。强行采用"一套内容通吃"策略往往导致品牌在两端均表现不佳。更有效的解决方案是构建内容矩阵:先产出权威母版内容,再衍生适配
AI时代品牌营销新战场:GEO(生成式引擎优化)崛起 随着AI原生应用月活突破4.4亿,消费者正从传统搜索转向AI直接提问,品牌营销迎来范式转变。数据显示,豆包、DeepSeek、GoogleGemini三大平台日均处理数百亿次问答,其中知识查询、消费决策类问题占比显著。GEO(生成式引擎优化)成为关键策略,其核心是让AI在生成内容时优先推荐品牌,这与传统SEO形成本质区别。目前金融、教育、消费品
官方 SAFETY.md 更直接指出:项目尚未经过安全审计,不能视为 secure / production-ready。官方 architecture.md 明确说明:Cordis 是 dsh 的基础框架;model adapter、tool registry、session log、agent loop 本身也都是 plugin,因此可以通过配置替换。官方甚至明确写出:不存在需要 patch
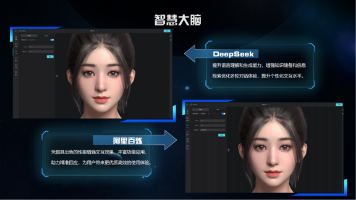
以时空节拍旗下时空镜3D数智人交互平台为例,其"智慧大脑"模块采用"大模型+智能体+问答库"三层架构,在DeepSeek等大模型底座之上接入扣子智能体,让数字人既能通过问答库保证专业口径的准确性,又能通过智能体实现任务级的主动执行;再往前一步,还有"多智能体协同"的想象空间:一个数字人前台背后,可以挂着排班调度、知识检索、业务办理等多个后台Agent协作运转,用户面对的始终是一个"人",而复杂度被
以时空节拍旗下时空镜3D数智人交互平台为例,其"智慧大脑"模块采用大模型+智能体+问答库的三层架构,已实现对DeepSeek、扣子智能体等多种主流模型的接入支持,同时提供问答库定制、多并发、敏感词屏蔽能力,问答缓存后交互响应时间不超过3秒,支持公有云、私有云和本地部署三种交付方式。这种"平台管体验、模型可插拔"的架构思路,本质上是把选型风险从"一次性决定"变成"可持续调整"——今天政务项目用本地部
让「该算的才被算」——GDN 管 FFN 动态路由,QSA 管注意力稀疏检索,Gated Residual 稳住多路径训练,N-gram Embedding 在不动激活的前提下扩容。四者合力,把 125B 总参数的模型压到了 6B 激活的推理成本。对企业来说,这意味着前沿模型私有化的门槛又低了一截。如果企业想把 Qwen4 架构的能力稳妥地落到自有服务器、又不想从零搭建推理与运维链路,可评估环曜企
Qwen3.8-Flash-Next 是官方「Qwen4 架构预览机」:125B 总量、每 token 仅激活 6B,叠加51B 可存显存外的 N-gram 条件记忆。它用四条创新回答「如何又大又便宜」——超级稀疏 MoE、N-gram 条件记忆、QSA 微块级稀疏注意力、GDN 线性注意力混合层(48 层为12×(3 GDN + 1 QSA)),配合门控残差与 Muon 优化,约 1/3 tok
DeepSeek-V3.2以开源路线对抗国际巨头,通过DSA稀疏注意力机制、可扩展GRPO训练框架和大规模合成Agent数据集三大创新,实现性能追平Gemini 3.0 Pro但价格仅为1/5。文章介绍了其技术突破、实战表现及开源战略意义,承认仍有约10%差距但正在快速缩小,预示新一代模型即将到来,展现了中国AI在资源劣势下的自主创新能力和技术自信。
单卡部署不再是梦!🚀 本文手把手带你实战 Qwen3.8-27B 本地部署,揭秘其原生多模态架构如何突破显存与性能的“算力鸿沟”。从 FP8 量化到 vLLM 推理,一文读懂单卡最强模型的演进逻辑,助你低成本解锁企业级 AI 能力。💡
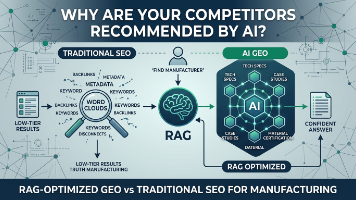
上周一位做精密注塑与模具制造的企业老板找到我,丢过来几张截图。他用 DeepSeek、Kimi 和豆包分别搜索了“华南地区前五的大型精密注塑件供应商”以及“医疗级模具定制厂家推荐”,结果大模型列出了 4~5 家同行的名字,甚至详细列出了同行的厂房面积、认证资质和核心客户案例。他非常郁闷:“我们在华南做了十五年,厂房上万平,ISO、IATF 16949 资质齐备,客户还有上市公司。如果你也有同样的困
当一个跑了一年多的基于 LLM 自动化流程积累了超过万条真实数据后,我产生一个想法:能不能用这些数据训练一个专用小模型,然后把 API 调用替换成本地推理,这样能够显著减少数据外出风险,同时也能学习到模型微调相关的知识(我承认这是一个主要目的)?因此有了本文,记录了从动机到落地的完整思路。
从 DeepSeek Harness 的讨论区里,反推出了一个神秘团队的技术架构 先交代下我是怎么注意到这事的。 这可能是执行类 Agent 的一个典型范式
本文探讨GUI智能体(GUI Agent)接入企业内网时的安全权限治理方案。随着阿里Qwen-UI-Agent等开源项目在真机基准测试中的优异表现,GUI Agent已具备实际部署能力。然而,相比传统API Agent,GUI Agent能读取屏幕所有内容并模拟点击操作,继承了人类操作员的全部权限,却缺乏人类的风险直觉,带来UI钓鱼欺骗、破坏性点击和静默外泄三类威胁。 为此,作者提出"三道闸"治理
本文介绍了为DeepSeek Harness(DSH)设计的记忆增强架构,提出三层记忆系统(working/archival/core)和混合检索方案。核心思路是将索引转化为记忆通道,通过FTS5词法检索和sqlite-vec向量检索的RRF融合实现精准召回,同时利用事件元数据进行零成本标记。系统支持工具结果去重和KV-safe稳定注入,验证表明能有效提升上下文管理效率。该开源方案不依赖LLM元数
Qwen3.8与Qwen3.6技术架构解析 核心摘要 阿里巴巴Qwen系列大模型实现两大技术突破: Qwen3.8-Max旗舰版:2.4万亿参数MoE架构,仅激活950亿参数实现高效推理,在第三方评测中综合能力全球第二,支持百万Token上下文和原生多模态能力,首次开源Max级模型权重(4.89TB BF16版本)。 Qwen3.6私有化部署版:35亿总参数MoE模型仅激活3亿参数,使大模型首次适
DeepSeek技术架构与源码分析摘要 DeepSeek系列模型通过"以轻驭重"的工程化理念,在算力受限条件下实现高性能。开源生态包括从轻量级推理模型到超大规模MoE模型的完整矩阵,采用MIT许可证,在GitHub和ModelScope平台同步发布。 核心模型分析: DeepSeek-R1蒸馏版:通过动态知识蒸馏框架(特征层/输出层/任务特定三层蒸馏)实现小模型高性能。R1-0528版本在数学推理
高峰时段算力挤兑,推理成本居高不下,补贴式低价模式难以为继,峰谷定价就此登场:工作日白天高峰价格翻倍,凌晨、周末维持平峰价格,同时区分缓存命中 / 未命中两套计费标准。切换模型不是填一个 API 地址就完事,结构化输出、Agent 规划能力、输出风格、上下文对齐都会发生偏移,上线前必须做完整回归测试,很多项目踩坑就在这里:以为无缝平替,上线之后业务大量异常。本次调价缓存命中与未命中价差巨大,精简
2026年大模型私有化部署指南:开源模型能力提升,部署工具成熟,提供场景化选型方案。开源模型如Kimi K3、DeepSeek-V4-Pro等已具备1M以上上下文处理能力,量化技术让消费级显卡运行27B参数模型成为可能。决策图涵盖个人PC、企业API、长文本RAG等场景,推荐Qwen3.8-27B(个人)、DeepSeek-V4-Flash(企业)、Llama 4 Scout(长文本)等模型。FP
core/agent定义接口但不实现它;实现该接口并通过注册。这使得消费者可以仅依赖ctx.agents而不需要直接依赖包。
Claude Code 的 Token 消耗本质上是一个上下文管理问题,而非单纯的提示词精简问题。本文综合多篇关于 Claude Code 省 Token 与提效的实践指南,系统梳理了从项目记忆、提示词工程、模型选择、工作流设计到工具链优化的完整方法论。核心结论是:要获得 60%–80% 的 Token 节省,必须设计好上下文架构——控制自动注入的上下文、缩小任务搜索范围、及时压缩会话、把高噪音工
而且它的AI功能采用用户自行对接各平台API的方式,费用透明,想接文心一言、DeepSeek还是Kimi,自己说了算,不存在数据被中间商截留的风险。AI读图、AI理解、AI写脚本、AI执行——听起来很酷,实际上AI生成的自动化脚本稳定性极差,页面元素一变就崩,每次修复都得重新调prompt,token还烧得飞快。AI智能优化元素路径这块,你甚至不用学晦涩的xpath语法,对着页面用自然语言描述一句
摘要 DeepSeek Harness(DSH)的核心架构Cordis采用"一切皆插件"的设计理念,模型适配器、工具注册表等所有组件均为可动态替换的插件。系统分为三层:底层Cordis微内核管理插件生命周期;中间层通过Profile、Bundle、Patch三级配置机制灵活组装插件组合;顶层提供四种预设运行模式。插件系统基于五个核心概念(插件写法、Context、Service、Fiber、inj
Agent 任务可能因为模型超时、进程重启、开发者下班或权限等待而中断。恢复时若只读取最后一条消息,很容易遗漏未完成工具、未写入事件和已经变化的工作区。当前仓库版本是否与中断时一致。是否有工具进程仍在运行或已经产生副作用。最后一个检查点之后有哪些未确认事件。权限租约、密钥和外部服务状态是否仍然有效。上下文策略和插件版本是否发生变化。人工是否修改了任务目标或停止条件。只有这些检查通过,才能从检查点继
摘要(150字): 2023年AI应用场景爆发推动大语言模型架构高速迭代,传统Transformer的Attention模块与KVCache机制成为算力与显存瓶颈的核心痛点。本文系统梳理Attention架构六代演进:从MHA的基础范式到GQA的KV头精简,再到MLA的低秩降维与单头缓存优化;随后突破稠密计算限制,DSA通过Token稀疏筛选削减长序列算力,最终CSA融合滑动窗口与压缩技术实现算力
本文探讨了DeepSeek Harness(dsh)作为Agent系统运行时的核心设计理念与工程实现。dsh通过插件化架构将模型、工具、上下文等组件解耦,构建了一个可动态装配的运行时环境。文章详细分析了dsh的分层架构(Launcher、Composition、Runtime等六层),重点阐述了插件系统的三大特征:1)基于服务名的依赖管理,实现局部替换而不影响全局;2)完整的生命周期管理,包括初始
一次 web_search 背后,模型、工具、会话日志与 Agent Loop 如何被动态装配?本文沿完整调用链拆解 DeepSeek Harness 的插件依赖、事件留痕与可逆副作用
文章摘要:本文系统解析了支撑生产级AI智能体的Harness工程体系,提出十二层模块化架构设计,从基础循环到多智能体协作逐层递进。该体系通过工具权限管控、任务锚定机制、上下文压缩、异步任务等核心技术,构建安全可控的智能体运行环境,实现业务逻辑与底层框架的彻底解耦。其核心设计哲学强调"环境赋能智能"而非硬编码规则,采用分层防御机制保障稳定性,通过极致解耦适配长期迭代,为区分Demo级与工业级智能体提
DeepSeek Harness 的 PTC 模式值得关注,不是因为它让 Agent 变成了一个更复杂的聊天窗口,而是因为它把工具编排显式地放到了程序层。对于稳定的文件筛选、测试汇总和报告整理,这种方式可能减少上下文重复和调用等待;对于不稳定或高风险的任务,它也可能放大一次错误,绕过开发者原本能看到的中间步骤。