登录社区云,与社区用户共同成长
邀请您加入社区
同一供应商连续三年的价格变化趋势、同一业务单元不同合同的条款差异、同一类合同中最常见的风险点分布——这些问题依赖的不是单份合同,而是合同之间的横向连接。合同是一个PDF,是一个Word,是一个不可拆解的整体。新合同进来,系统调取同类合同的历史审查轨迹,告诉处理人“上次类似条款是这样改的,因为……它想告诉你交货期可能有风险,付款条款和去年相比有变动,某个供应商的价格三年涨了四次——但你的系统只记录,
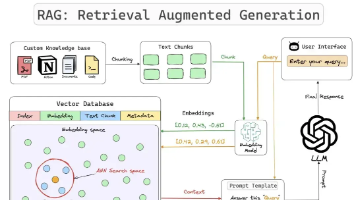
RAG的核心机制融合了信息检索系统的精确性和语言模型的强大生成能力,为基于自然语言的任务提供了更为灵活和精准的解决方案。
上周组里排了个技术债务清理的活,涉及三个模块的接口层重构,原本排期两周、三个人分着干。因为其中一个同事休假,另一个被临时抽去支援别的项目,最后这活落到了我头上。我想着反正也得加班,不如试试全程用Claude Code推。结果两天半,三个模块全部重构完毕,自测通过,PR提了。周五写周报的时候,我在"本周完成"那栏写了一行:“完成XX模块、YY模块、ZZ模块接口层重构(原排期两周)”。发出去之后5分钟
没有人能忽视这一事件对 Anthropic 品牌价值的巨大助推。在事件之前,尽管有“宪法 AI”的光环,但在公众认知里,Anthropic 依然是 OpenAI 的挑战者,带着一种“更安全但可能更笨”的刻板印象。FABLE5 的泄露,完美地重构了叙事:Anthropic 不再是一个追赶者,而是一个手握危险魔法、却道德高尚到主动选择放弃的守护者。这个“自我阉割”的行为,比任何广告都更有效地巩固了其“
现在用 Codex、Claude Code、GitHub Copilot,以及接入豆包 Seed、GLM、MiniMax、Kimi 等国内模型的 Coding Agent 写代码,已经不是什么新鲜事了。它并不阻止旧代码被修改,只要求修改者回答几个具体问题:过去为什么这样做,过去的前提是否还成立,这次为什么要改变,以及新的决定由谁确认。Coding Agent 的问题往往不是完全忘记前文,而是没有区
Claude Code 越用越乱?Sub-Agents 才是上下文污染的解法
本文介绍了一个基于LangChain Agent和Streamlit构建的自然语言驱动数据分析助手Demo。该工具允许用户上传CSV文件后,通过自然语言提问(如"绘制销售额趋势图"或"计算品类平均利润"),系统会自动生成并执行Python代码返回结果。后端使用LangChain Agent调用DeepSeek模型生成代码,前端通过Streamlit实现交互界面。项目结构简洁,包含Agent核心逻辑
不少科研人图省事,把完整国自然初稿、临床预实验数据、待申报专利全部粘贴进Claude、GPT处理,最后酿成无法挽回的损失:有人上传全套靶点研究方案辅助写作,交互内容被平台抓取用于模型训练,核心创新点提前外泄,直接导致专利丧失新颖性,数年实验付诸东流。很多科研人分不清工具边界,一味追求大模型更强的文本能力,却忽视数据泄露带来的连锁后果。遵守三条AI使用红线,优先选择境内合规、签订数据保密协议的垂直科
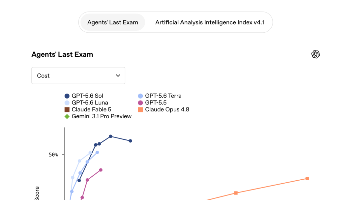
我们先看旗舰模型 Sol 的表现。也就是说,大模型在内存里自导自演把脏活累活全干完了,过滤掉没用的噪音,最后只把关键的结论返回给你的主程序。在编程测试中,GPT-5.6 Sol 在 Coding Agent Index 编程跑分上以 80 分的成绩登顶,比 Fable 5 高出 2.8 分,而它的输出 Token 只有后者的一半,耗时也是后者的一半,成本低了三分之一。这种一来一回的往返不仅造成了严
FuckClaude是一款开源工具,可检测浏览器环境特征评估用户被识别为"Claude中国用户"的风险程度。该工具通过分析6项区域指纹(如系统时区、语言、字体等)生成0-100分的风险评分,分为低/中/高三个等级。其中系统时区权重最高,因其与Claude官方检测逻辑直接相关。测试显示不同设备得分差异显著,但开发者强调这仅是环境相似度评估,非封号预测。工具完全在本地运行,不上传数
DeepSeek推出的DSpark是一种高效的大模型投机解码(Speculative Decoding)推理加速框架,旨在解决自回归生成推理效率低下的问题。传统投机解码方案存在生成质量瓶颈(如并行草稿器的多模态冲突)和系统效率瓶颈(固定验证长度导致算力浪费)。DSpark通过半自回归生成架构(并行骨干+轻量串行校正头)提升草稿质量,结合置信度调度验证机制动态调整验证长度,优化GPU资源分配。
《AI浪潮下的测试行业变革:机遇与挑战并存》 生成式AI正在重塑软件测试全流程:GitHub Copilot实时生成代码,TestGPT自动输出千级测试用例,使测试覆盖率达98%,效率提升80%。AI在缺陷预测、脚本自维护等方面展现出强大能力,但也带来62%初级岗位可能消失的职业危机。测试工程师必须转型为AI训练师和质量架构师,掌握复杂场景建模、AI指令设计等核心技能。未来,人机协同将成为主流,A
AI Coding正在重构软件开发的生产方式,其核心影响在于个体责任边界的结构性扩张。研究表明,AI辅助使资深开发者产出提升6.2%,但效用取决于使用者的判断力与系统理解能力。组织需要从四个维度进行适配:度量体系转向结果导向指标、协作模式转为异步化、人才结构侧重判断型角色、治理机制覆盖人机协同产出。效率传导要求组织同步调整承接机制,未来的竞争优势将属于最早完成组织适配的企业。
如何让大模型真正“动手干活”,实现数据处理、统计分析、图表绘制、文献研读、论文撰写等科研环节辅助增效,解放研究者的时间与精力?无论你是亟待完成科研任务、顺利毕业的研究生,是深耕学术领域、冲刺职称晋升的青年教师,还是致力于提质增效、赋能团队科研的骨干力量,都能在这里精准匹配自身需求,学有所获、满载而归,真正让AI工具成为科研路上的“左膀右臂”。4.熟悉学术科研全流程AI赋能方法:文献管理、选题立项、
Multi-Agent系统是由多个自主的智能体组成的分布式系统,每个Agent具备独立的感知、决策、执行能力,Agent之间通过通信机制交换信息,共同完成单个Agent无法实现的全局目标。
如何让各种 Coding Agent 更好的干活?在常规的对话外,Claude Code(也可以是 Codex)其实还提供了一些别样的控制(或者说:上下文注入)方法,比如:`CLAUDE.md`、`Rules`、`Skills`、`Subagents`、`Hooks`、`Output Styles`、以及 `System Prompt Append`
如果你想自己定义标签体育、财经、娱乐、健康、教育用通用大模型接口(豆包、DeepSeek、GPT)最方便。给文字打标签。判断正面 / 负面 / 中性。python运行请对以下文本分类,只能从以下类别选择:体育、财经、娱乐、健康、教育文本:{}只输出类别,不要解释。data = {# 测试print(deepseek_classify("明星发布新歌"))
Trae是字节跳动于2025年1月推出的AI原生集成开发环境,其名称“The Real AI Engineer”已暗含了产品定位——不只是在传统IDE上叠加AI功能,而是从底层架构深度融合大模型能力,让AI成为开发工作流的核心组成部分。从全流程自动化的Trae,到引领“第三时代”的Cursor,再到生态深度整合的GitHub Copilot和云原生专家Amazon Q Developer,2026
摘要: 远程协作已成为软件测试团队的常态,带来灵活性同时也面临沟通延迟、流程复杂等挑战。本文针对测试从业者,从工具、流程、文化与个人能力四维度提出效率提升策略:工具链整合实现测试管理一体化,流程标准化推行异步优先与透明看板,文化重塑强化目标对齐与团队归属感,个人能力升级注重书面沟通与自我管理。未来趋势将聚焦智能化协作与深度集成,测试人员需适应远程环境,从“用例执行者”转型为“质量协作工程师”,以系
你是否经历过这些场景?把GPT-4塞进VS Code插件写代码时,它要么忘记打开项目根目录的.gitignore,要么找不到依赖包的pip install路径——LLM有逻辑,但没有「环境上下文感知器」和「精准指令执行约束器」;用AutoGPT做市场调研,它查了10个GitHub仓库、爬了50篇博客,最后生成的报告却把竞品的版本号写错3个、把技术栈搞混Python/Java——LLM有搜索,但没有
肿瘤流行病学是链接基础医学与临床实践的枢纽,但其文献的内部语言结构仍缺乏系统化量化。本文在已验证的可计算元认知框架基础上,以 2021 ‑ 2026年间969 篇开放获取肿瘤流行病学论文为语料,构建该学科的语义基线并系统检测边界信号(统计阈值、风险度量等),为跨学科对齐提供可复用的坐标体系。