GPT-5.6发布,性能反超 Claude 5,能帮你省下75%的消耗
GPT-5.6 引入了更强的屏幕使用和界面检查能力。它把前端代码渲染出来后,会自己去 inspect 渲染后的画面。如果发现某个组件遮挡了文字,或者配色太丑不协调,它会在交付给我们之前自己默默改掉。
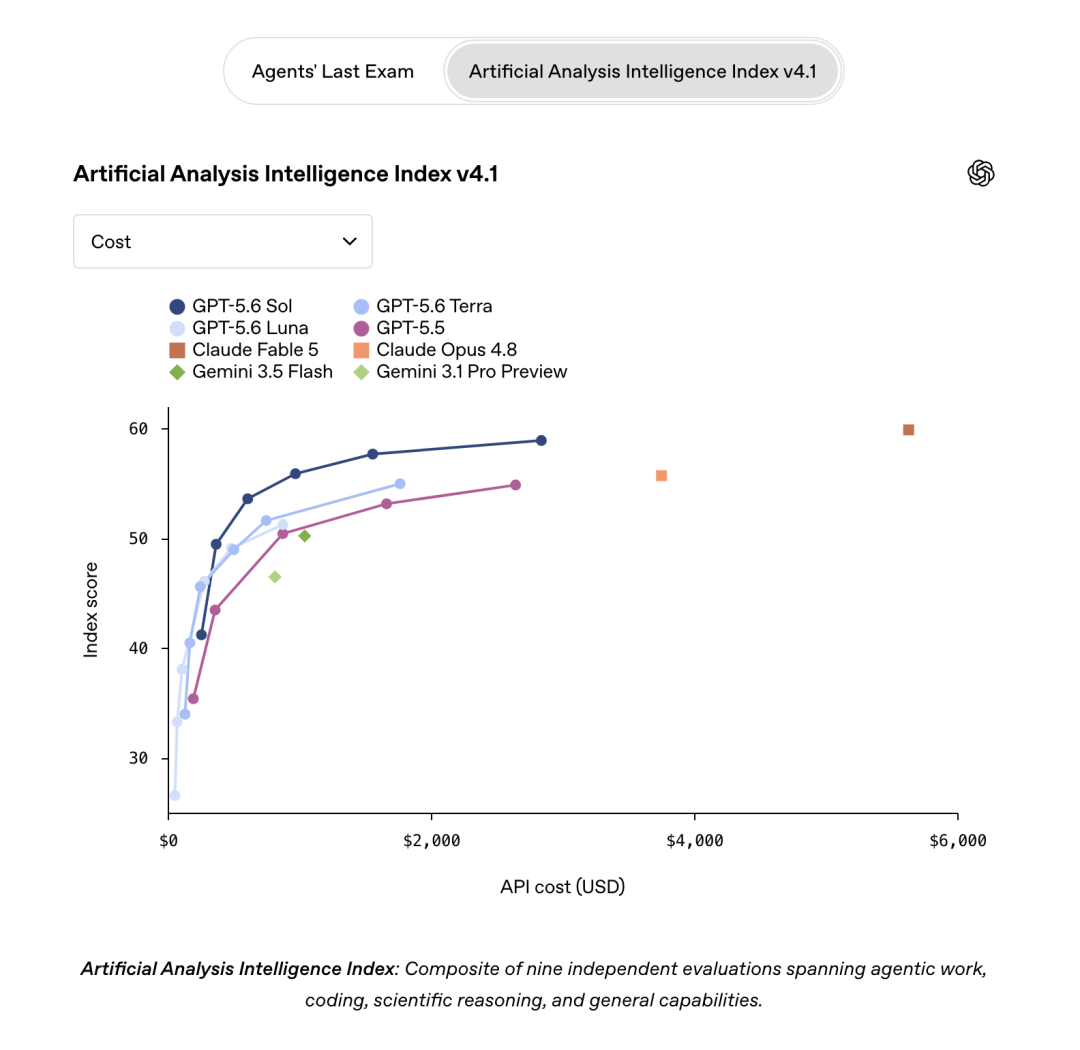
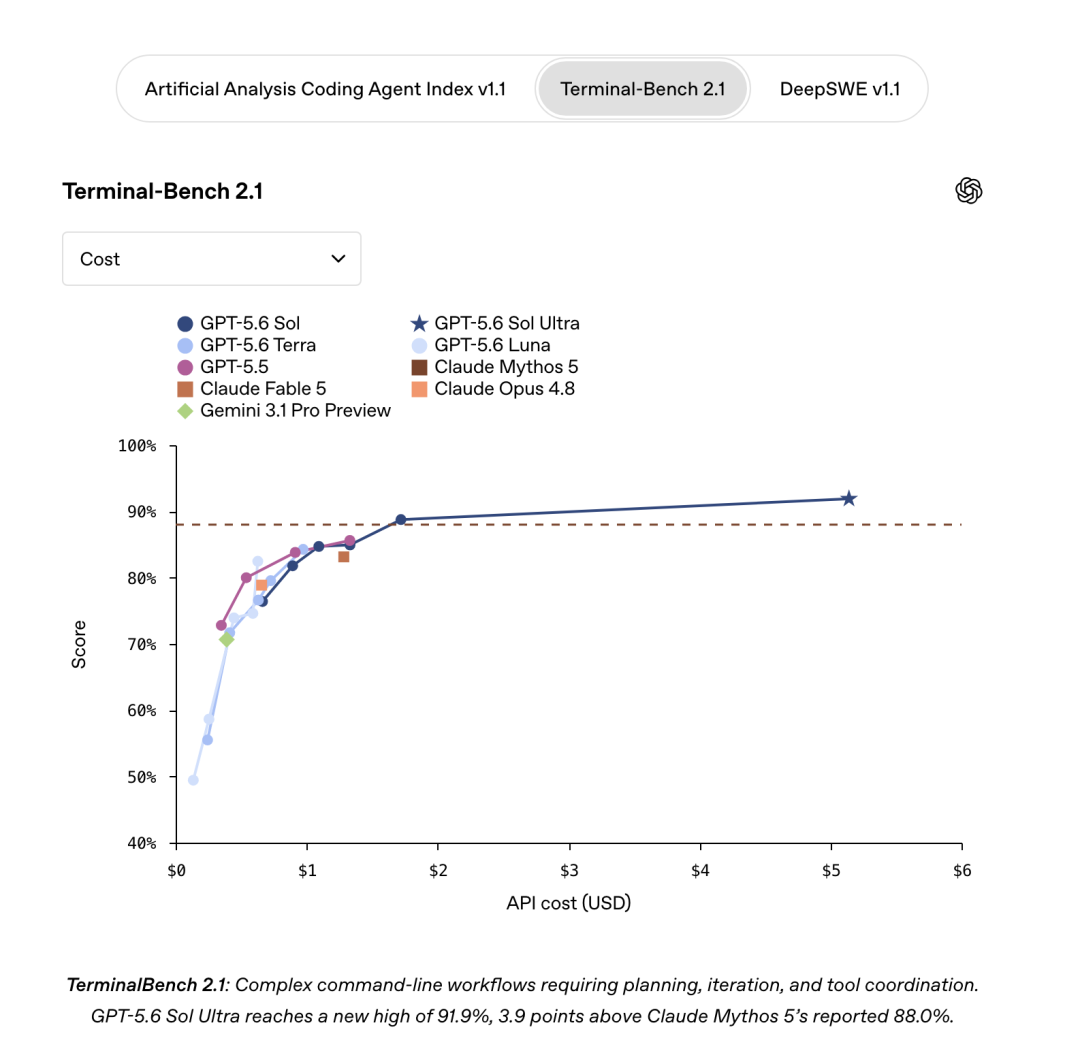
OpenAI 刚刚突然发布了新一代大模型 GPT-5.6 系列。技术社区里现在铺天盖地都是它把 Claude Fable 5 锤得有多惨的跑分截图。不过作为天天和 API 账单打交道、被 Token 费用折磨的落地工程师,我第一眼盯着的其实是这一代模型在工程成本上的改进。它把开发 Agent 的运行费用狠狠砍掉了一大截,这比单纯的高跑分要实用得多。
这次发布的 GPT-5.6 包含三款定位明确的模型:旗舰版 Sol、中端版 Terra 以及极致性价比的 Luna。这套组合拳的定价思路和性能划分非常有针对性。
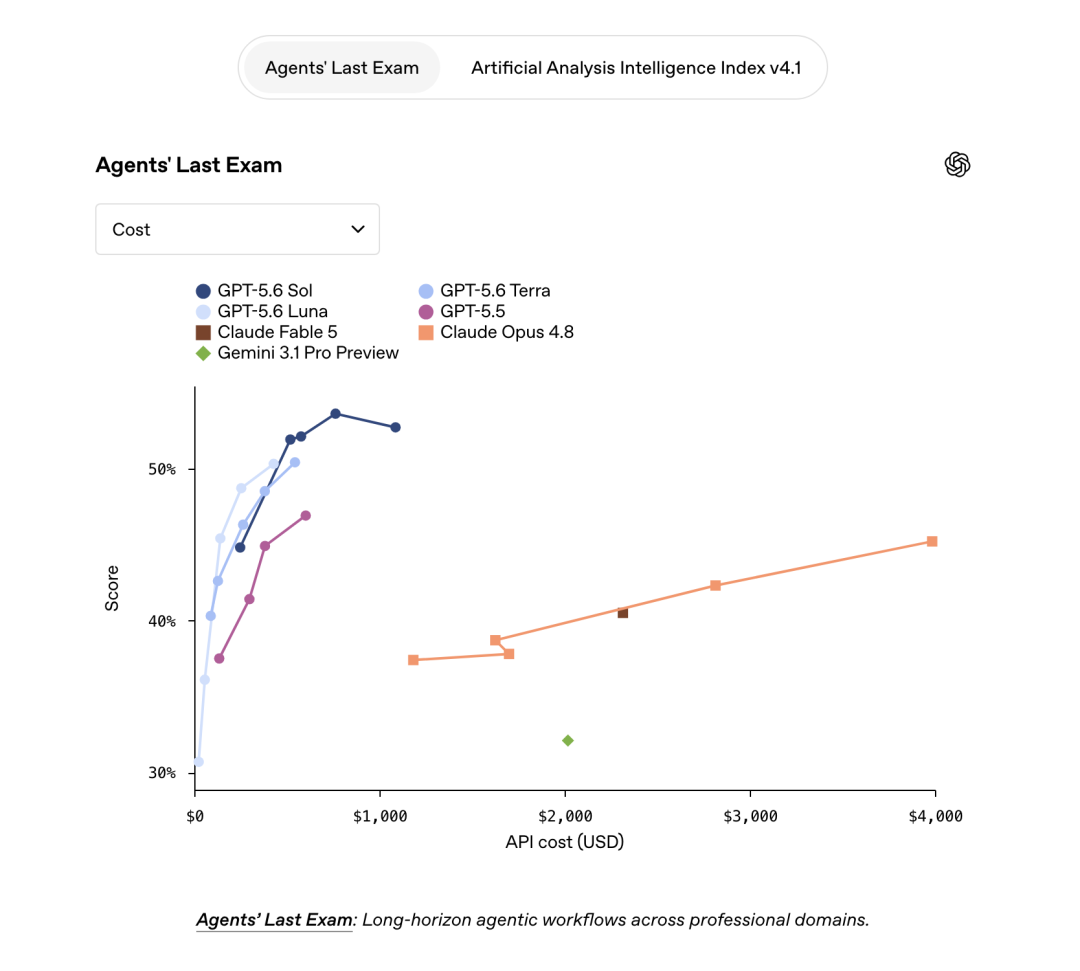
我们先看旗舰模型 Sol 的表现。在针对长序列、多步骤专业工作流的 Agents' Last Exam 评测中,Sol 拿到了 53.6 的高分,直接把 Claude Fable 5 甩开了 13.1 分。在这个测试里,很多模型跑着跑着就逻辑崩溃了,但 Sol 不仅稳稳跑完,而且它的运行成本只有 Fable 5 的四分之一。
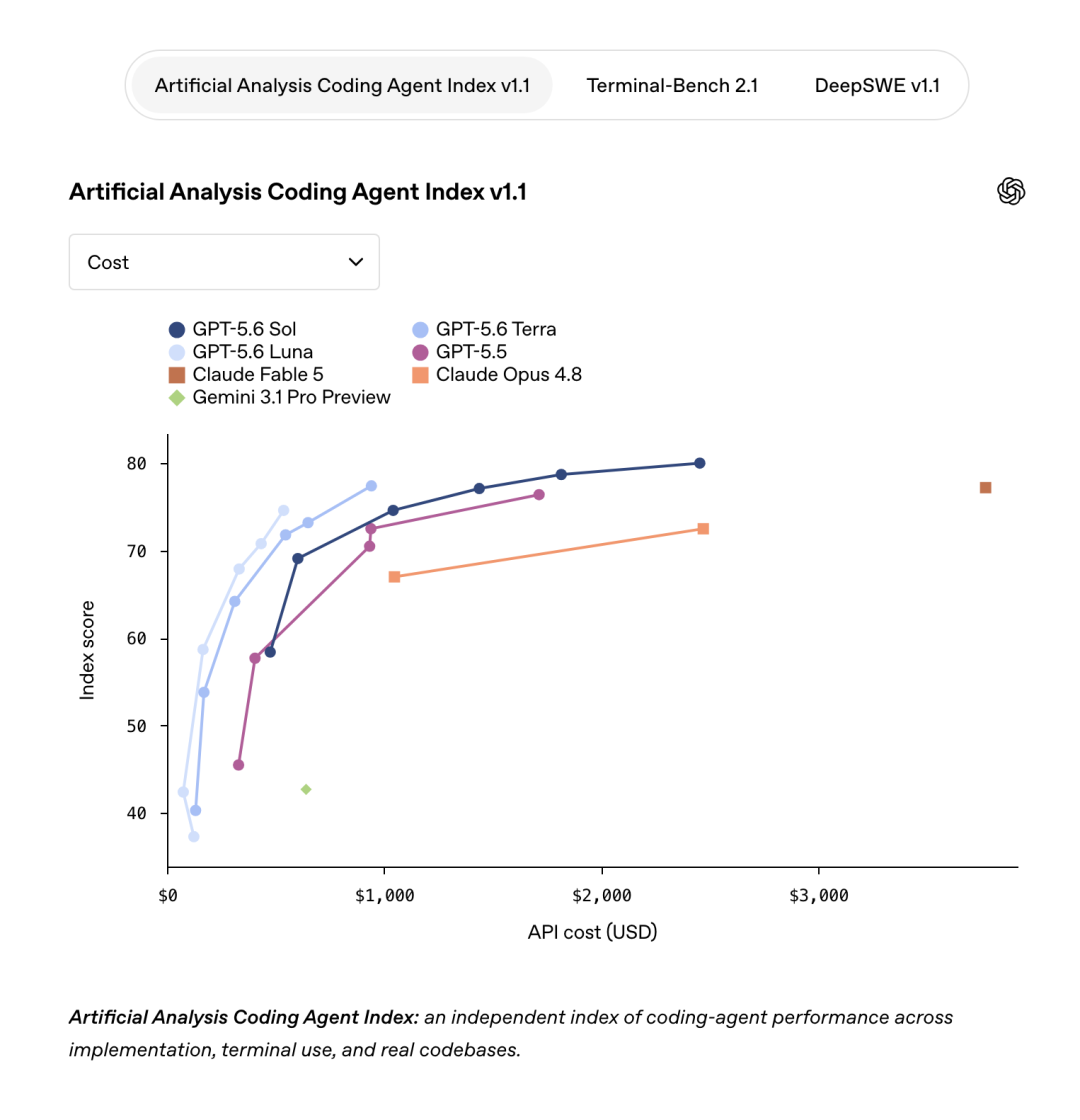
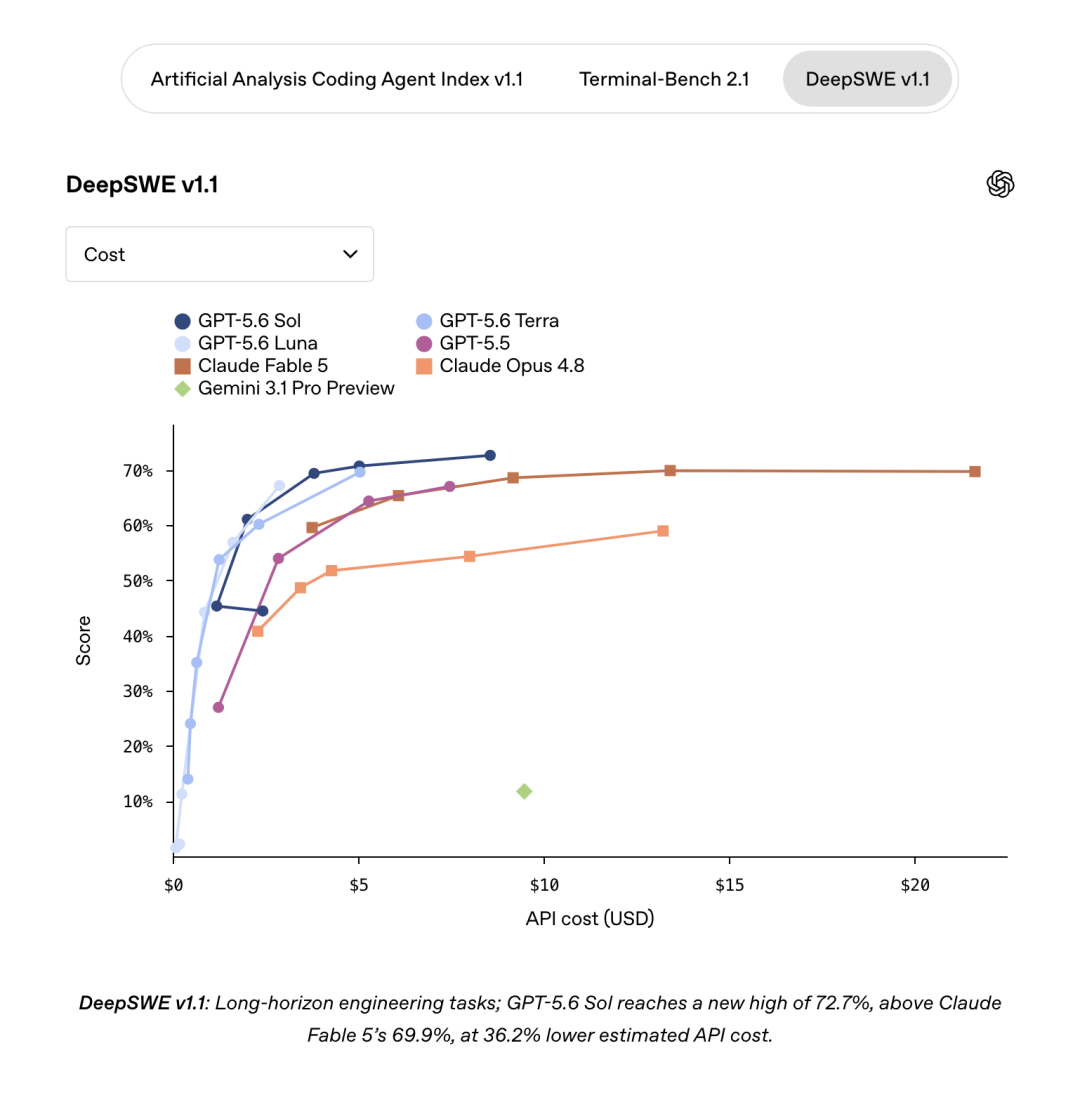
这种成本优势到了中端和性价比模型上更加夸张。在编程测试中,GPT-5.6 Sol 在 Coding Agent Index 编程跑分上以 80 分的成绩登顶,比 Fable 5 高出 2.8 分,而它的输出 Token 只有后者的一半,耗时也是后者的一半,成本低了三分之一。
中端模型 Terra 的整体表现已经能够和 Fable 5 打平,但它的调用单价只有后者的十六分之一。这意味着之前因为预算有限而不敢大规模上生产环境的复杂 Agent,现在用 Terra 或者 Luna 就能用极低的价格跑起来。
大模型能省这么多钱,核心在于它引入了 Programmatic Tool Calling,也就是程序化工具调用。
在以前的 Agent 开发中,我们常常遇到这样的尴尬境地。当大模型需要调用外部工具时,它得先说它要用什么工具,然后把请求发回给我们的后端代码。后端代码跑完工具、拿到几万字的原始数据后,再把数据塞回给大模型。大模型在海量数据里过滤出想要的部分,接着做下一步思考。
这种一来一回的往返不仅造成了严重的延迟,更要命的是,随着上下文越叠越厚,后续的每一次模型调用都会重复消耗大量不必要的 Token 费用。
现在 GPT-5.6 换了个思路。它支持直接在内存中自动编写并执行一段轻量级程序,由这段程序去跑工具和清洗数据。也就是说,大模型在内存里自导自演把脏活累活全干完了,过滤掉没用的噪音,最后只把关键的结论返回给你的主程序。这种机制把模型和 API 之间的往返次数降到了最低,直接省下了大笔上下文 Token 开销。
针对需要高强度并行的业务,GPT-5.6 在 API 里集成了 multi-agent 模式。在客户端也就是 ultra 模式下,它能并行调配 4 个子 Agent 协同处理任务。
在 BrowseComp 和 SEC-Bench Pro 等复杂场景下,加满 4 个甚至 16 个 Agent 并行之后,整体评测曲线直接往左上方漂移,用更短的用时拿下了更高的准确率。这给我们的系统架构提供了一个全新的调优维度。如果你的任务极其棘手,你就可以通过 ultra 模式用多 Agent 并行来换取最高的正确率和最快的响应速度。
这种在端到端复杂任务上的掌控力,也反映在它的知识处理和网络浏览测试上。
在 OSWorld 2.0 评测中,大模型需要直接操控电脑桌面对 Slack、Notion 和 Microsoft 365 里的混乱文件进行分析并输出专业文档。GPT-5.6 Sol 直接拿下了 62.6% 的高分,超越了之前的王者 Claude Opus 4.8,并且输出的 Token 数量减少了 85%。Luna 模型则以不到一半的成本,几乎追平了上一代旗舰 GPT-5.5 的表现。
在技术深度上,GPT-5.6 在网络安全测试中也有大突破。
针对复杂代码漏洞检测与自动修补的 ExploitBench 测试中,Sol 拿下了 73.5% 的得分,而前代旗舰 GPT-5.5 只有 47.9%。在漏洞利用评测 ExploitGym 里,Sol 将限时利用的成功率从 15.1% 拔高到了 24.9%,这使得它能在安全防御、 secure code review 以及自动化蓝队对抗中发挥极大的防守和分析价值。
除了帮开发者省钱和解决复杂技术问题,GPT-5.6 还在前端 UI 交付上展现了极其少见的设计直觉。
之前我们让大模型写 React 或者 Vue 页面,它基本上只是盲人摸象。代码写完了,但按钮是不是错位、配色是不是反人类、移动端自适应有没有崩,它自己其实根本不知道。
GPT-5.6 引入了更强的屏幕使用和界面检查能力。它把前端代码渲染出来后,会自己去 inspect 渲染后的画面。如果发现某个组件遮挡了文字,或者配色太丑不协调,它会在交付给我们之前自己默默改掉。这种具备审美判断力的输出,让生成的页面真正达到了开箱即用的状态。
另一个帮开发者省钱的利器是 Prompt 缓存机制的升级。
以往的 Prompt Caching 很多时候像开盲盒。稍微改动了一行系统提示词,或者上下文顺序微调了一下,原有的缓存就完全失效了,导致下一次请求依然要全额计费。
这次 OpenAI 给 GPT-5.6 引入了 30 分钟的最短缓存生命周期,并且支持显式缓存断点设置。简单来说,我们可以手动把那些绝对不会变的部分,比如核心业务逻辑和大型文档库,明确标记为缓存断点。这部分数据在后续请求中会被牢牢锁死在缓存里。更良心的是,读取缓存直接享受 90% 的折扣,这对于需要高频调用的 Agent 来说简直是救命的优惠。
以往的大模型升级总是陷入堆叠参数、拼跑分智商的套路。但从 GPT-5.6 身上,我们能看到大模型已经开始进入比拼每美元价值的实用主义阶段。对于苦于 Token 费用昂贵而无法落地的团队来说,这代模型提供了一条非常清晰的降本路径。

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 6
 0
- 0


 已为社区贡献35条内容

所有评论(0)