比 llama.cpp 还快 8.5%:用纯 CUDA 手写一个 0.6B 模型的推理引擎
一、先说说这玩意儿是干嘛的
学 CUDA 和 GPU 编程的时候,总有一个念头在脑子里转:写了这么多矩阵乘法、内存拷贝的 demo,能不能真的干点有用的?比如——跑一个大语言模型?
说干就干。选了个 Qwen3-0.6B,参数不大,RTX 3050 的 8GB 显存刚好能装下。目标很明确:不借助 PyTorch、不依赖 Transformers,纯用 CUDA C/C++ 写一个能跑的推理引擎。不是玩具,是真的能聊天、能思考、能测性能的那种。
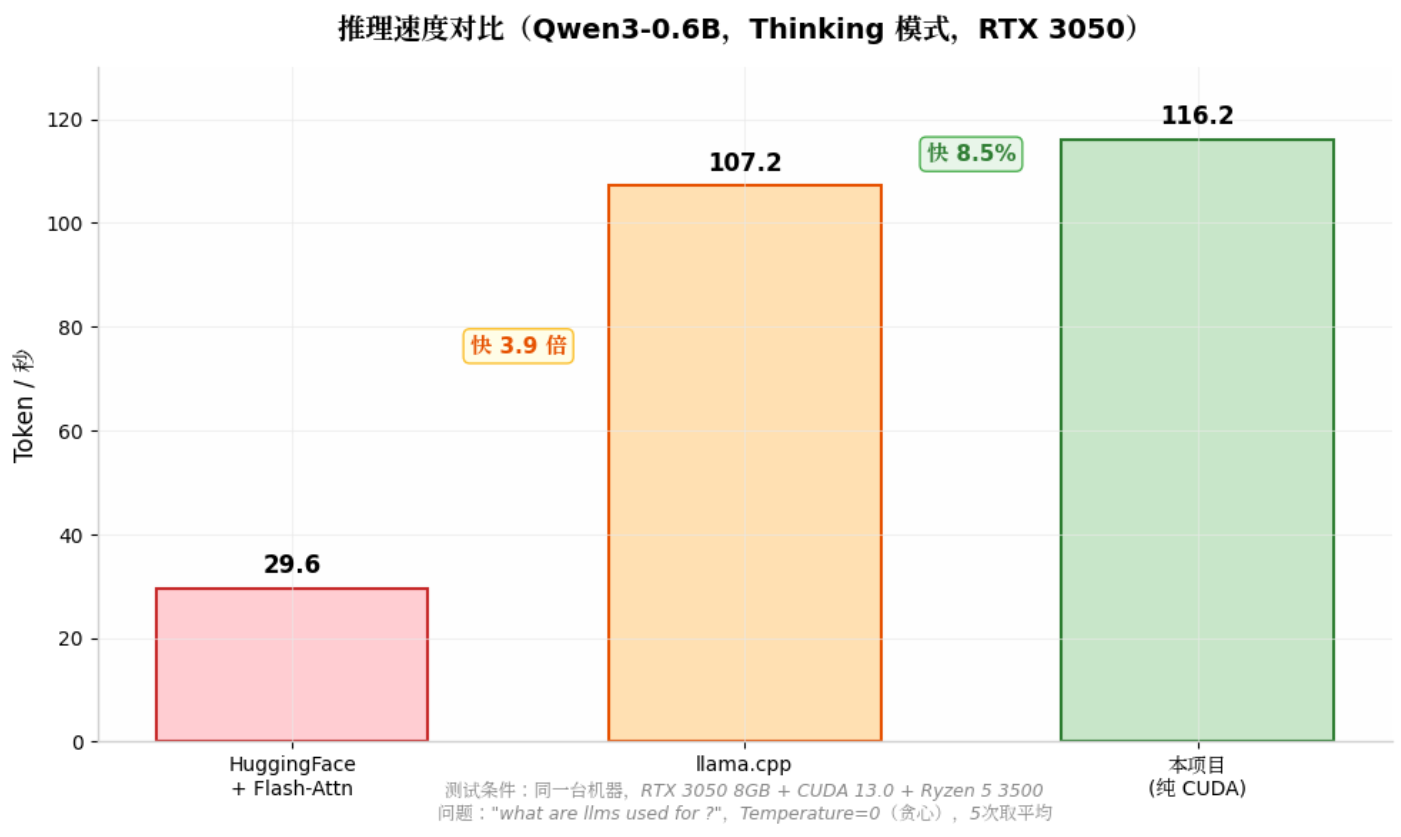
最后的结果挺让人意外的:在 RTX 3050 上,单批次推理,Thinking 模式下跑到了 116 token/秒。同一张卡上,llama.cpp 是 107 token/秒,HuggingFace + Flash-Attention 只有 29.6 token/秒。比后者快了将近 4 倍,比前者也快了 8.5%。
这篇文章就是把这个过程的思路、代码、踩坑经验全摊开讲。
二、具体含义:它到底包含哪些东西?
| 模块 | 干啥的 | 为什么重要 |
|---|---|---|
| 模型加载 | mmap 映射 safetensors,异步拷贝到 GPU | 启动快,内存零拷贝 |
| 单块 GPU 内存 | 一次 cudaMalloc,所有权重按偏移量访问 | 零碎片,指针管理零开销 |
| bf16 推理 | 权重和激活都用 brain-float16 | 省显存,精度损失小 |
| cuBLAS GEMM | 矩阵乘法调 NVIDIA 官方库 | 成熟、快、省事儿 |
| 手写 CUDA Kernel | RMSNorm、RoPE、Softmax、残差连接 | 灵活,可融合优化 |
| KV Cache | 每层缓存 K/V,增量推理 | 解码不随长度变慢 |
| Top-k + Top-p 采样 | GPU 上直接做,不用回 CPU | 减少 H2D/D2H 往返 |
| Thinking 模式 | 模型先"自言自语"再回答 | Qwen3 的特色功能 |
| 静态编译优化 | 模型维度写进 config.h,编译时确定 | 循环边界常量化,编译器大胆优化 |
三、代码实现原理:拆开来看
1. 设计哲学:suckless,能砍的全砍
这个项目的核心设计理念就两个字:极简。不是"功能多但代码少"的极简,是"只留必要的,多余的一行都不要"的极简。
- 单批次:不折腾 batching,一次只处理一个请求。代码里不用算 batch offset,不用处理变长序列,所有维度都是编译期常量。
- 配置写进代码:模型维度、层数、头数全部写在
config.h里,编译时就知道。编译器看到常量循环边界,会自动展开、向量化、调度寄存器。 - 依赖极少:cuBLAS(矩阵乘法,NVIDIA 官方,逃不掉)、CUB(一些 GPU 上的常用算法,比如 reduce)、标准 IO。没了。
// config.h 示例(简化)
#define N_LAYERS 28
#define N_HEADS 16
#define N_KV_HEADS 4      // GQA:4 个 Query 共享 1 个 K/V
#define DIM 1536          // 嵌入维度
#define HIDDEN_DIM 8960   // MLP 中间层
#define VOCAB_SIZE 151936 // 词表大小
#define MAX_SEQ_LEN 32768 // 最大上下文
这些值在编译时就确定了,所以代码里写 for (int i = 0; i < DIM; i++),编译器知道 DIM=1536,可以生成最优的指令序列。
2. 内存管理:mmap + 异步拷贝 + 单块显存
模型权重从 HuggingFace 下载下来是 model.safetensors,几百 MB。怎么最快地弄到 GPU 上?
传统做法:
fread → CPU RAM → cudaMemcpy → GPU VRAM
问题:fread 把文件全读到内存,占一份 RAM;cudaMemcpy 是同步的,CPU 干等着。
这个项目的做法:
mmap → CPU 虚拟地址空间 → cudaMemcpyAsync → GPU VRAM
// mmap 映射文件到内存
int fd = open("model.safetensors", O_RDONLY);
struct stat sb;
fstat(fd, &sb);
void* mapped = mmap(NULL, sb.st_size, PROT_READ, MAP_PRIVATE, fd, 0);

// 异步拷贝到 GPU
cudaMemcpyAsync(gpu_weights, mapped, sb.st_size, cudaMemcpyHostToDevice, stream);
mmap 的好处是按需加载:操作系统不会一次性把文件全读进内存,而是当你访问哪一页时,才从磁盘加载哪一页。cudaMemcpyAsync 让 CPU 不用阻塞等待,拷贝在后台进行,CPU 可以继续干别的(比如准备下一个 token 的输入)。
权重到了 GPU 之后,只申请一次显存,所有层的权重、KV Cache、中间激活全部放在这一大块里,用偏移量访问:
// 单块 GPU 内存分配
size_t total_size = weights_size + kv_cache_size + activation_size;
float* d_buffer;
cudaMalloc(&d_buffer, total_size);

// 各层权重通过偏移量访问
float* w_embed = d_buffer + 0;
float* w_layer0_attn_q = d_buffer + embed_offset;
float* w_layer0_attn_k = d_buffer + embed_offset + q_proj_size;
// ...
没有 cudaMalloc/cudaFree 的反复调用,没有内存碎片,所有指针在初始化时就算好了,推理阶段零开销。
3. bf16:省显存的甜蜜点
模型权重和激活值都用 bf16(brain-float16),不是 fp16。
bf16 和 fp16 的区别:
| 格式 | 指数位 | 尾数位 | 精度 | 范围 |
|---|---|---|---|---|
| fp16 | 5 | 10 | 较高 | 较小 |
| bf16 | 8 | 7 | 较低 | 和 fp32 一样大 |
bf16 的指数位和 fp32 一样(8 位),所以数值范围和 fp32 相同,不容易溢出。尾数位少 3 位,精度稍差,但对大模型来说通常够用。而且 NVIDIA GPU 对 bf16 的硬件支持很好。
// bf16 的 CUDA 加载(简化示意)
__nv_bfloat16* w_bf16 = (__nv_bfloat16*)d_weights;
__nv_bfloat16* x_bf16 = (__nv_bfloat16*)d_input;

// cuBLAS 的 bf16 GEMM 调用
cublasGemmEx(handle, CUBLAS_OP_N, CUBLAS_OP_N,
             m, n, k,
             &alpha,
             x_bf16, CUDA_R_16BF, m,
             w_bf16, CUDA_R_16BF, k,
             &beta,
             out_bf16, CUDA_R_16BF, m,
             CUBLAS_COMPUTE_32F,  // 内部用 fp32 累加,保精度
             CUBLAS_GEMM_DEFAULT);
注意 CUBLAS_COMPUTE_32F:虽然输入输出是 bf16,但 cuBLAS 内部用 fp32 做累加,避免 bf16 累加误差累积。这是保证精度的关键。
4. 手写 CUDA Kernel:RMSNorm
矩阵乘法交给 cuBLAS,但归一化、位置编码、残差连接这些操作,手写 CUDA Kernel 更灵活,还能做 Kernel 融合(把多个操作合并成一个 Kernel,减少读写显存的次数)。
RMSNorm 的 CUDA Kernel 大概长这样:
__global__ void rms_norm_kernel(__nv_bfloat16* out, const __nv_bfloat16* in,
                                const __nv_bfloat16* weight, int size, float eps) {
    // 每个 block 处理一行(一个 token 的嵌入向量)
    int row = blockIdx.x;
    int tid = threadIdx.x;

    // 共享内存存平方和
    __shared__ float s_sum;

    // Step 1: 算平方和
    float sum_sq = 0.0f;
    for (int i = tid; i < size; i += blockDim.x) {
        float val = __bfloat162float(in[row * size + i]);
        sum_sq += val * val;
    }

    // block 内归约求和
    sum_sq = blockReduceSum(sum_sq);
    if (tid == 0) s_sum = sum_sq;
    __syncthreads();

    // Step 2: 算 rms
    float rms = 1.0f / sqrtf(s_sum / size + eps);

    // Step 3: 缩放并写回
    for (int i = tid; i < size; i += blockDim.x) {
        float val = __bfloat162float(in[row * size + i]);
        float w = __bfloat162float(weight[i]);
        out[row * size + i] = __float2bfloat16(val * rms * w);
    }
}
关键点:
- 每个 block 处理一行(一个 token),block 内线程协作算平方和
blockReduceSum用 CUB 或手写 warp shuffle 做快速归约- 输入输出都是 bf16,但计算时转 fp32,避免精度损失
5. RoPE:旋转位置编码
Qwen3 用 RoPE(Rotary Position Embedding)。每个 head 的维度分成对,每对做一个二维旋转,旋转角度跟位置有关。
__global__ void rope_kernel(__nv_bfloat16* q, __nv_bfloat16* k, int pos,
                            int head_dim, int n_heads, int n_kv_heads) {
    int tid = blockIdx.x * blockDim.x + threadIdx.x;
    int total_threads = n_heads * head_dim / 2;  // 每对维度一个线程

    if (tid >= total_threads) return;

    int head = tid / (head_dim / 2);
    int pair = tid % (head_dim / 2);
    int dim_idx = pair * 2;

    // 计算旋转频率
    float freq = 1.0f / powf(10000.0f, (float)(dim_idx) / head_dim);
    float angle = pos * freq;
    float cos_val = cosf(angle);
    float sin_val = sinf(angle);

    // 读取一对值
    float v0 = __bfloat162float(q[head * head_dim + dim_idx]);
    float v1 = __bfloat162float(q[head * head_dim + dim_idx + 1]);

    // 二维旋转
    q[head * head_dim + dim_idx]     = __float2bfloat16(v0 * cos_val - v1 * sin_val);
    q[head * head_dim + dim_idx + 1] = __float2bfloat16(v0 * sin_val + v1 * cos_val);

    // K 同样处理(如果当前 head 是 KV head)
    if (head < n_kv_heads) {
        // ... 对 k 做同样的旋转
    }
}
6. Attention:Flash-Attention 风格的分块
Attention 计算 Softmax(Q @ K^T / sqrt(d)) @ V 是显存带宽瓶颈。如果直接算,中间结果 Q @ K^T 是一个 [seq_len, seq_len] 的矩阵,长上下文时显存爆炸。
Flash-Attention 的核心思想是分块计算:把 Q、K、V 切成小块,在 SRAM(共享内存)里算,不存中间矩阵。
// 简化示意:Flash-Attention 风格的分块 attention
__global__ void flash_attn_kernel(...) {
    // 每个 block 处理一个 head 的一个 Q 块
    __shared__ float s_q[TILE_SIZE][HEAD_DIM];
    __shared__ float s_k[TILE_SIZE][HEAD_DIM];
    __shared__ float s_v[TILE_SIZE][HEAD_DIM];

    // 加载 Q 块到共享内存
    load_gmem_to_smem(s_q, q_ptr);

    float max_score = -INFINITY;
    float sum_exp = 0.0f;
    float acc[HEAD_DIM] = {0};

    // 遍历 K/V 块
    for (int kv_tile = 0; kv_tile < num_kv_tiles; kv_tile++) {
        load_gmem_to_smem(s_k, k_ptr + kv_tile * TILE_SIZE * HEAD_DIM);
        load_gmem_to_smem(s_v, v_ptr + kv_tile * TILE_SIZE * HEAD_DIM);

        // 算 Q @ K^T 的一个块
        float scores[TILE_SIZE];
        for (int i = 0; i < TILE_SIZE; i++) {
            scores[i] = dot(s_q[threadIdx.y], s_k[i]) * scale;
            // Causal Mask:只算当前位置及之前的
            int global_kv_pos = kv_tile * TILE_SIZE + i;
            if (global_kv_pos > global_q_pos) scores[i] = -INFINITY;
        }

        // 在线 softmax(不存中间矩阵)
        float new_max = fmaxf(max_score, max(scores));
        float exp_scale = expf(max_score - new_max);
        sum_exp = sum_exp * exp_scale;
        for (int i = 0; i < TILE_SIZE; i++) {
            float e = expf(scores[i] - new_max);
            sum_exp += e;
            for (int d = 0; d < HEAD_DIM; d++) {
                acc[d] = acc[d] * exp_scale + e * s_v[i][d];
            }
        }
        max_score = new_max;
    }

    // 写回结果
    for (int d = 0; d < HEAD_DIM; d++) {
        out[...] = __float2bfloat16(acc[d] / sum_exp);
    }
}
核心技巧是在线 softmax:不存完整的 Q @ K^T 矩阵,而是每算一个 K/V 块就更新 softmax 的统计量(当前最大值、指数和、累加值)。这样显存复杂度从 O(seq_len^2) 降到 O(seq_len)。
7. Thinking 模式:让模型"自言自语"
Qwen3 的一个特色是 Thinking 模式。打开之后,模型不会直接回答问题,而是先输出一段 <think>...</think> 包裹的"内心独白",把推理过程显式写出来,然后再给正式答案。
// 推理循环中的 thinking 控制
if (reasoning_mode) {
    // 在 prompt 后附加特殊 token,触发 thinking
    // 模型会先生成 <think> ... </think> 块
    // 然后再生成正式回答
}

// 采样时检查是否遇到 thinking 结束标记
if (next_token == THINK_END_TOKEN) {
    // thinking 结束,接下来是正式回答
    print("\n\n");  // 换行,区分 thinking 和回答
}
这种模式对复杂问题特别有用。比如问"LLM 有什么用",模型会先想:“用户问的是 LLM 的应用场景,我应该从客服、写作、代码生成几个角度回答……” 然后再输出结构化的答案。你可以看到它是怎么"思考"的,调试和教学都很方便。
四、相关领域知识点
| 知识点 | 在这项目里的体现 |
|---|---|
| bf16 | 省显存、范围和 fp32 一样,NVIDIA GPU 原生支持 |
| mmap | 文件按需加载,不占用多余 RAM |
| cudaMemcpyAsync | 异步拷贝,CPU 不阻塞 |
| 单块显存 | 一次 cudaMalloc,偏移量访问,零碎片 |
| 静态编译优化 | 维度常量化,编译器自动展开循环 |
| Kernel 融合 | RMSNorm + 残差合并成一个 Kernel,减少显存读写 |
| Flash-Attention | 分块计算,在线 softmax,显存复杂度 O(seq_len) |
| GQA | 多 Query 共享 K/V,减少 KV Cache 带宽 |
| cuBLAS | NVIDIA 优化的矩阵乘法库,GEMM 调用 |
| CUB | CUDA 上的常用算法库(reduce、scan 等) |
五、设计思路:为什么这样设计?
| 设计选择 | 为什么这么做 | 生产框架会怎么做 |
|---|---|---|
| 纯 CUDA,无 Python | 零 Python 开销,启动即推理 | PyTorch 前端 + C++ 后端,有 GIL 和调度开销 |
| 单批次 | 代码最简单,不用处理 batch 逻辑 | Continuous Batching,支持多请求并行 |
| 静态编译优化 | 循环边界常量化,编译器生成最优代码 | 动态 shape,运行时决定 |
| bf16 | 省显存,精度够用,NVIDIA 原生支持 | fp16/int8/int4 量化,更复杂 |
| mmap + 异步拷贝 | 启动快,CPU 不阻塞 | 直接 fread + cudaMemcpy |
| 手写 Kernel + cuBLAS | 灵活性与性能的平衡 | 全部调库或全部手写 |
| Thinking 模式 | Qwen3 特色,教育价值高 | 普通聊天模式 |
六、代码实现用途
- 学习 CUDA 和 GPU 推理:从内存管理到 Kernel 手写,完整链路
- 理解 bf16 推理:看 cuBLAS 的 bf16 GEMM 怎么调
- Flash-Attention 入门:手写分块 attention,理解在线 softmax
- 性能优化参考:静态编译优化、Kernel 融合、异步流水线
- Qwen3 模型理解:Thinking 模式、GQA、SwiGLU 的完整实现
七、流程原理图
图1:整体架构
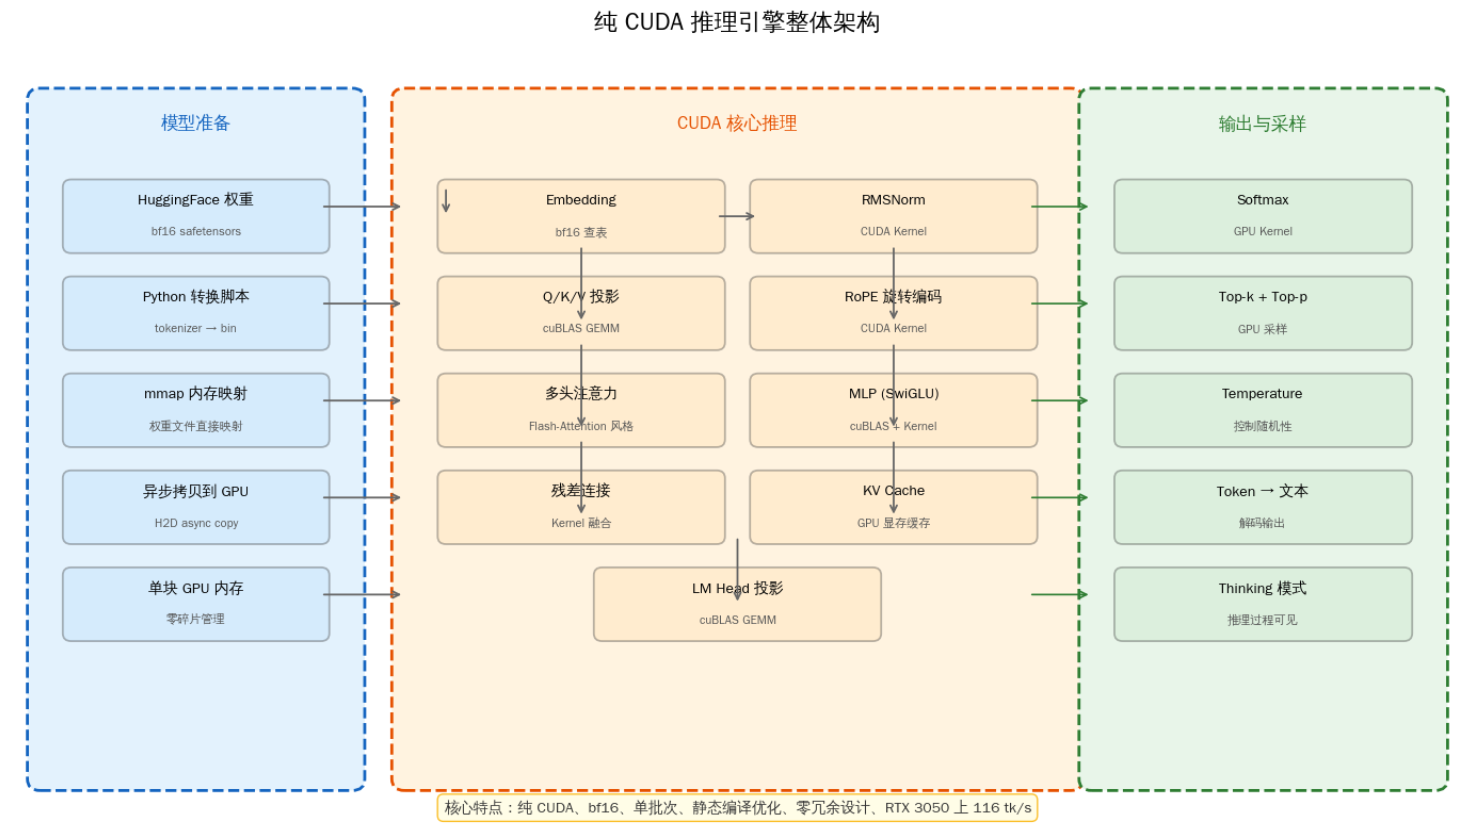
If you need the complete source code, please add the WeChat number (c17865354792)
图2:内存管理流程
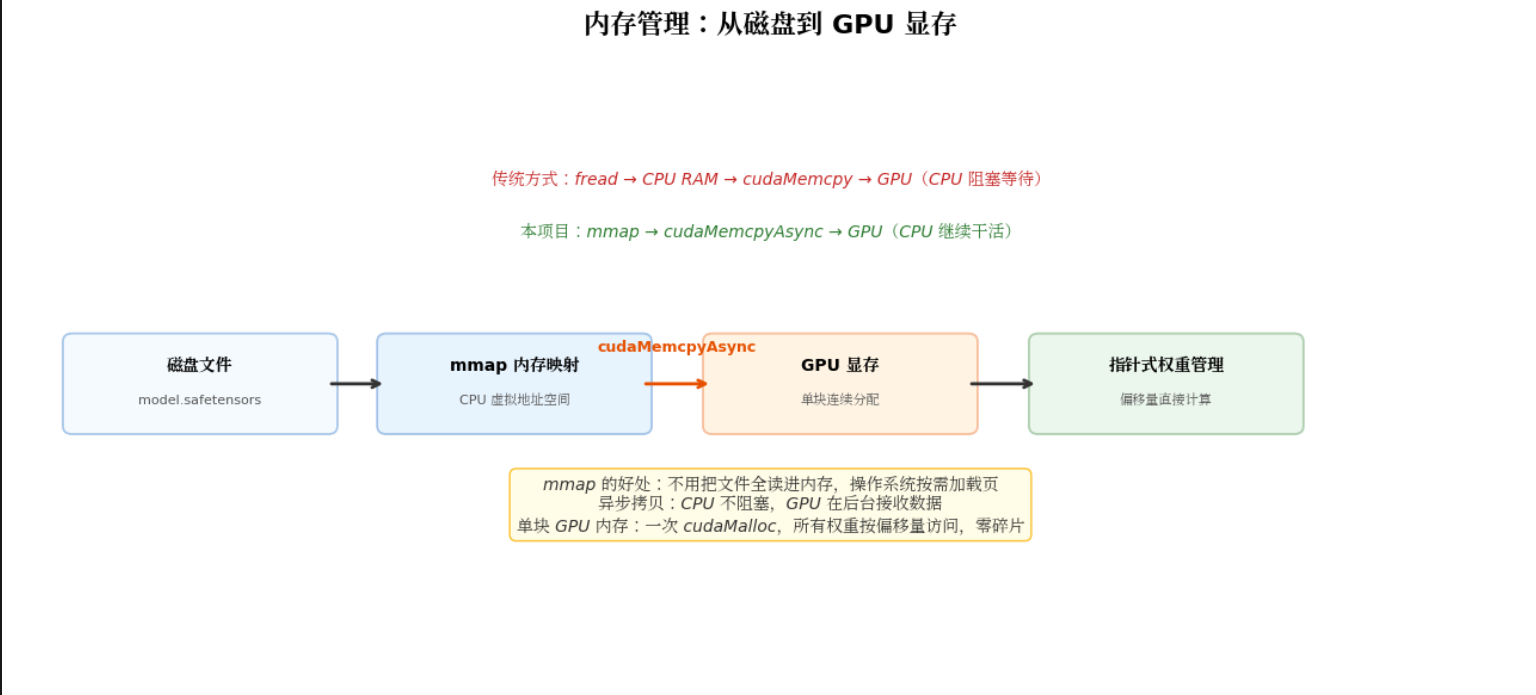
图3:推理流程
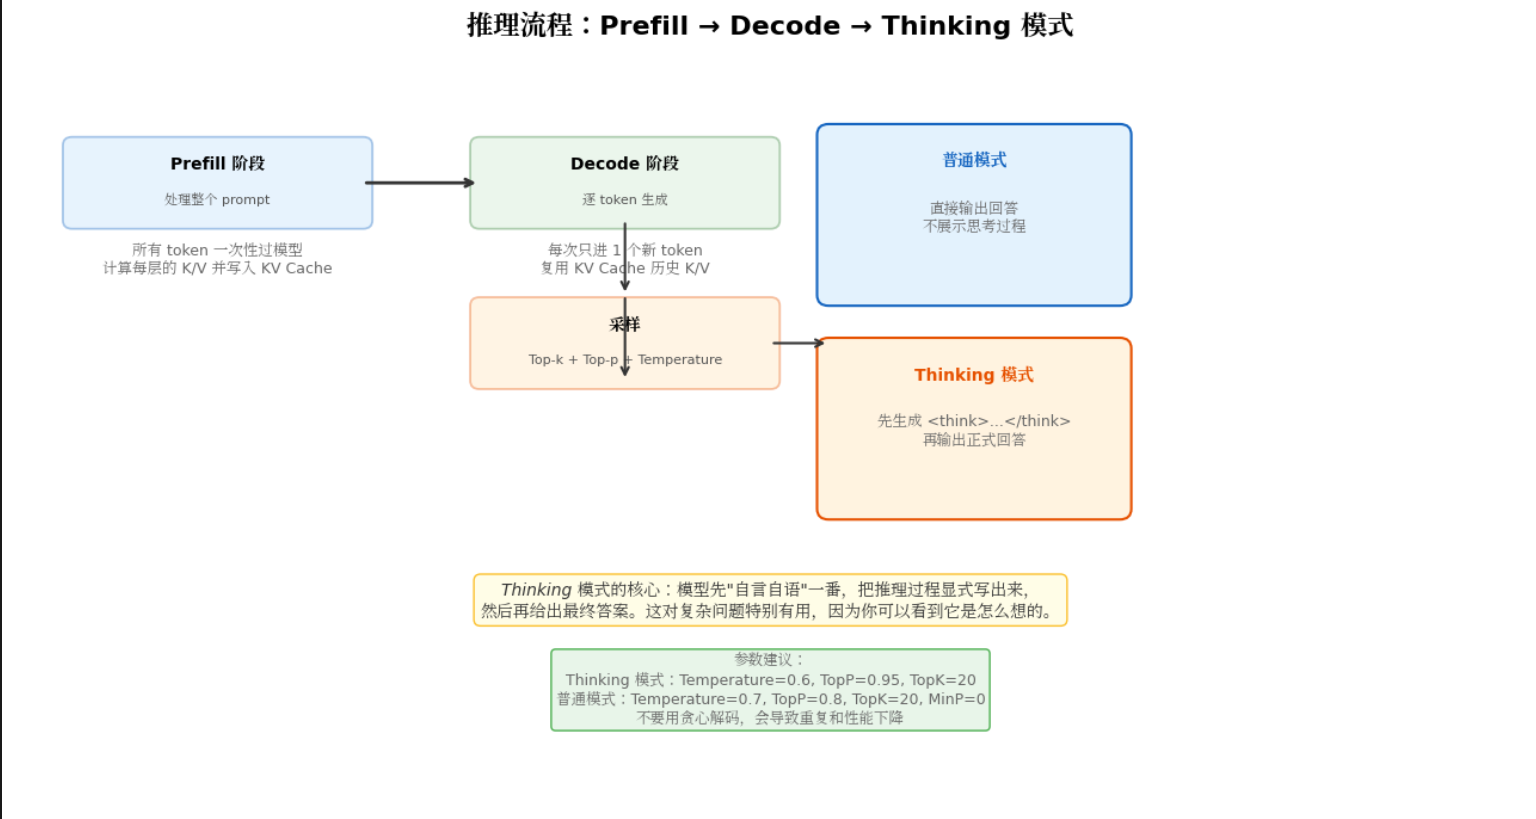
图4:性能对比
八、怎么跑起来?一步步来
1. 准备环境
硬件要求:
- NVIDIA GPU(RTX 3050 8GB 或更高,显存至少 4GB)
- CUDA 12.x 或 13.x
- cuBLAS 和 CUB(通常随 CUDA Toolkit 一起安装)
软件要求:
- GCC 9+ 或 Clang
- CMake 3.18+
- Python 3.8+(仅用于转换 tokenizer)
2. 下载模型
从 HuggingFace 下载 Qwen3-0.6B-Instruct:
# 安装 huggingface-cli
pip install huggingface-hub

# 登录(需要 HuggingFace token)
huggingface-cli login

# 下载模型
huggingface-cli download Qwen/Qwen3-0.6B-Instruct --local-dir ./qwen3-0.6b
下载完成后,检查权重文件的 SHA256:
sha256sum ./qwen3-0.6b/model.safetensors
# 输出应为:f47f71177f32bcd101b7573ec9171e6a57f4f4d31148d38e382306f42996874b
3. 转换 Tokenizer
cd qwen

# 转换 tokenizer 为二进制格式
python export.py ./qwen3-0.6b
这会生成:
tokenizer.bin:二进制格式的 tokenizertemplate_chat.txt:聊天模板template_default.txt:默认模板
4. 编译
mkdir build && cd build
cmake .. && make -j$(nproc)
编译要求:
nvcc能找到(nvcc --version检查)cuBLAS和CUB头文件在 include 路径里(通常 CUDA 安装后自动有)
5. 运行推理
查看帮助:
./qwen600
输出:
usage:   ./qwen <model_dir> [options]
example: ./qwen <model_dir> -r 1

arguments:
  -r <int>    reasoning mode, 0 = no thinking, 1 = thinking
  -s <int>    random seed
  -k <int>    top-k sampling, default 20
  -t <float>  temperature, default 0.6
  -p <float>  top-p sampling, default 0.95
  -i <string> input prompt
  -y <string> system prompt
普通模式(直接回答):
./qwen ./qwen3-0.6b -r 0
Thinking 模式(先思考再回答):
./qwen ./qwen3-0.6b -r 1 -t 0.65 -p 0.9 -k 20
带自定义 prompt:
./qwen ./qwen3-0.6b -r 1 -i "什么是量子计算?"
参数建议(来自官方模型卡):
- Thinking 模式:
Temperature=0.6, TopP=0.95, TopK=20 - 普通模式:
Temperature=0.7, TopP=0.8, TopK=20, MinP=0 - 不要用贪心解码(Temperature=0),会导致重复和性能下降
6. 运行示例
普通模式:
./qwen ./qwen3-0.6b -r 0

>> what is capital of Greece ?
The capital of Greece is Athens

[231.71 tk/s, 19 tokens in 0.08s]
Thinking 模式:
./qwen ./qwen3-0.6b -r 1

>> what are llms used for ?
Okay, the user is asking what LLMs are used for...
[思考过程输出]
...
Large Language Models (LLMs) are advanced AI systems...

[111.44 tk/s, 604 tokens in 5.42s]
7. 常见问题
- 编译报错找不到 CUDA:检查
nvcc和CMAKE_CUDA_COMPILER路径 - 显存不足:0.6B 模型 bf16 约需 1.2GB 显存,确保关闭其他 GPU 程序
- tokenizer 转换失败:检查
export.py的模型路径是否正确 - 生成结果重复:调高 Temperature,不要设成 0
- Thinking 模式没输出思考过程:确认
-r 1参数,且模型是 Instruct 版本
九、总结
这个项目最大的价值,是让你看到一个纯 CUDA 的推理引擎可以有多小、多快、多直白。
它用纯 CUDA C/C++ 实现了:
- bf16 推理(省显存、保精度)
- mmap + 异步拷贝(启动快、CPU 不阻塞)
- 单块 GPU 内存(零碎片、零开销指针管理)
- 手写 CUDA Kernel(RMSNorm、RoPE、Flash-Attention 风格分块)
- cuBLAS GEMM(矩阵乘法交给专家)
- Thinking 模式(Qwen3 特色,教育价值高)
在 RTX 3050 上跑到 116 token/秒,比 llama.cpp 快 8.5%,比 HuggingFace + Flash-Attention 快将近 4 倍。而且全部代码加起来可能就几千行,没有 PyTorch 的层层封装,没有 Python 的 GIL 瓶颈,每个 cudaMemcpyAsync、每个 __global__ Kernel 都清清楚楚。
如果你想真正理解"GPU 推理是怎么优化的",或者需要一个轻量、高性能、无冗余的 CUDA 推理方案,这个项目就是最好的起点。把代码通读一遍,亲手改改 block size、采样温度、模型配置,你会对 CUDA 和 Transformer 推理有一个完全不一样的体感。
Welcome to follow WeChat official account【程序猿编码】

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)