LangGraph 状态管理深度解析:Reducer、Annotation、Channel 是什么关系
上一篇我们拆解了 LangGraph 的底层原理,搞清楚它是怎么把 LLM 变成状态机的。今天要啃一块更硬的骨头——状态管理的三个核心概念:Reducer、Annotation、Channel,很多人用了半年还分不清楚它们的关系。
90% 的 LangGraph Bug,根源都在状态更新上。节点返回了值,状态却没变;并发执行时数据互相覆盖;消息列表越来越短……这些问题,你搞懂这三个概念,全能解决。
01 状态管理的核心问题
在开始之前,先问自己一个问题:节点返回的值,是怎么进入 State 的?
大多数人的直觉答案是"覆盖"——节点返回什么,State 就变成什么。
这个答案只对了一半。
LangGraph 的状态更新比这复杂得多。每个字段可以有自己的更新策略:有的字段用覆盖,有的字段用追加,有的字段用自定义合并逻辑。这套机制,就是今天的核心主题。
节点A返回 { messages: [新消息] } ↓ Channel 接收更新 ↓ Reducer 决定怎么合并 ↓ State 更新为最终值
整个链路:Node → Channel → Reducer → State。
02 Channel:State 的最小存储单元
Channel 是 LangGraph 状态管理的底层抽象。可以把它理解成 State 里每一个字段背后的"存储槽"。
每个 Channel 负责:
- 存储当前值
- 接收节点的更新
- 决定怎么把更新合并进去
┌─────────────────────────────────────────┐│ StateGraph ││ ││ ┌─────────┐ ┌─────────┐ ┌─────────┐ ││ │ Channel │ │ Channel │ │ Channel │ ││ │messages │ │ step │ │ result │ ││ │ [追加] │ │ [覆盖] │ │ [自定义]│ ││ └─────────┘ └─────────┘ └─────────┘ ││ ↑ ↑ ↑ ││ └─────────────┴────────────┘ ││ 节点写入 │└─────────────────────────────────────────┘
Channel 有两种内置类型:
| Channel 类型 | 行为 | 适用场景 |
|---|---|---|
| LastValue | 新值覆盖旧值 | 单值字段,如当前步骤、状态标志 |
| BinaryOperator | 用 Reducer 函数合并 | 列表、计数器、需要累积的字段 |
在 LangGraph.js 里,你不会直接操作 Channel 对象,而是通过 Annotation 来声明它。
03 Annotation:声明 Channel 的语法糖
Annotation 是用来声明 Channel 的高级 API。它把"这个字段存什么类型""用什么 Reducer 合并"打包成一个整洁的声明。
import { Annotation } from"@langchain/langgraph";import { BaseMessage } from"@langchain/core/messages";// 写法1:简单声明,等价于 LastValue Channel// 节点更新时,直接覆盖constSimpleAnnotation = Annotation.Root({currentStep: Annotation<string>, // 覆盖语义isFinished: Annotation<boolean>, // 覆盖语义});// 写法2:带 Reducer 的声明,等价于 BinaryOperator Channel// 节点更新时,调用 reducer 合并constWithReducerAnnotation = Annotation.Root({messages: Annotation<BaseMessage[]>({ reducer: (existing, incoming) => existing.concat(incoming), default: () => [], }),});
注意 Annotation.Root 的作用:它把一组字段打包成完整的状态 Schema,这个 Schema 直接传给 StateGraph。
Annotation<T> → 声明单个 ChannelAnnotation<T>({...}) → 声明带 Reducer 的 ChannelAnnotation.Root({}) → 把多个 Channel 组合成完整 State Schema
04 Reducer:合并逻辑的核心
Reducer 是一个纯函数,签名固定:
type Reducer<T> = (existing: T, incoming: T) => T;
existing:当前 Channel 存储的值incoming:节点返回的新值- 返回值:合并后的最终值
最典型的例子是消息列表:
import { Annotation } from"@langchain/langgraph";import { BaseMessage } from"@langchain/core/messages";constMessagesState = Annotation.Root({messages: Annotation<BaseMessage[]>({ // 追加语义:新消息加到末尾 reducer: (existing: BaseMessage[], incoming: BaseMessage | BaseMessage[]) => { if (Array.isArray(incoming)) { return existing.concat(incoming); } return existing.concat([incoming]); }, default: () => [], // 初始值 }),});
Reducer 的三种常见模式:
// 模式1:追加(列表累积)reducer: (prev, next) => [...prev, ...next]// 模式2:合并(对象合并)reducer: (prev, next) => ({ ...prev, ...next })// 模式3:计数(累加)reducer: (prev, next) => prev + next
如果不指定 Reducer,LangGraph 默认用覆盖语义——这是 90% 初学者踩坑的地方。
05 MessagesAnnotation:内置的消息 Reducer
处理对话历史太常见了,LangGraph 直接内置了 MessagesAnnotation:
import { StateGraph, MessagesAnnotation } from"@langchain/langgraph";import { HumanMessage, AIMessage } from"@langchain/core/messages";// MessagesAnnotation 等价于:// Annotation.Root({// messages: Annotation<BaseMessage[]>({// reducer: messagesStateReducer, // 内置 reducer,支持追加和按 ID 更新// default: () => [],// })// })const graph = newStateGraph(MessagesAnnotation) .addNode("agent", async (state) => { const lastMsg = state.messages[state.messages.length - 1]; return { messages: [newAIMessage(`你说的是: ${lastMsg.content}`)], }; }) .addEdge("__start__", "agent") .addEdge("agent", "__end__") .compile();const result = await graph.invoke({messages: [newHumanMessage("你好")],});// result.messages = [HumanMessage("你好"), AIMessage("你说的是: 你好")]// 注意:消息被追加,不是覆盖
messagesStateReducer 比普通 concat 更聪明,它还支持按 message id 更新已有消息:
新消息没有 id 重复 → 追加到列表末尾新消息 id 与已有消息重复 → 替换对应消息(用于修改历史)
``````plaintext
初始: [HumanMsg(id=1), AIMsg(id=2)]         ↓节点返回: [AIMsg(id=2, content="修改版")]         ↓结果:  [HumanMsg(id=1), AIMsg(id=2, content="修改版")]                         ↑ 被替换,不是追加
06 自定义复杂状态:组合多种 Reducer
真实项目里,State 通常有多个字段,每个字段的更新语义不同:
import { Annotation } from"@langchain/langgraph";import { BaseMessage } from"@langchain/core/messages";// 复杂 Agent 的状态定义constAgentState = Annotation.Root({// 对话历史:追加语义messages: Annotation<BaseMessage[]>({    reducer: (prev, next) =>      Array.isArray(next) ? prev.concat(next) : prev.concat([next]),    default: () => [],  }),// 当前步骤:覆盖语义(不需要 reducer)currentStep: Annotation<string>,// 工具调用次数:累加语义toolCallCount: Annotation<number>({    reducer: (prev, next) => prev + next,    default: () =>0,  }),// 搜索结果:追加语义(去重)searchResults: Annotation<string[]>({    reducer: (prev, next) => {      const combined = [...prev, ...next];      return [...newSet(combined)];  // 去重    },    default: () => [],  }),// 最终答案:覆盖语义(最后写入的获胜)finalAnswer: Annotation<string>,});// 使用类型推断typeAgentStateType = typeofAgentState.State;asyncfunctionsearchNode(state: AgentStateType) {// 模拟搜索const results = ["结果1", "结果2"];return {    searchResults: results,   // 追加进去,不覆盖    toolCallCount: 1,         // +1,不覆盖    currentStep: "search",    // 覆盖  };}asyncfunctionanswerNode(state: AgentStateType) {const context = state.searchResults.join("\n");return {    finalAnswer: `基于搜索结果:${context}`,    currentStep: "done",  };}
``````plaintext
State 快照:┌────────────────────────────────────────┐│ messages:      [HumanMsg, AIMsg, ...]  │ ← concat reducer│ currentStep:   "search"                │ ← 覆盖│ toolCallCount: 3                       │ ← 累加 reducer│ searchResults: ["r1","r2","r3"]        │ ← 去重 concat│ finalAnswer:   "基于搜索结果..."        │ ← 覆盖└────────────────────────────────────────┘
07 并发节点的状态合并
这是 Reducer 最关键的应用场景——多个节点并行执行时,状态如何合并?
import { StateGraph, Annotation, START, END } from"@langchain/langgraph";constParallelState = Annotation.Root({query: Annotation<string>,// 两个节点并行写入,结果需要合并partialResults: Annotation<string[]>({    reducer: (prev, next) => prev.concat(next),    default: () => [],  }),});const graph = newStateGraph(ParallelState)// 两个节点并行执行  .addNode("searchA", async (state) => ({    partialResults: [`来自搜索引擎A的结果: ${state.query}`],  }))  .addNode("searchB", async (state) => ({    partialResults: [`来自数据库B的结果: ${state.query}`],  }))  .addNode("merge", async (state) => {    console.log("合并后的结果:", state.partialResults);    // partialResults 已经被 Reducer 合并好了    return {};  })// searchA 和 searchB 并行  .addEdge(START, "searchA")  .addEdge(START, "searchB")// 两者都完成后才进入 merge  .addEdge(["searchA", "searchB"], "merge")  .addEdge("merge", END)  .compile();const result = await graph.invoke({ query: "TypeScript 最佳实践" });// partialResults: ["来自搜索引擎A的结果:...", "来自数据库B的结果:..."]
``````plaintext
并行执行流程:START  ├──→ searchA → partialResults: ["A结果"]  └──→ searchB → partialResults: ["B结果"]         ↓   Reducer 合并两次写入         ↓  partialResults: ["A结果", "B结果"]         ↓      merge 节点
如果 partialResults 没有 Reducer,并行节点写入时只有一个会生效——后写入的覆盖先写入的,数据直接丢失。
08 常见坑与自查清单
坑1:忘了加 Reducer,列表变单元素
// ❌ 错误:没有 Reducer,每次覆盖constBadState = Annotation.Root({results: Annotation<string[]>, // 只存最新一个节点的结果});// ✅ 正确:加 Reducer,追加constGoodState = Annotation.Root({results: Annotation<string[]>({ reducer: (prev, next) => prev.concat(next), default: () => [], }),});
坑2:Reducer 里修改了 existing,引发难以追踪的 Bug
// ❌ 错误:直接 push 修改了原数组reducer: (existing, incoming) => { existing.push(...incoming); // 危险!直接修改引用 return existing;}// ✅ 正确:返回新数组reducer: (existing, incoming) => [...existing, ...incoming]
坑3:并行节点没有 Reducer,数据随机丢失
并行节点的写入顺序不确定,没有 Reducer 的字段只会保留一个节点的结果。在并行场景里,任何需要合并的字段都必须有 Reducer。
坑4:default 没有设置,初次 invoke 报错
// ❌ 没有 default,第一次 invoke 时 existing 是 undefinedAnnotation<string[]>({ reducer: (existing, incoming) => existing.concat(incoming),})// ✅ 加上 defaultAnnotation<string[]>({ reducer: (existing, incoming) => existing.concat(incoming), default: () => [], // 必须是工厂函数,不能是 []})
自查清单:
- 需要累积的字段是否都加了 Reducer?
- Reducer 里是否没有直接修改 existing?
- 有 Reducer 的字段是否都有 default 工厂函数?
- 并行节点共同写入的字段是否都有合并 Reducer?
- 对话历史是否用了 MessagesAnnotation 或等效实现?
总结
这篇我们把 LangGraph 状态管理的三层结构彻底拆开讲透:
- Channel 是底层存储单元:每个 State 字段背后都是一个 Channel,分 LastValue(覆盖)和 BinaryOperator(Reducer 合并)两种
- Annotation 是声明 Channel 的 API:
Annotation<T>声明覆盖字段,Annotation<T>({reducer, default})声明需要合并的字段,Annotation.Root把多个字段组合成完整 Schema - Reducer 决定合并逻辑:纯函数
(existing, incoming) => merged,追加/覆盖/去重/累加都能实现 - MessagesAnnotation 是最佳实践:对话类 Agent 直接用,内置 ID 去重和追加逻辑
- 并发场景必须有 Reducer:并行节点写同一字段时,没有 Reducer 数据会随机丢失,这是生产环境最隐蔽的 Bug
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
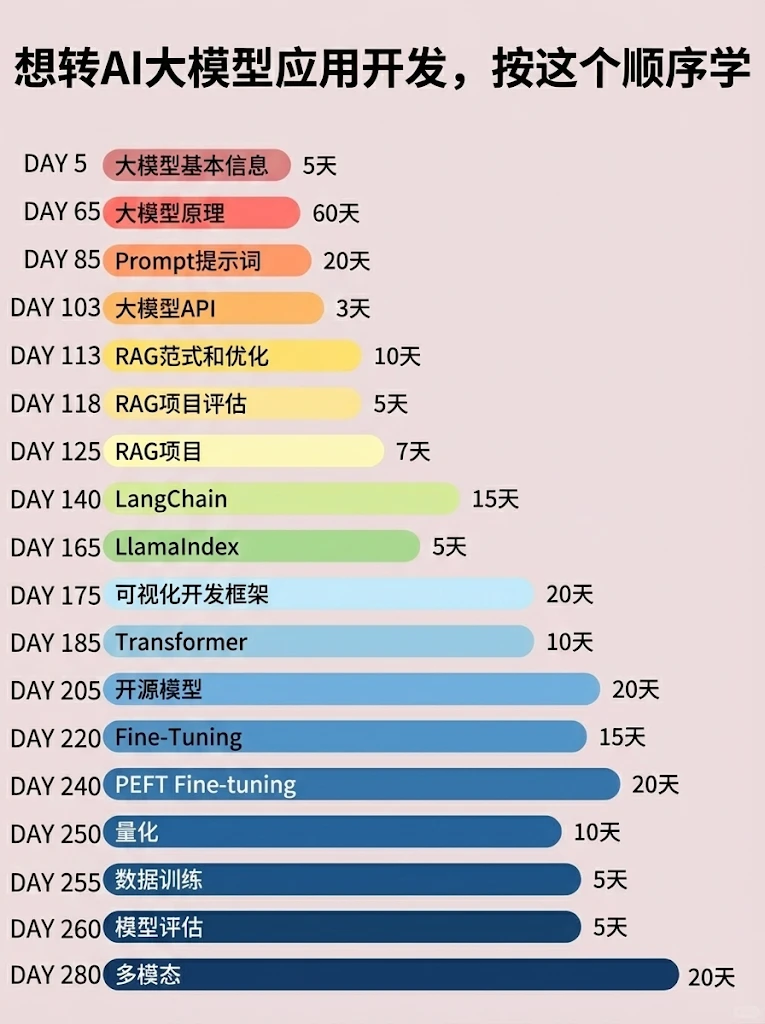
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 9
 0
- 0


 已为社区贡献21条内容

所有评论(0)