登录社区云,与社区用户共同成长
邀请您加入社区
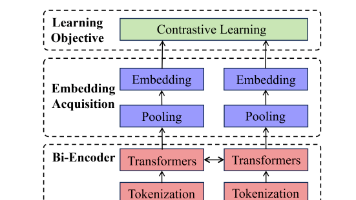
文本嵌入(Text Embedding)几乎贯穿了所有 NLP 任务:检索、分类、聚类、问答、摘要……随着 BERT、T5、LLaMA/Qwen3 等预训练语言模型(PLM) 的出现,文本嵌入进入了“通用+可迁移”时代。
文本分类实践:从数据探索到方案对比 本文探讨了文本分类在实际场景中的应用及两种实现方案。文本分类广泛应用于内容平台分类、电商评论分析、风控合规等领域,核心价值在于自动化处理海量文本数据。实验基于CLUE/TNEWS数据集展开,分析显示数据存在类别不均衡(23倍差异)、文本短(平均22字)等特点。 方案一测试了调用DeepSeek-V4大模型API的效果,结果显示:DeepSeek-V4-Pro零样
LLaMA | Decoder-only | 下一个词预测 | 和 GPT 类似,偏生成、推理、私有化 || GPT | Decoder-only | 下一个词预测 | 对话、写作、代码、生成 || BERT | Encoder-only | 掩码预测 | 分类、匹配、抽取、检索 |- LLaMA:本质上也是 GPT 这一路,只是是一个重要的开源/开放权重模型家族。- LLaMA:GPT 路线里的
训练方式|Masked Language Model (MLM)、Next Sentence Prediction (NSP)|自回归语言模型训练 (Autoregressive Language Modeling)||适用任务|文本理解任务(如文本分类、问答、NER等)|文本生成任务(如文章生成、对话生成、编程等)||模型规模|相对较小(如BERT-base,110M参数)|超大规模(如GPT-