Nano-VLLM全代码解析笔记(12)-Gated Delta Rule
前言
本节参考资料:
我的代码仓库(迭代更新ing)
WilliamPockey/Nano-Vllm-Qwen-Fit
TODO LIST
(已完成)Qwen3.5架构介绍
(已完成)GemmaRMSNorm和MRoPE
(正在完成)QKVParallelLinear和GDN线性注意力层
(待完成)多模态支持(视觉塔/多模态预处理/多模态条件生成类/权重加载)
(待完成)引擎(LLMEngine/Sequence/Scheduler/ModelRunner)修改
(待完成)MTP支持
(待完成)流式输出与多请求支持
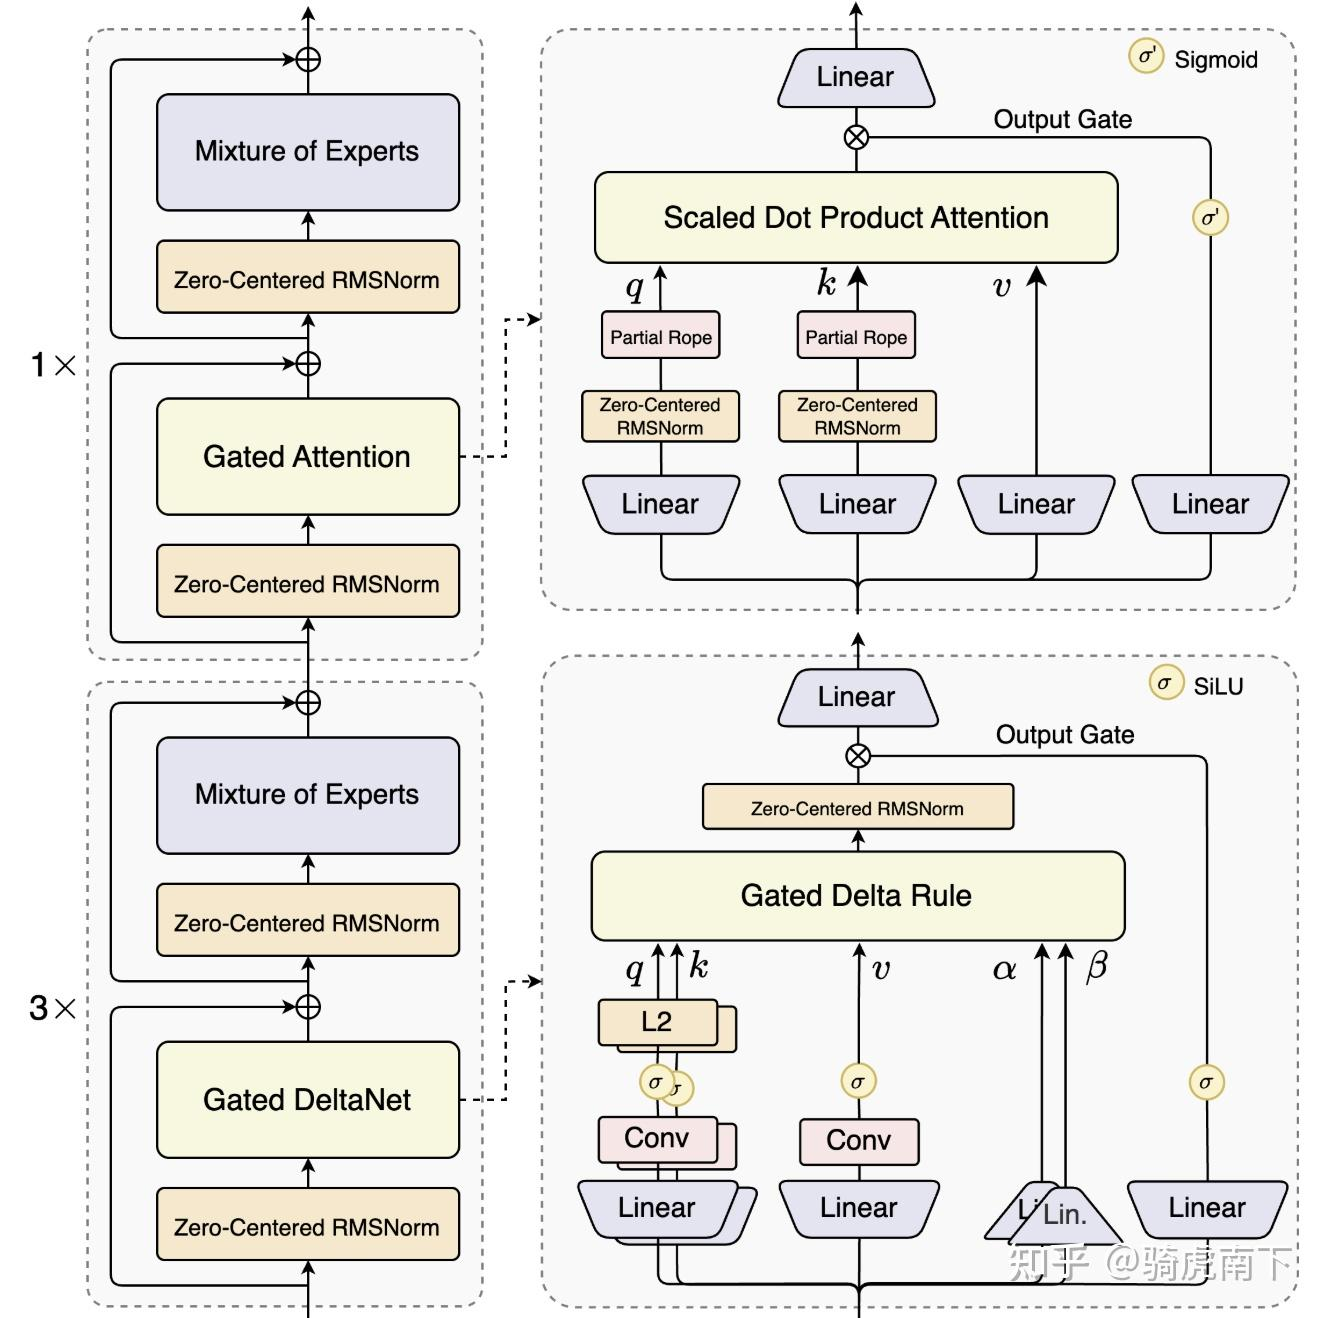
Qwen3.5架构图(图来自知乎骑虎难下)
本节修改的代码
gdn_attention.py(补齐prefill和decode的Gated DeltaRule)
Qwen3.5在线性注意力的基础上还引入了Gated DeltaRule,以解决联想记忆擦除与更新的问题
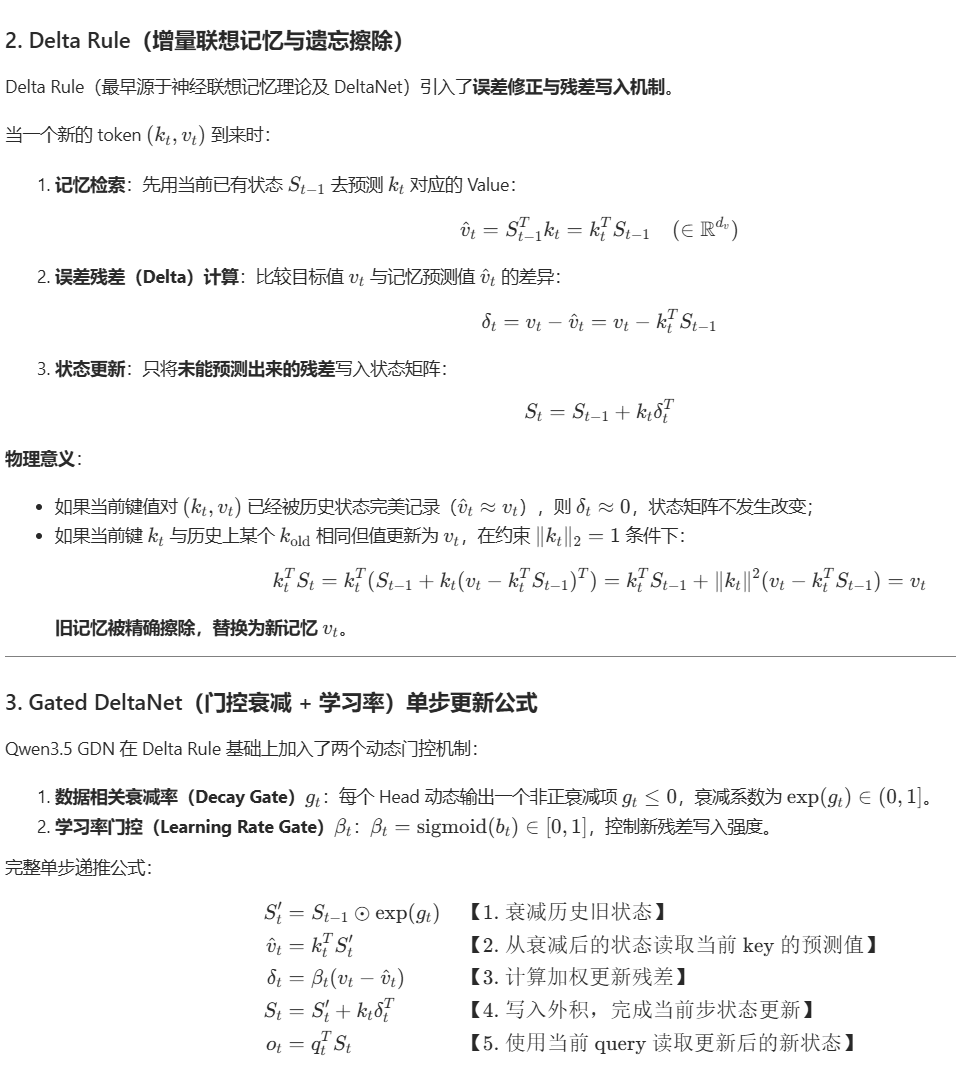
GDN模块的Gated Delta Rule的具体变换如下(图来自知乎骑虎难下)
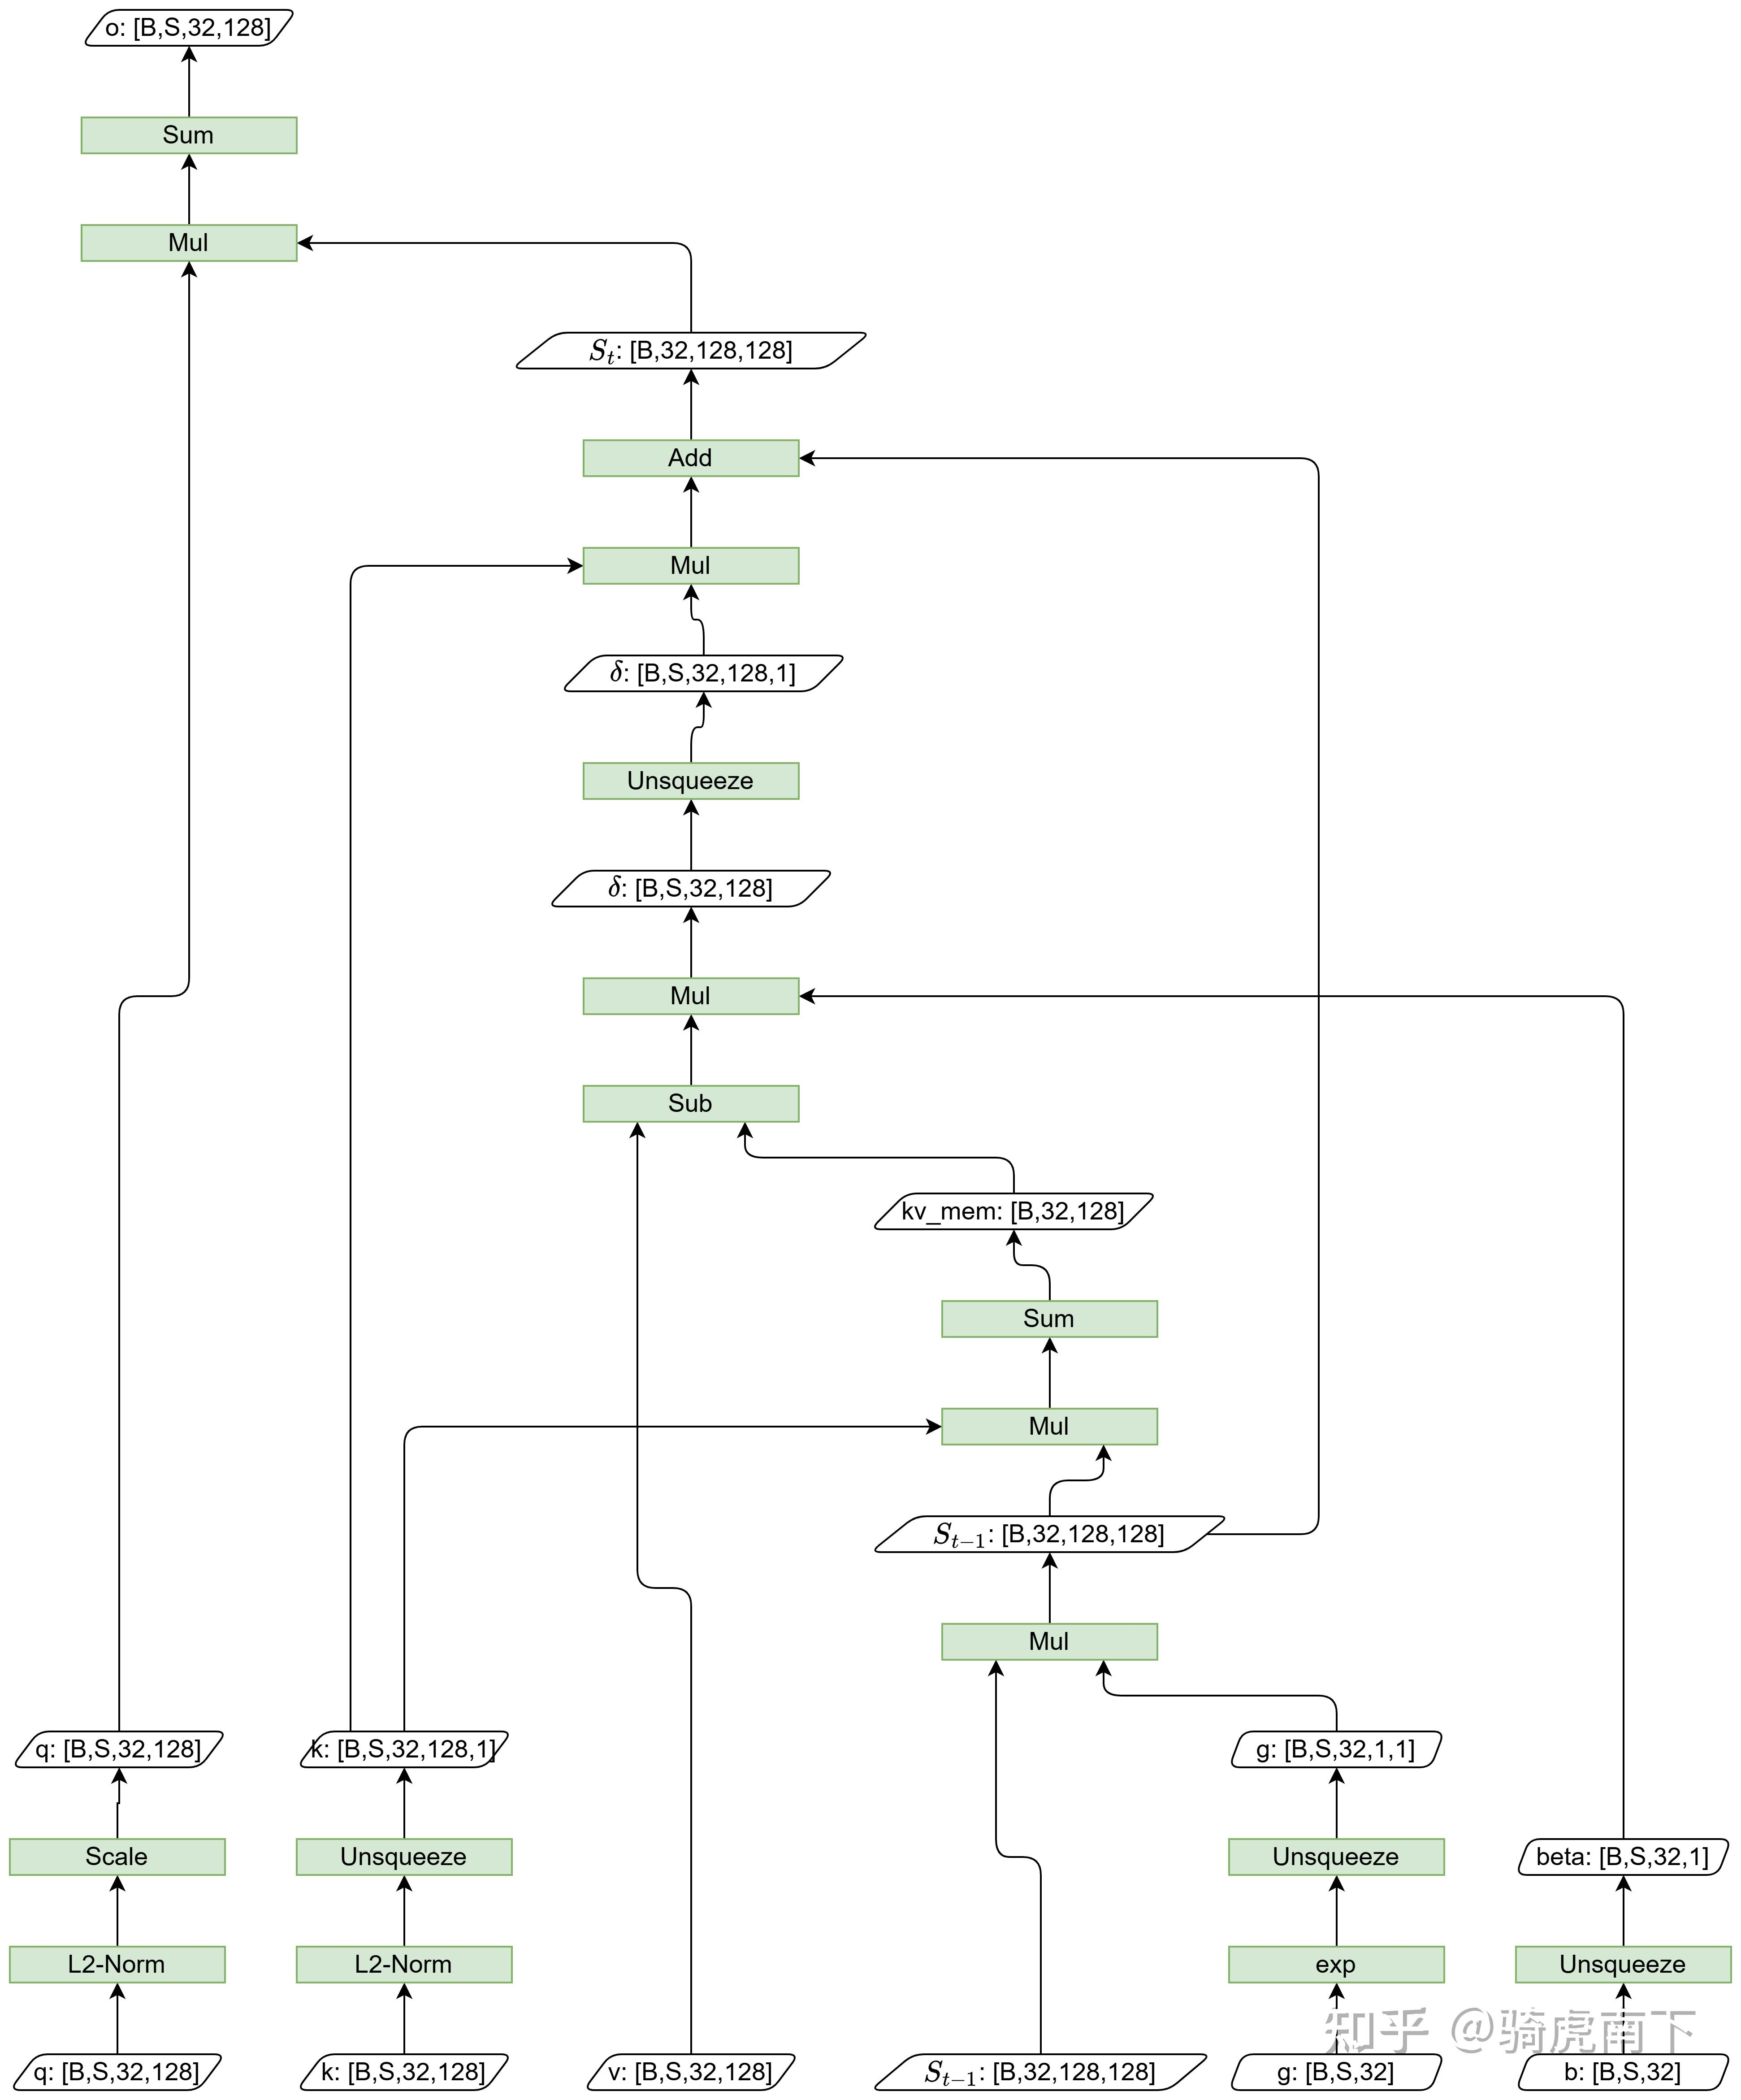
Gated Delta Rule代码实现(Decode和Prefill)
Decode
没什么好说的,就是实现上面第二张图的流程,唯一值得注意的就是for循环这里decode阶段sequence_length=1
def torch_recurrent_gated_delta_rule(
    query: torch.Tensor,       # [B, T, H_k, D_k]
    key: torch.Tensor,         # [B, T, H_k, D_k]
    value: torch.Tensor,       # [B, T, H_v, D_v]
    g: torch.Tensor,           # [B, T, H_v] 衰减门控
    beta: torch.Tensor,        # [B, T, H_v] 学习率门控
    initial_state: torch.Tensor | None = None, # [B, H_v, D_k, D_v]
    output_final_state: bool = False,
    use_qk_l2norm_in_kernel: bool = False,
):
    initial_dtype = query.dtype
    batch_size, sequence_length, _, k_head_dim = key.shape
    num_v_heads, v_head_dim = value.shape[-2:]
    decay = g

    # 统一转为 fp32 保证数值稳定性,并转置为 [B, H, T, D]
    query, key, value, beta, decay = [
        x.transpose(1, 2).to(torch.float32, memory_format=torch.contiguous_format)
        for x in (query, key, value, beta, decay)
    ]
    if use_qk_l2norm_in_kernel:
        query = l2norm(query, dim=-1, eps=1e-6)
        key = l2norm(key, dim=-1, eps=1e-6)
    # scaling 作用于 query
    query = query / (query.shape[-1] ** 0.5)

    if initial_state is None:
        recurrent_state_shape = (batch_size, num_v_heads, k_head_dim, v_head_dim)
        last_recurrent_state = torch.zeros(recurrent_state_shape, dtype=value.dtype, device=value.device)
    else:
        # 等价于.to(dtype=value.dtype, device=value.device)
        last_recurrent_state = initial_state.to(value)
    core_attn_out = torch.zeros_like(value)

    # 逐时间步递推(Decode 阶段 sequence_length == 1,只循环 1 次)
    for i in range(sequence_length):
        q_t, k_t, v_t = query[:, :, i], key[:, :, i], value[:, :, i]  # [B, H, D]

        # 1. 衰减旧状态: S' = S_{t-1} * exp(g_t)
        #None表示拓展维度
        decay_t = decay[:, :, i].exp()[..., None, None]                # [B, H, 1, 1]
        last_recurrent_state = last_recurrent_state * decay_t

        # 2. 从状态中检索已有记忆: kv_mem = k_t^T @ S'
        # last_recurrent_state: [B, H, D_k, D_v], k_t.unsqueeze(-1): [B, H, D_k, 1]
        # 在 dim=-2 (D_k 维) 求和得到预测值: [B, H, D_v]
        kv_mem = (last_recurrent_state * k_t.unsqueeze(-1)).sum(dim=-2)

        # 3. 计算残差 delta: delta = (v_t - kv_mem) * beta_t
        beta_t = beta[:, :, i].unsqueeze(-1)                           # [B, H, 1]
        delta = (v_t - kv_mem) * beta_t                                # [B, H, D_v]

        # 4. 外积写入新状态: S_t = S' + k_t @ delta^T
        # k_t.unsqueeze(-1) [B, H, D_k, 1] * delta.unsqueeze(-2) [B, H, 1, D_v] -> [B, H, D_k, D_v]
        last_recurrent_state = last_recurrent_state + k_t.unsqueeze(-1) * delta.unsqueeze(-2)

        # 5. 用当前 query 读取新状态: o_t = q_t^T @ S_t
        # 这里core_attn_out维度是[B, H_v, T, D_v]
        core_attn_out[:, :, i] = (last_recurrent_state * q_t.unsqueeze(-1)).sum(dim=-2)

    last_recurrent_state = None if not output_final_state else last_recurrent_state
    core_attn_out = core_attn_out.transpose(1, 2).contiguous().to(initial_dtype)
    return core_attn_out, last_recurrent_state
Prefill(高难警告⚠!)
Prefill阶段如果按token逐个执行Gated DeltaNet的更新公式,效率会很低,因此这里使用了分块解法,如下(推导和对应的代码都比较难,可以当参考):
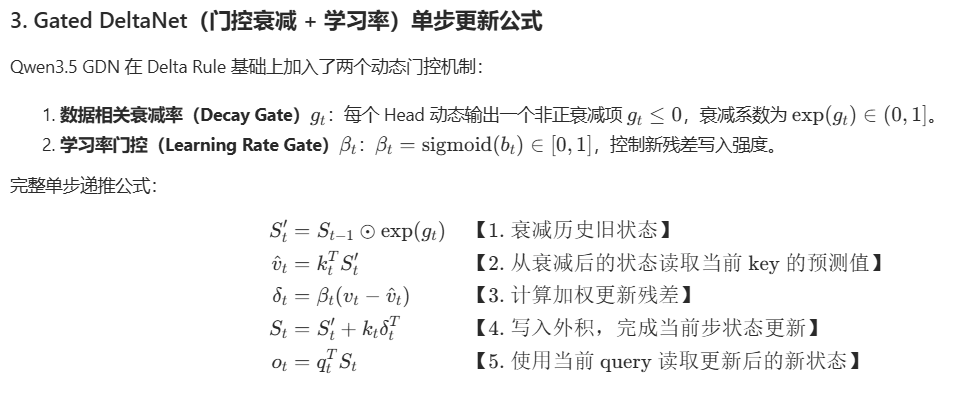
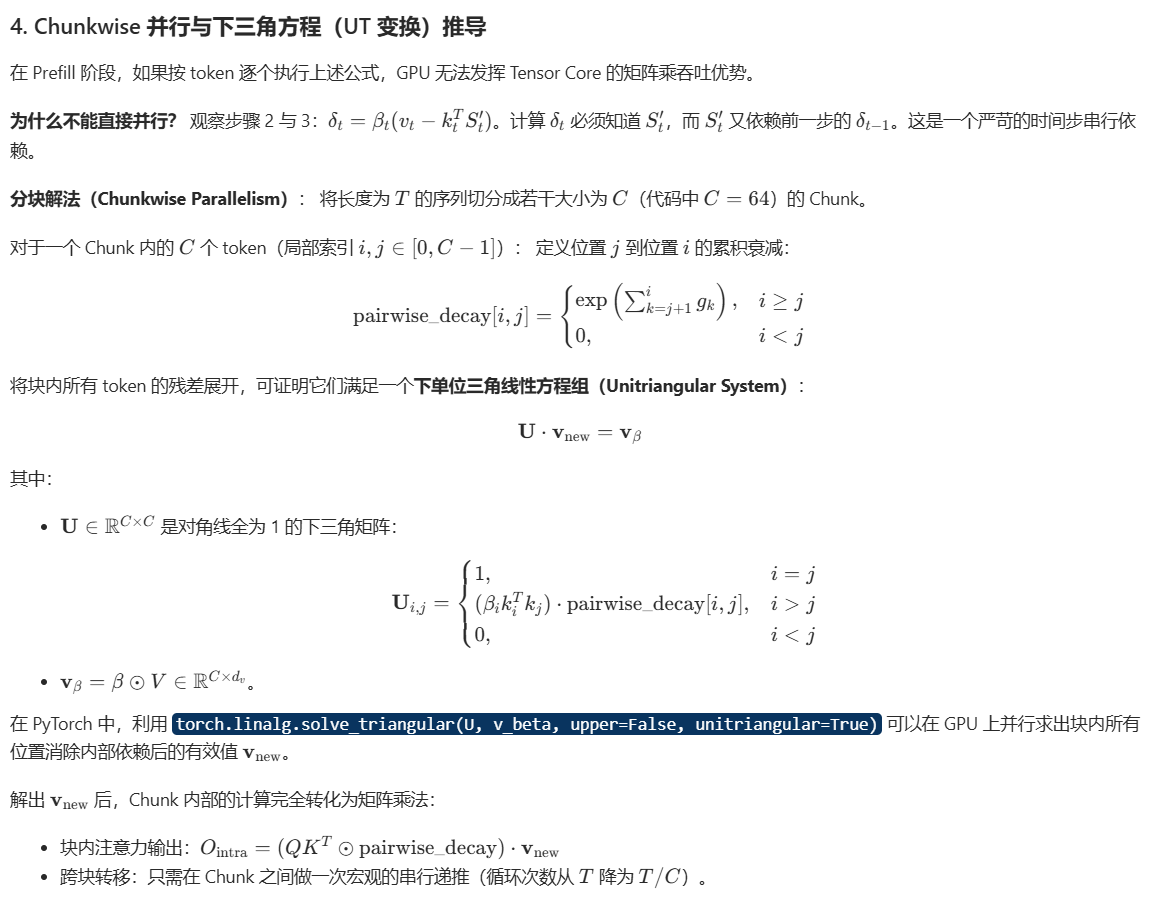
这里中间残差展开证明过程如下:
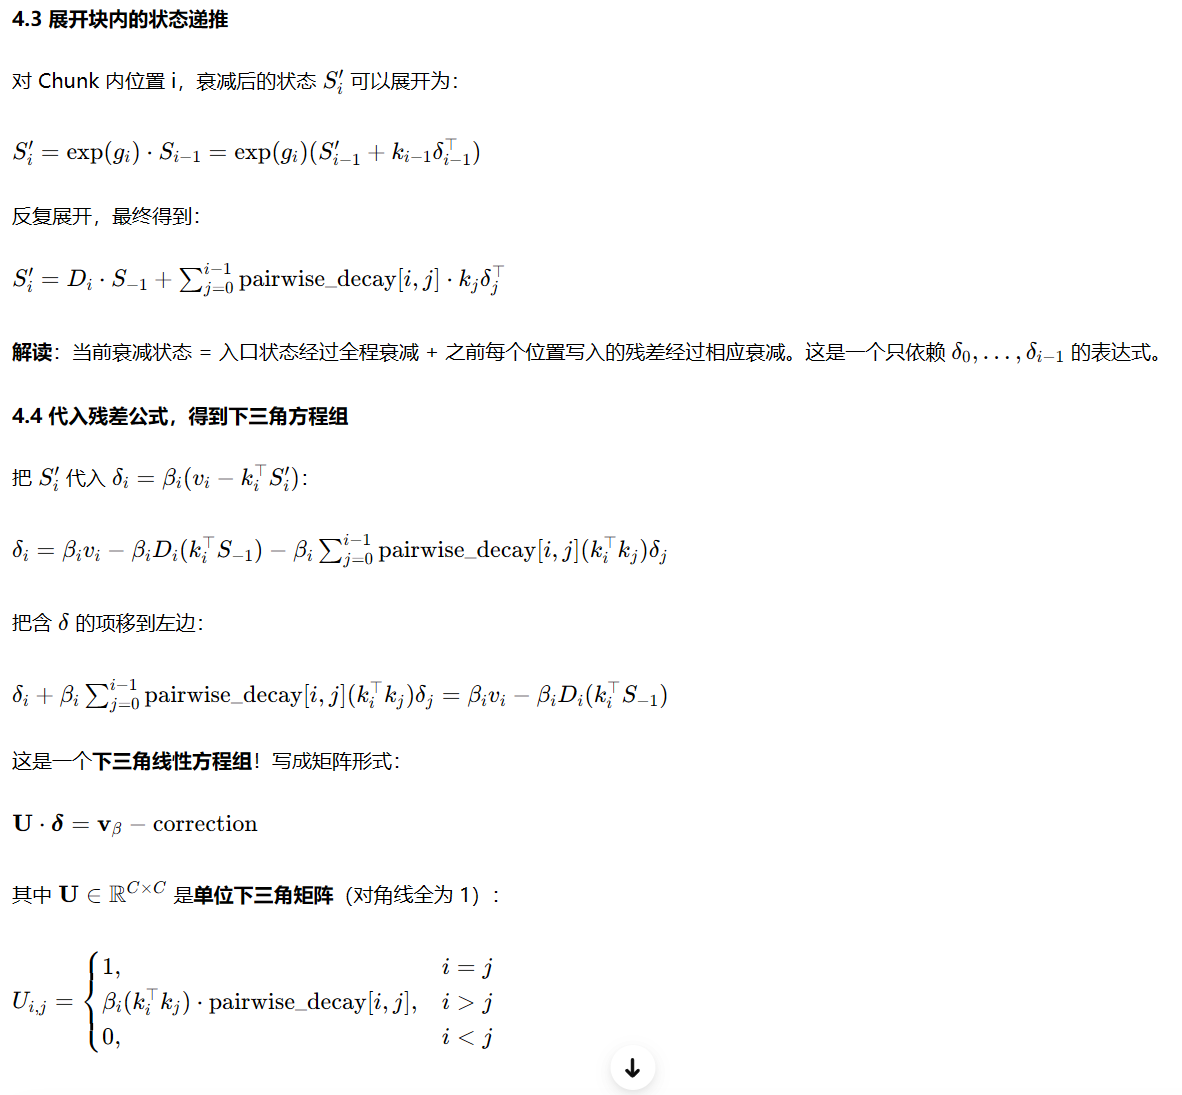
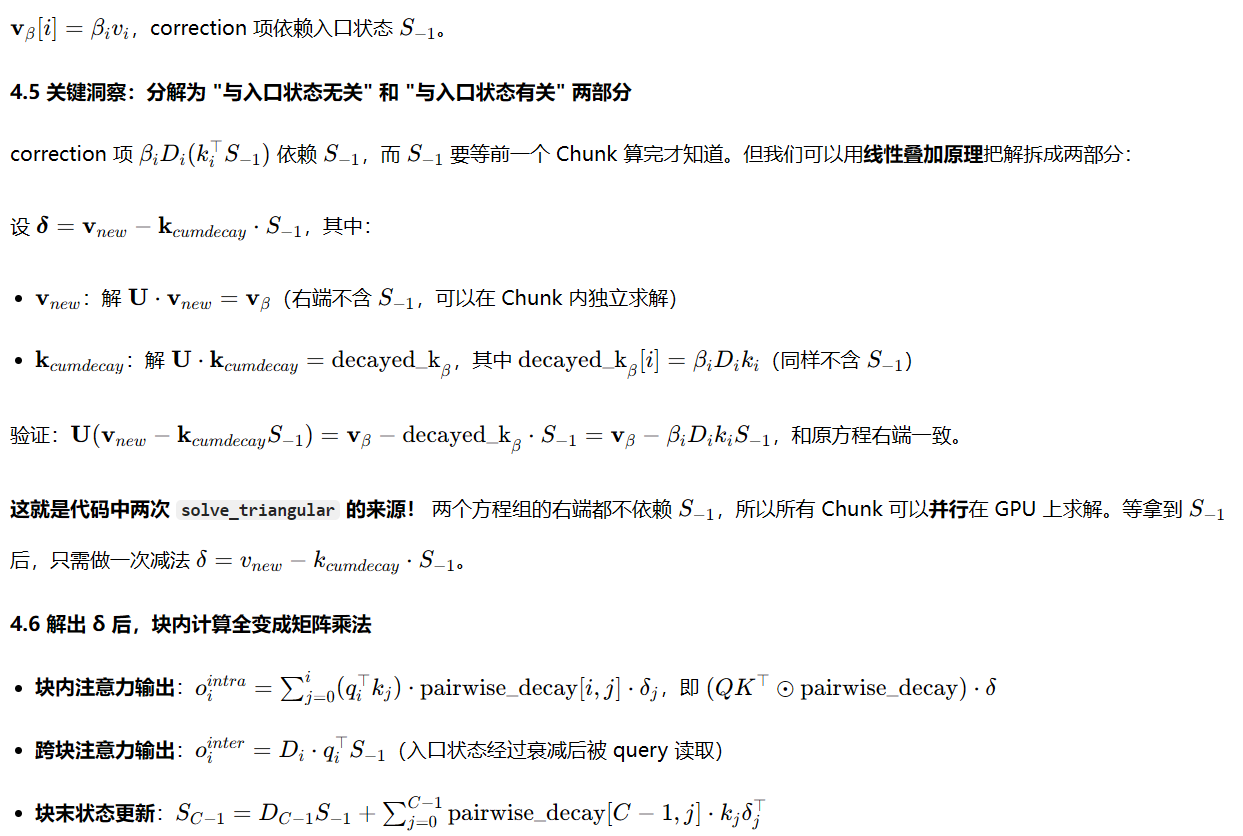
代码实现如下
def torch_chunk_gated_delta_rule(
    query: torch.Tensor, # [B, T, H_k, D_k]
    key: torch.Tensor, # [B, T, H_k, D_k]
    value: torch.Tensor,# [B, T, H_v, D_v]
    g: torch.Tensor, # [B, T, H_v] 衰减门控
    beta: torch.Tensor,# [B, T, H_v] 学习率门控
    chunk_size: int = 64,
    initial_state: torch.Tensor | None = None,# [B, H_v, D_k, D_v]
    output_final_state: bool = False,
    use_qk_l2norm_in_kernel: bool = False,
):
    # 1. 维度准备与 Padding 到 chunk_size 的整数倍
    initial_dtype = query.dtype
    batch_size, sequence_length, _, k_head_dim = key.shape
    num_v_heads, v_head_dim = value.shape[-2:]
    recurrent_state_shape = (batch_size, num_v_heads, k_head_dim, v_head_dim)
    padded_output_shape = (batch_size, num_v_heads, -1, v_head_dim)
    decay = g

    # 统一转为 fp32 保证数值稳定性,并转置为 [B, H, T, D]
    query, key, value, beta, decay = [
        x.transpose(1, 2).to(torch.float32, memory_format=torch.contiguous_format)
        for x in (query, key, value, beta, decay)
    ]
    if use_qk_l2norm_in_kernel:
        query = l2norm(query, dim=-1, eps=1e-6)
        key = l2norm(key, dim=-1, eps=1e-6)
    scaling = query.shape[-1] ** -0.5
    query = query * scaling

    pad_size = (chunk_size - sequence_length % chunk_size) % chunk_size
    # pad元组的长度必须是偶数,并且它指定了从最后一个维度开始往前每个维度两侧的填充数量。
    # 格式为:(left, right, top, bottom, front, back, ...)
    # 顺序是 从最后一个维度开始往前:
    # 最后一维:(left, right)
    # 倒数第二维:(top, bottom)
    # 倒数第三维:(front, back)
    query, key, value = (F.pad(x, (0, 0, 0, pad_size)) for x in (query, key, value))
    beta, decay = (F.pad(x, (0, pad_size)) for x in (beta, decay))

    total_sequence_length = sequence_length + pad_size
    num_chunks = total_sequence_length // chunk_size

    # 2. Reshape 为 [B, H, num_chunks, chunk_size, D]
    v_beta = value * beta.unsqueeze(-1)
    k_beta = key * beta.unsqueeze(-1)
    # [B, H, num_chunks, chunk_size, D]
    query, key, k_beta, v_beta = [
        x.reshape(x.shape[0], x.shape[1], -1, chunk_size, x.shape[-1])
        for x in (query, key, k_beta, v_beta)
    ]
    #[B, H, num_chunks, chunk_size]
    decay = decay.reshape(decay.shape[0], decay.shape[1], -1, chunk_size)

    # 3. 构造下三角系统与累积衰减矩阵
    strictly_upper_mask = torch.ones(chunk_size, chunk_size, dtype=torch.bool, device=query.device).triu(1)
    #含义:cum_decay[i] = 从 chunk 开头到第 i 个位置的衰减累积值。
    cum_decay = decay.cumsum(dim=3)
    #cum_decay.unsqueeze(4) → [B, H, num_chunks, chunk_size, 1]
    #cum_decay.unsqueeze(3) → [B, H, num_chunks, 1, chunk_size]
    # pairwise_decay[i, j] = exp(cum[i] - cum[j])
    pairwise_decay = cum_decay.unsqueeze(4) - cum_decay.unsqueeze(3)
    pairwise_decay = pairwise_decay.masked_fill(strictly_upper_mask, float("-inf")).exp()

    #k_beta: [B, H, num_chunks, chunk_size, D]
    #key.transpose(-1,-2): [B, H, num_chunks, D, chunk_size]
    #ut_system: [B, H, num_chunks, chunk_size, chunk_size]
    ut_system = (k_beta @ key.transpose(-1, -2)) * pairwise_decay

    #intra_chunk_attn: [B, H, num_chunks, chunk_size, chunk_size]
    intra_chunk_attn = (query @ key.transpose(-1, -2)) * pairwise_decay

    #decayed_k_beta: [B, H, num_chunks, chunk_size, 1]
    decayed_k_beta = k_beta * cum_decay.exp().unsqueeze(-1)

    # 4. UT 变换:求解下单位三角方程组,解出消除块内依赖后的有效输入
    new_values = torch.linalg.solve_triangular(ut_system, v_beta, upper=False, unitriangular=True)
    k_cumdecay = torch.linalg.solve_triangular(ut_system, decayed_k_beta, upper=False, unitriangular=True)

    if initial_state is None:
        last_recurrent_state = torch.zeros(recurrent_state_shape, dtype=new_values.dtype, device=new_values.device)
    else:
        last_recurrent_state = initial_state.to(new_values)
    core_attn_out = torch.zeros_like(new_values)

    #query 乘上当前累积衰减(从块头到当前)
    #key 乘上从当前位置到块尾的剩余衰减
    #chunk_decay:整个块的总衰减因子(块尾累积衰减),用于状态跨块传递

    query = query * cum_decay.exp().unsqueeze(-1)
    key = key * (cum_decay[..., -1:] - cum_decay).exp().unsqueeze(-1)
    chunk_decay = cum_decay[..., -1].exp()[..., None, None]

    # 5. 跨 Chunk 宏观递推
    for i in range(num_chunks):
        v_new = new_values[:, :, i] - k_cumdecay[:, :, i] @ last_recurrent_state
        inter_chunk_attn = query[:, :, i] @ last_recurrent_state
        core_attn_out[:, :, i] = inter_chunk_attn + intra_chunk_attn[:, :, i] @ v_new
        # S_{t+1} = S_t * chunk_decay + k^T @ v_new
        last_recurrent_state = last_recurrent_state * chunk_decay[:, :, i] + key[:, :, i].transpose(-1, -2) @ v_new

    last_recurrent_state = None if not output_final_state else last_recurrent_state
    core_attn_out = core_attn_out.reshape(padded_output_shape)[:, :, :sequence_length]
    core_attn_out = core_attn_out.transpose(1, 2).to(initial_dtype, memory_format=torch.contiguous_format)
    return core_attn_out, last_recurrent_state
📚本系列文章(待写完修正)
[1]Nano-VLLM全代码解析笔记(1)-sequence
[2]Nano-VLLM全代码解析笔记(2)-block_manager
[3]Nano-VLLM全代码解析笔记(3)-llm_engine和scheduler
[4]Nano-VLLM全代码解析笔记(4)-model_runner
[5]Nano-VLLM全代码解析笔记(5)-laynorm和attention
[6]Nano-VLLM全代码解析笔记(6)-embed_head和linear
[7]Nano-VLLM全代码解析笔记(7)-rotary_embedding
[8]Nano-VLLM全代码解析笔记(8)-qwen3与qwen3_moe
[9]Nano-VLLM全代码解析笔记(9)-qwen3.5介绍
[10]Nano-VLLM全代码解析笔记(10)-GemmaRMSNorm和MRoPE
[11]Nano-VLLM全代码解析笔记(11)-Linear与GDNAttention
🔗上一篇: [11]Nano-VLLM全代码解析笔记(11)-Linear与GDNAttention

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)