Qwen3.8-Flash-Next-续集-48GB笔记本跑起来
摘要:本文是《Qwen3.8-Flash-Next 落地指南》的续集,围绕开发者 Eyal Toledano 将 176B 模型塞进 48GB 内存 MacBook Air 的实测展开。核心是两招:REAP 剪枝把专家池从 68GB 砍到 35GB,再把 51B 的 n-gram 词典整体卸载到 SSD,最终让 q4 量化常驻内存从 97GB 压到 39GB,质量仅掉 2.4 个点。结论是:8G/16G 独显党仍不推荐硬跑,64G 内存党门槛已从"差一截"变为"装得下",但最省事的路径依然是 API,本地硬核玩法要等工具链成熟。
续集|176B 模型塞进 48GB 笔记本:我的 64G 内存,从"差一截"变成"装得下"?
写于 2026-08-28 | 接昨天《Qwen3.8-Flash-Next 发布了,但 8G/16G 显卡还是跑不动》那篇的续集
新信息源:AGI Hunt 8-27 报道的开发者 Eyal Toledano 实测(X@EyalToledano,18k 粉),以及 Qwen 官方模型卡 / 技术报告
说明:以下"塞进 48GB"是一名开发者的个人实测,非官方、非第三方独立验证;文中已逐条标来源。本文未做本地实测。写作当日已有 REAP 剪枝版 GGUF 上线(见第 2、4 节),结论相应修正。
昨天那篇落地指南,我下了个有点狠的结论:只要你手上是 8G/16G 消费级显卡,本地部署基本没戏——内存才是门槛,我那台 64G 内存都差一截。
今天凌晨刷到一条实测,差点把我自己那篇的结论打脸:
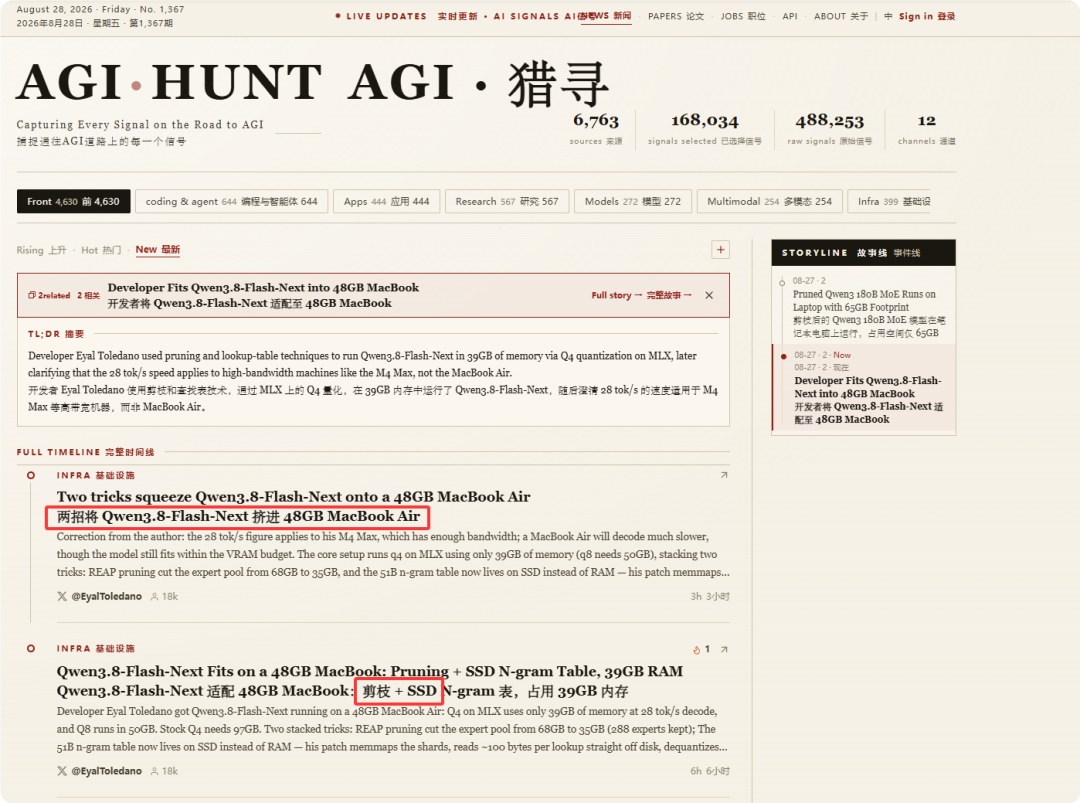
有人把 176B 的 Qwen3.8-Flash-Next 塞进了 48GB 内存的 MacBook Air,q4 量化只要 39GB 常驻内存就能跑。
所以这篇是续集,专门聊一件事:昨天说的"内存门槛",到底被往下推了多少?我的 64G 小主机,是不是突然有戏了?
1)他到底怎么塞进去的:两招,都不复杂
开发者 Eyal Toledano 用的是 MLX(苹果芯片上的推理框架),q4 量化,叠了两个招:
第一招:REAP 剪枝,把专家池从 68GB 砍到 35GB。
先补课——这个模型是 MoE(混合专家),512 个专家池,每 token 只路由 10 个 + 1 个共享。但所有专家权重都得常驻内存,不管用不用。REAP(Router-weighted Expert Activation Pruning,Cerebras 在 ICLR 2026 发的一次性剪枝法)干的事很直白:用校准数据跑一遍,给每个专家算"重要性分"= 路由器有多常选它 × 它干活时输出有多大,然后把分最低的专家整批删掉,不重训、不改架构。
Eyal 砍完保留了 288 / 512 个专家,专家池从 68GB 掉到 35GB。
大白话:MoE 里一堆专家平时基本摸鱼,REAP 就是把摸鱼专家开除,剩下的照常干活,路由器照样独立调度。Cerebras 的论文说砍 25%–50% 专家能保住 96%+ 的质量——这不是玄学,是有论文背书的。
第二招:把 51B 的 n-gram"词典"整个挪到 SSD 上。
昨天那篇我重点讲过,这 51B 不是真算参,是第 2 层插的一张 2000 万条目的"查表词典",推理时按上下文查一下,不参与矩阵乘法。关键来了:Qwen 自己就把它设计成"可以卸载到主机内存甚至 SSD"的——官方技术报告原话是"卸载到 host memory""几乎不增加每 token 计算"。所以这一招不是野路子,是顺着官方架构走的。
Eyal 的补丁把这个表 memmap 到 NVMe 固态:推理时按地址读,每次查询只从盘上读约 100 字节,在 CPU 上反量化,而且他验证过跟放内存里跑的结果 bit-exact(逐位一致)。288 个专家 + 这张表从 NVMe 加载进内存只要 6 秒。
两招叠加的结果(他给的数字):
| 项目 | 数值 |
|---|---|
| 满血 q4 常驻内存 | 97GB(他测的基线) |
| 剪枝 + n-gram 上 SSD 后,q4 常驻 | 39GB |
| 同法 q8 常驻 | 50GB |
| 解码速度 | 他报 28 tok/s,但这是 M4 Max(见第 3 节) |
| prefill 速度 | 600 tok/s |
| 质量损耗 | HumanEval 93.9% → 91.5%(掉 2.4 个点) |
一句话:满血 97GB,砍到 39GB——直接砍掉六成内存占用,质量只掉 2.4 个点。这就是为什么我说昨天那篇结论要被打脸。
2)这跟"我的 64G 小主机"什么关系:算一笔账
我自用的是 RTX 3070 8G 独显 + 64G DDR5 内存。昨天那篇我写"64G 连 GGUF 1-bit 的 78G 都差一截,跑不了"。
现在换个算法:
- 满血 q4(AGI Hunt 测的 97GB)> 我的 64G → 跑不了,昨天没错。
- 但剪枝版 q4 只要 39GB < 我的 64G → 装得下。
所以严格说,昨天"64G 差一截"是针对满血模型的结论;一旦 REAP 剪枝 + n-gram 卸载这套打法成熟,理论上我的 64G 能从"差一截"变"装得下"。但"富余 25G"是 Eyal 在苹果统一内存 + 双招齐全下的数字,落到我的 Windows 独显机得拆开看:
① 格式关已经过了。 就在写这篇的同一天,已经有人把 REAP 剪枝版打成 GGUF 传上 HuggingFace(如 AnonimousA/Qwen3.8-Flash-Next-REAP-256-duo-GGUF,117B,刚上线)。GGUF 是 llama.cpp 的格式,Windows 直接能吃,不用等 MLX 移植——所以"剪枝权重放出了吗"这问有答案了:放出了。
② 但体量关还在。 这个 GGUF 只做了"专家剪枝"这一招,没做 Eyal 第二招"51B 词典上 SSD"。实测权重 Qwen3.8-Flash-Next-UD-Q3_K_XL-reap256(分片 48.2+13.8GB)共 62GB,里面对含着那 51B n-gram 表(REAP 只剪专家、不碰词典)。它正是 Eyal 第二招要卸到 SSD 的部分:把这 51B(Q3 下约 19GB)挪到 NVMe,常驻能压到 ~43GB,你的 64G 就富余了——所以"64G 挤着塞"是暂时状态,等第二招移植就解。但 stock llama.cpp 没有"某张表上 SSD"的开关,得等 Eyal 那种补丁移植过来。
③ 完整 39GB 版仍等第二招。 Eyal 那种把 n-gram 也卸到 SSD 的完整版,目前还没看到 Windows/GGUF 版放出,得等有人把 n-gram SSD 卸载也做进 GGUF。
④ 想自己压更低(Q1/Q2)或从头做 REAP+量化?硬件不低。 量化得先装下源权重:BF16 源约 234GB、Q8 源约 117GB,都得 128GB+ 内存或云实例。你 64G 本机基本装不下,自己量化得借大内存机器或云;从现有 Q3(62GB) 再压虽"勉强装得进",但极易 OOM、质量还会再掉,不如等社区出更低的档、或等第二招(n-gram 上 SSD)来得干净。
所以结论是:剪枝权重确实放出了、我的 64G 装 GGUF 剪枝版在"技术上能塞",但因为只有半招,实际是挤着跑、不轻松;真要像 Eyal 那样舒服(39GB + 富余),还得等 n-gram 卸载这第二招也移植过来。
3)必须泼的几盆冷水(不然就是标题党)
这事儿很燃,但有几条不泼清楚就是坑:
① 28 tok/s 是 M4 Max 的,不是 MacBook Air 的。
作者自己更正了:那个速度是他 M4 Max(内存带宽高)的数据;MacBook Air 解码会慢很多,只是"模型仍能塞进显存预算"。我的机器是 DDR5-5200 独显机,带宽比 M4 Max 差一大截,真跑起来大概率比 Air 还慢,别拿 28 tok/s 当预期。
② 这是个人实测,不是官方,也没第三方复现。
一名开发者、一个 patch、一组数字。HumanEval 掉 2.4 点看着很香,但那是他用的校准集下的结果;REAP 的质量高度依赖校准数据——用通用文本校准,某些专业专家可能被误杀。等社区多复现几次再信。
③ 词典上 SSD,赚的是内存、亏的是延迟。
每次查询从 NVMe 读 ~100 字节看着极小,但这是"随机小读",SSD 的 4K 随机延迟会累积;长上下文、高并发、连续 agent 任务下,这张表的访问模式还没被充分测过。官方说它能异步预取重叠计算,但实际体感要等真跑。
④ n-gram 上 SSD 是顺着官方设计,但 REAP 剪专家不是。
前面说了,词典卸载是 Qwen 自己预留的口子;剪专家是开发者自己动刀,动了架构就得自己扛质量风险。两者叠加的"综合损耗"目前只有 HumanEval 一个点,其他任务掉多少还不知道。
4)结论:昨天那句"没戏",得改口成"看工具链"
把昨天的结论和今天的对一下:
| 昨天(满血) | 今天(剪枝 + SSD 卸载) | |
|---|---|---|
| 8G/16G 独显 | 结构性跑不了 | 仍不推荐硬跑(慢、工具未到) |
| 64G 内存机 | 差一截 | GGUF剪枝版已出(62GB/Q3,仅半招),64G挤着塞 |
| 96–128G 统一内存(Mac Studio 等) | 甜点区 | 更稳,剪枝后余量巨大 |
| 最省事路径 | API | API(不变,仍最便宜) |
我的判断:
对咱 8G/16G 独显党,昨天"结构性没戏"的结论 today 要改成"满血没戏,剪枝后有戏但得等工具、且慢"。对 64G 内存党(包括我),门槛确实被推到"装得下"的区间了——这是真进展,不是画饼。
但落到行动:普通人现在最划算的体验方式,依然不是硬跑本地,是 API(¥1/¥3 每百万 token,改个 BASE URL 接 Claude Code 当副驾,零硬件成本)。本地这条路,第一件事已经发生了:REAP 剪枝版 GGUF 已放出、能在 llama.cpp/Windows 直接吃,我现在就能下下来试(只是 64G 挤着跑)。第二件事还待:把 n-gram SSD 卸载也做进 GGUF / 非苹果平台,做到了才真舒服。所以不急着换显卡,但"下下来跑一把写实测"这事儿,我已经能排上日程了。
写在最后
这个模型最妙的地方,是 Qwen 自己就把"51B 词典"设计成可卸载的——等于官方在架构层面就留了"给内存/硬盘穷的人"的口子。再叠加社区 REAP 剪专家,176B 从"97GB 才能动"压到"39GB 装得下"。
昨天我说"内存是门槛",今天补一句:门槛会被社区一点点啃下来,但啃下来的每块,都得用速度或质量去换。 咱普通人别急着换显卡,先盯 API,再等工具链——该来的硬核玩法,迟早轮到 64G 机器。
更多免费API资讯、实测信息、AI教程等请关注同名GZH。
(续集完。新数据来自 AGI Hunt 报道的 Eyal Toledano 实测 + Qwen 官方模型卡/技术报告 + HuggingFace 上已上线的 REAP 剪枝版 GGUF(如 AnonimousA/Qwen3.8-Flash-Next-REAP-256-duo-GGUF,117B,发布时刚上线,llama.cpp/Windows 可吃,但仅专家剪枝、未做 n-gram SSD 卸载、实测常驻 62GB(Q3_K_XL 分片);REAP 原理来自 Cerebras ICLR 2026 论文。发稿前可再去 HF 确认该权重最新量化档与确切体积。)

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 13
 0
- 0


 已为社区贡献10条内容

所有评论(0)