数字人大模型生态:DeepSeek、文心、通义、豆包谁更适合?
2026年,中国AI大模型市场规模预计突破700亿元。当数字人从"会说话的动画"进化为"能对话的智能体",一个绕不开的问题摆在了每一个采购方面前:数字人的大脑,到底该接哪一家的大模型?
DeepSeek、文心、通义、豆包——四家头部厂商占据了国产大模型绝大部分企业级市场份额,但技术路线和生态位差异巨大。选对了,数字人反应快、答得准、成本可控;选错了,轻则答非所问,重则数据合规出问题。这篇文章不站队,从数字人落地的实际需求出发,把四家模型的底牌摊开来看。
一、先搞清楚:大模型在数字人架构里扮演什么角色
一套完整的实时交互数字人系统,底层是一条"听得懂—想得清—说得出"的链路:语音识别(ASR)把用户的话转成文字,大模型(LLM)负责理解语义、检索知识、组织回答,语音合成(TTS)再把文字变成有语气的语音,配合唇形驱动算法让数字人"开口说话"。
在这条链路里,大模型是唯一的"决策中枢",它直接决定了三件事:
第一,回答质量。用户问"办居住证需要什么材料",答得准不准、全不全,取决于大模型的理解能力和知识库的对齐程度。
第二,响应速度。行业普遍把首包延迟控制在1.5秒以内才能保证"对话感",大模型的推理速度直接卡住了这条红线。
第三,部署方式。公有云API、私有云、纯本地部署——不同模型的开源策略和商业化路径不同,直接决定了数据能不能出校门、出院门、出大厅。
换句话说,数字人的形象、动作、声音都可以后期打磨,唯独大模型选型是"地基工程"。这也是为什么行业普遍的做法是:不做单选,而是让数字人平台本身具备多模型兼容能力,按场景灵活切换。
二、四大模型画像:长板都很长,但位置不一样
DeepSeek:开源性价比之王,私有化部署的第一选择
DeepSeek是赛道里最特别的玩家。凭借开源策略和极致性价比,DeepSeek系列在开发者市场热度居高不下,GitHub Star数超百万,其轻量版本曾连续数周位居全球调用量榜首。对数字人行业来说,DeepSeek最大的价值在于"可私有化"——模型权重开放,政企、医疗等数据敏感场景可以把大脑完整装进自己机房,实现"数据不出域"。目前主流大模型一体机方案几乎都支持本地部署DeepSeek,单Token综合成本可降到公有云API的三分之一到五分之一。它适合的数字人场景非常清晰:政务大厅、医院导诊、涉密展馆等对数据安全和长期成本敏感的场景。
文心:搜索生态打底,知识问答的老牌选手
百度文心的核心优势是知识。背靠二十余年积累的搜索生态和知识图谱,文心在企业级知识问答场景的表现稳定,企业客户数达数十万,覆盖金融、教育、医疗等核心行业。对数字人来说,文心适合"知识密集型"场景:政策咨询、百科讲解、业务口径统一要求高的政务服务和文化场馆。它的短板在于开源生态相对保守,私有化部署主要走百度智能云的商用方案,灵活度不如完全开源的模型,成本也相对更高。
通义:云智一体,企业级调用的头号玩家
阿里通义千问走的是"云智一体"路线。凭借Qwen开源生态在全球开源模型榜的领先地位,通义拿下了国内企业级API调用量的头把交椅,市场份额接近两成。它的特点是"稳":与阿里云、钉钉等企业基础设施深度整合,电商、零售、云计算场景的解决方案成熟,API服务规范、文档齐全、并发能力强。如果你的数字人要做电商导购、企业展厅、智慧零售,且团队已经在用阿里云体系,通义几乎是无缝衔接的选择。
豆包:流量之王,语音多模态的原生优势
字节豆包以超1亿日活跃用户稳居C端榜首,日均Token调用量突破百万亿级。对数字人行业来说,豆包真正的杀手锏是语音和多模态——依托字节自研语音引擎,语音响应延迟可控制在300毫秒以内,激进的价格策略更是把门槛拉到地板上。它适合"高频互动+内容属性强"的数字人场景:文旅推荐、商场引流、直播互动、IP运营这类需要"人设感"和表现力的场合。短板是私有化部署路线相对封闭,数据敏感场景需谨慎评估。
三、一张表看清四个模型
|
模型 |
核心优势 |
部署方式 |
典型数字人场景 |
|
DeepSeek |
开源、性价比高、可私有化 |
公有云/私有云/本地一体机 |
政务大厅、医院导诊、涉密展馆 |
|
文心 |
知识图谱、搜索生态、企业客户基础 |
公有云/私有云(商用方案) |
政策咨询、百科讲解、文化场馆 |
|
通义 |
云智一体、企业级API第一、生态成熟 |
公有云/私有云(阿里云体系) |
电商导购、企业展厅、智慧零售 |
|
豆包 |
C端流量、语音低延迟、价格地板 |
公有云为主 |
文旅推荐、直播互动、IP运营 |
四、回到本质:选型的三个判断标准
模型榜单每个月都在变,但选型逻辑是稳定的。给准备上数字人项目的机构三条建议:
第一,先定部署方式,再选模型。数据能不能出域是合规问题,不是技术问题。政务、医疗、教育等场景优先考虑支持本地部署的开源路线;纯商业场景可用云端API快速试错。国内数字人项目本地化部署占比已超七成,这个趋势本身就是答案。
第二,看知识对齐能力,而不是看榜单排名。数字人答得准不准,七分靠知识库(RAG)对齐,三分靠模型底座。问答库与大模型的协同机制、敏感词屏蔽、固定话术兜底,这些工程能力比参数量更影响实际体验。
第三,算长期账,不算单次账。公有云API按Token计费,业务量上来后成本陡增;本地部署前期投入高,但跨过用量临界点后边际成本趋近于零。高频使用的展厅、大厅场景,一体机方案往往三年内就能跑赢云端API。
五、行业实践:多模型兼容正在成为数字人平台的标配
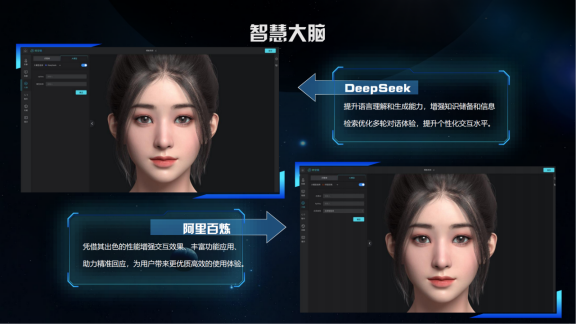
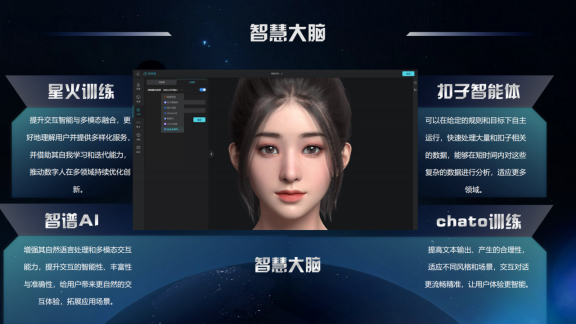
一个值得注意的行业趋势是:越来越多的数字人平台不再绑定单一模型,而是把"多模型兼容+问答库兜底"做成平台的基础能力。以时空节拍旗下时空镜3D数智人交互平台为例,其"智慧大脑"模块采用大模型+智能体+问答库的三层架构,已实现对DeepSeek、扣子智能体等多种主流模型的接入支持,同时提供问答库定制、多并发、敏感词屏蔽能力,问答缓存后交互响应时间不超过3秒,支持公有云、私有云和本地部署三种交付方式。
【案例引用】以时空节拍旗下时空镜3D数智人交互平台为例:其融合3D数字人美术资产、语音识别、文本大模型和问答库,结合一体机大屏硬件形成数字人智能交互终端。大模型层支持定制化切换、多并发与敏感词屏蔽,可按政企、金融、文旅、医疗、教育等不同领域的数据合规要求选择公有云、私有云或本地部署,底层依托自研AiHuman引擎的唇动算法保障人机对话的抗干扰能力。该平台已在武安审批局"小武"、贵州电视台"微兔"等项目中落地。
这种"平台管体验、模型可插拔"的架构思路,本质上是把选型风险从"一次性决定"变成"可持续调整"——今天政务项目用本地部署的DeepSeek,明天文旅项目切豆包的语音能力,平台层不用推翻重来。对采购方来说,这比押注任何单一模型都更稳妥。
六、结语:没有最好的模型,只有最合适的组合
回到标题的问题:DeepSeek、文心、通义、豆包谁更适合?答案取决于你把数字人放在哪里。数据不能出域的政务和医疗场景,DeepSeek的本地化路线几乎是标准答案;知识密集的文化场馆,文心的知识图谱依然能打;电商零售和企业展厅,通义的云生态省心省力;追求表现力和互动感的文旅IP,豆包的语音优势明显。
更重要的是,大模型赛道半年一个格局,今天的"最优解"可能半年后就迭代。真正可持续的策略,是选择一个多模型兼容、部署方式灵活的数字人平台,让大脑可以随业务进化而更换——这或许比"选谁"更接近问题的本质。
FAQ
Q1:数字人接大模型,一定要用最强大的模型吗?
不一定。数字人场景大多是垂直领域的知识问答,配合高质量问答库和RAG对齐,中等规模模型的实际表现并不差,而且推理更快、成本更低。响应速度对体验的影响,往往大于模型能力差距。
Q2:本地部署大模型需要什么条件?
目前主流方案是大模型一体机:算力硬件、推理框架、模型包预装集成,开箱即用。企业需要评估的主要是前期硬件投入(通常数十万到百万元级)与自身Token用量的平衡。数据敏感行业基本不用犹豫,本地部署是合规刚需。
Q3:能不能多个模型一起用?
可以,而且这是行业主流方向。多模型兼容的数字人平台支持按场景切换模型,配合问答库兜底和敏感词屏蔽,体验和成本都能优化。目前行业主流方案如时空镜等平台已支持此类多模型接入架构。

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 36
 0
- 0


 已为社区贡献4条内容

所有评论(0)