把 AI 知识库搬回本机纯国内 永久免费 · 0 Token 的羽山数智方案
AI本地知识库搭建方案:纯国内 · 永久免费 · 0 Token · 数据不出本机
实测 18/18 校验通过 · Qwen3-8B + BGE-M3 · Top-1 检索相关度 0.82 · 断网永久可用
先问三个扎心的问题:你有没有算过,用云端 AI 知识库一年花了多少 Token?你的笔记、文档、内部资料,又上传了多少到第三方服务器?
羽山数智方案AI本地知识库搭建方案= 思源笔记 + 本地大模型 + 本地向量库——0 费用、0 出境、0 绑定。整条链路:笔记存储、语义检索、智能问答、工作流编排,全部跑在自己的电脑上。
这不是概念稿,是跑通了的实盘:18/18 交付校验通过,Qwen3-8B + BGE-M3 本地推理,Top-1 检索相关度 0.82,Agent 自动调用工具且零幻觉。Python代码平台,MIT 开源。
一、先看证据:凭什么信你
技术方案的说服力,从来不在 PPT 里,在实测数据里:
|
验证项 |
实测结果 |
|
交付校验 verify_hermes.py |
18 / 18 全过(语法 / 依赖 / 分块 / 6 工具 / MCP Schema / 配置持久化) |
|
语义检索 |
Top-4 命中,最高相关度 0.82(BGE-M3 中文嵌入) |
|
Agent 工具循环 |
自动调用 search_notes,结构化回答,逐条标注来源 [文件名] |
|
服务自检 |
Ollama ✓ · Qwen3-8B ✓ · 嵌入 ✓ · 知识库 36 片段 |
|
运行成本 |
0 Token——模型常驻本地,问多少次都不花钱 |
|
断网可用 |
模型下载完成后,离线永久使用 |
二、三条路,总有一条适合你
|
你的水平 |
推荐路径 |
耗时 |
|
纯小白 |
下载一键包 + 跟着界面点(Web 平台) |
5 分钟 |
|
会用命令行 |
按「快速开始」四步跑通 |
10 分钟 |
|
开发者 |
读 hermes_core.py,扩展自己的工具 |
按需 |
三、用了之后,你每天省下什么
不用 vs 用了,落差是这样的:
|
场景 |
云端方案 |
Hermes 本地方案 |
|
💰 费用 |
每月 ¥200+ Token 费(知识库越大越贵) |
¥0,一次性下载模型即可 |
|
🔒 数据 |
笔记、文档全部上传第三方服务器 |
全程不出本机,合规审计直接过 |
|
✈️ 离线 |
断网/高铁/飞机/内网环境不可用 |
照常问答,永久离线 |
|
🔗 绑定 |
换产品 = 重新迁移知识资产 |
MIT 开源,随时可改可带走 |
💡 费用估算口径:按每日 50 次问答 × 云端 API 计费估算,实际随使用频率浮动。
四、三方对比:Hermes vs Obsidian+WorkBuddy vs Notion AI
|
维度 |
Obsidian + WorkBuddy + 云 API |
Notion AI |
**Hermes(本方案)** |
|
笔记存储 |
Obsidian(本地) |
Notion 云 |
思源笔记(本地,AGPL) |
|
智能体调度 |
WorkBuddy(云端 SaaS) |
内置 |
Hermes(本地,MIT) |
|
大模型 |
云端 API |
云端 API |
Ollama + Qwen3(本地) |
|
嵌入 |
云端 Embedding API |
云端 |
BGE-M3(本地) |
|
向量库 |
托管服务 |
托管 |
ChromaDB(本地文件) |
|
月成本 |
¥100–500+ |
¥80–200+ |
¥0 |
|
数据出境 |
是 |
是 |
否 |
|
断网使用 |
否 |
否 |
是 |
|
可审计/私有化 |
否 |
否 |
是(全栈开源) |
五、一年成本账:云端 vs 本地
|
项目 |
云端方案(1 年) |
Hermes(1 年) |
|
API 调用费 |
¥2,400+(按月 ¥200 计) |
¥0 |
|
向量库托管 |
¥600–1,200 |
¥0 |
|
订阅费 |
¥1,000+ |
¥0 |
|
一次性投入 |
— |
下载模型 5–17 GB(电费可忽略) |
|
合计 |
¥4,000–5,000+ |
≈ ¥0 |
六、它凭什么做到:架构与实现
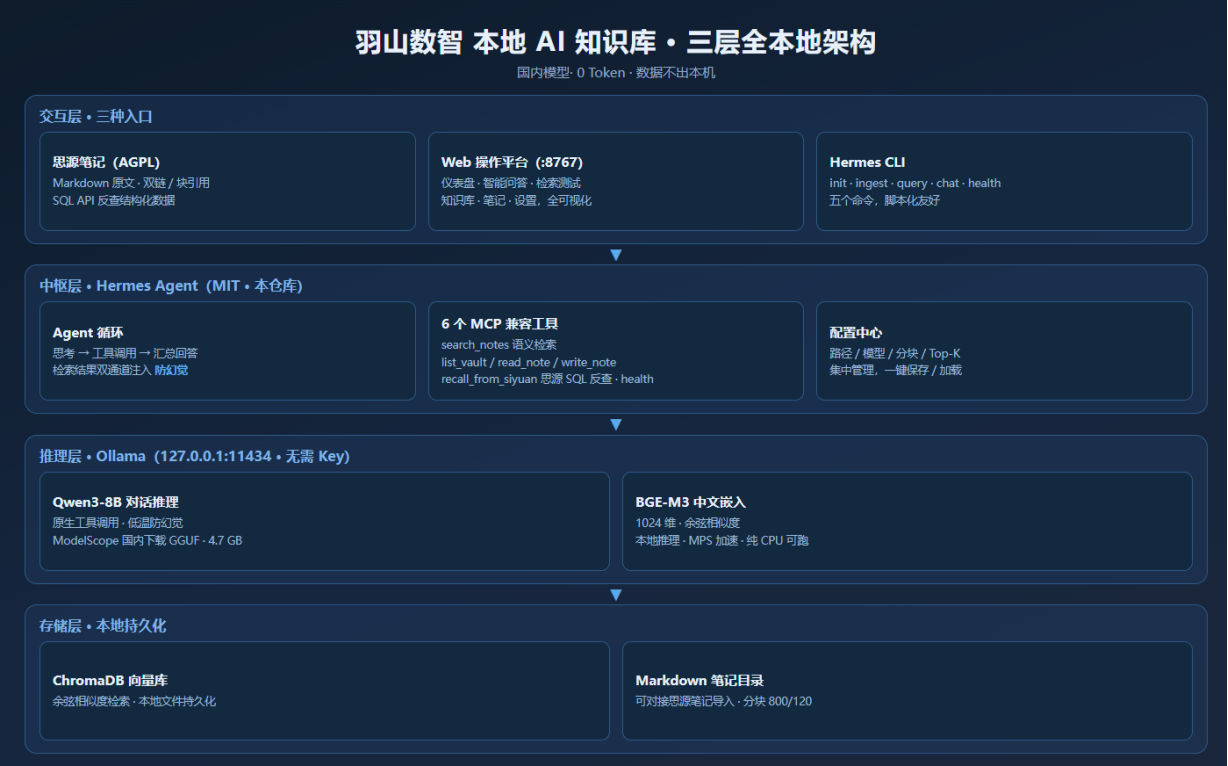 思源笔记 / Hermes CLI / Web 操作平台(交互层)
↓ 自然语言提问 / HTTP 127.0.0.1:11434(无需 Key)
Hermes Agent 中枢(思考 → 工具调用 → 汇总 · MCP Tool Schema)
↓
Ollama(Qwen3-8B 对话推理 + BGE-M3 中文嵌入)
↓
ChromaDB 本地持久化 + Markdown 笔记(存储层)
三个让你秒懂的设计:
- 检索是"找邻居",不是"搜关键词":BGE-M3 把你的每篇笔记变成 1024 个数字的坐标,提问时找最近的邻居——就像图书馆按主题分类,而不是按书名排序。
- 让 7B 小模型不胡说:把模型"想象力"调到 0.1(低温采样),再给它一个固定回答模板,检索结果双通道注入。这是用提示词对照实验跑出来的最优组合——实测逐条标注来源、零编造。
- 分块像切披萨:按你笔记的标题结构切块,每块带上父标题当上下文——就像切披萨时每块都带点边上的料,语义完整不割裂。
核心模块(hermes_core.py,500 余行)
|
模块 |
职责 |
|
Config |
集中管理所有路径与模型配置,一键保存/加载 |
|
HermesTools |
6 个 MCP 兼容工具:语义检索、目录读写、思源 SQL 反查、自检 |
|
RAGEngine |
本地 BGE-M3 嵌入 + ChromaDB 持久化,Markdown 友好分块 |
|
HermesAgent |
思考 → 工具调用 → 汇总回答的 Agent 循环 |
|
CLI |
init / ingest / query / chat / health 五个命令 |
七、杀手级差异:思源 SQL 反查
这个能力几乎所有同类方案都没有——Obsidian 的 Dataview 是静态查询,而 Hermes 能在 AI 回答时自动反查思源数据库,把结构化笔记(任务、日记、项目)也纳入检索范围。
# Hermes 内置工具:直接对思源 SQL API 反查双链/块引用
recall_from_siyuan "SELECT * FROM blocks WHERE type='d' AND content LIKE '%待办%'"
笔记的正文走向量检索(语义),结构化数据走 SQL 反查(精确)——两条腿走路,这是纯 Markdown 方案给不了的。
八、Web 操作平台:不只是 CLI
很多人以为知识库工具=命令行,其实 Hermes 带完整可视化平台:
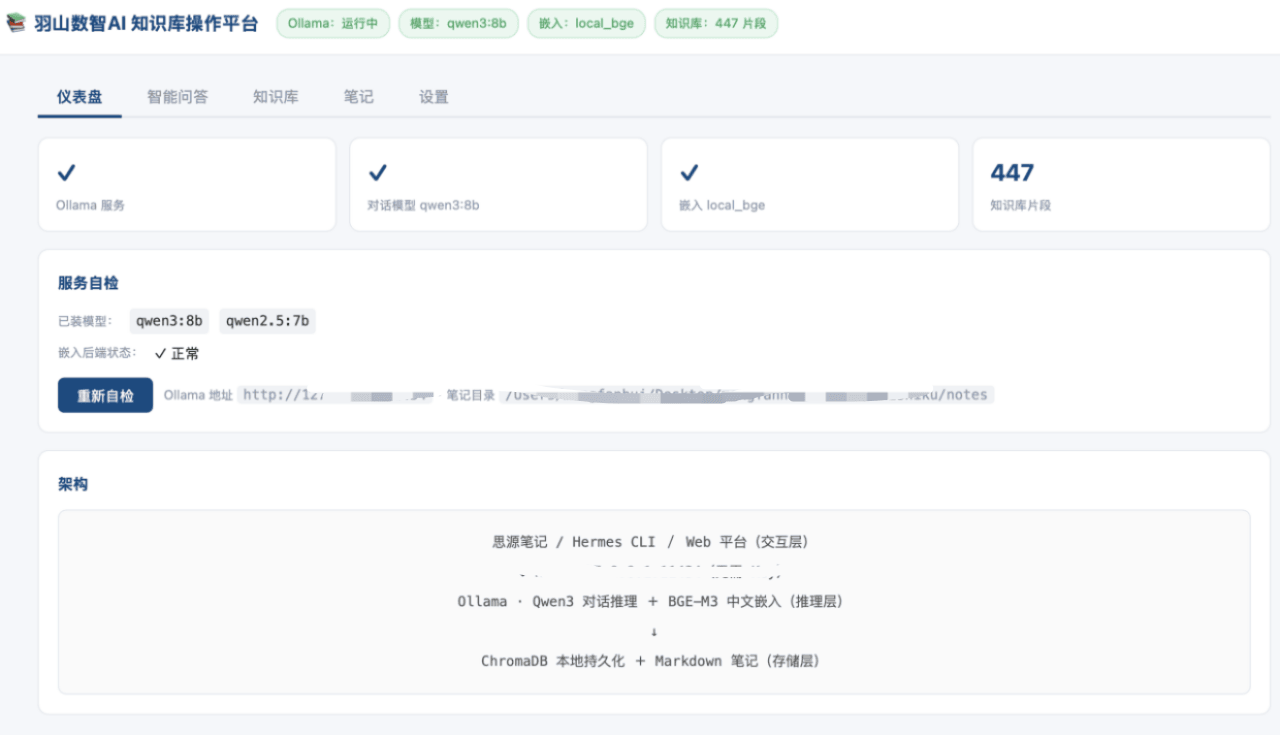
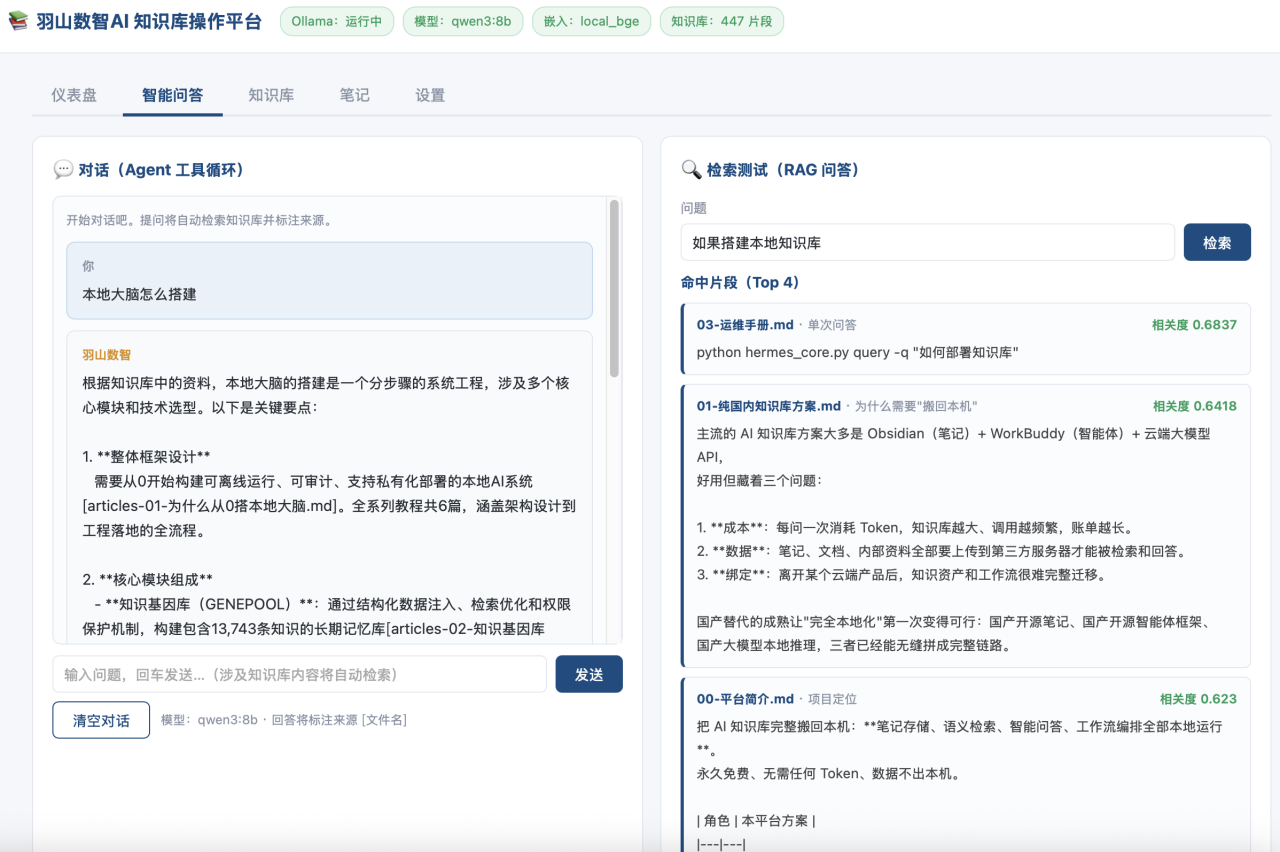 五大功能页:仪表盘(服务自检)/ 智能问答(Agent 对话 + RAG 检索测试)/ 知识库(一键导入)/ 笔记(在线编辑)/ 设置(模型下拉框实时读取 Ollama)。
九、避坑记录:两个真实踩过的坑
坑 1:Ollama 官方源国内不可达?走 ModelScope 导入
ollama pull 走官方源在国内经常超时。实测可行路径:
# 1. ModelScope 下载 GGUF(国内直连,约 4.7 GB)
curl -L -o Qwen3-8B-Q4_K_M.gguf \
"https://modelscope.cn/api/v1/models/Qwen/Qwen3-8B-GGUF/repo?FilePath=Qwen3-8B-Q4_K_M.gguf"
# 2. 写 Modelfile(ChatML 模板 + 停止符)
# 3. 本地导入,之后断网永久使用
ollama create qwen3:8b -f Modelfile
注意:Qwen3 系列没有 7B 档位,对应 Qwen2.5-7B 的是 8B——很多教程写的 qwen3:7b 实际应为 qwen3:8b。
坑 2:从 Obsidian 迁移到思源
- 好消息:思源可直接导入 Markdown 原文,双向链接、知识图谱体验高度一致;
- 需注意:Dataview / Templater 这类 Obsidian 特有语法,要在思源中用「模板片段 / SQL 嵌入」重建——这是迁移唯一需要手动处理的部分;
- 完成后 :ingest 重建向量索引即可,原有笔记零改动。
十、代码走读:Agent 循环的精妙 30 行
hermes_core.py 里最值得读的是 Agent 循环——它让 7B 小模型也能可靠地"思考→调用工具→汇总":
for _ in range(cfg["max_tool_rounds"]):
resp = _ollama_request(f"{cfg['ollama_url']}/api/chat", payload)
calls = (resp.get("message", {}) or {}).get("tool_calls") or []
if not calls:
return msg.get("content", "").strip()
msgs.append({"role": "assistant", "content": msg.get("content", ""), "tool_calls": calls})
for tc in calls:
result = tools.call(fn.get("name", ""), raw)
msgs.append({"role": "tool", "content": result})
if fn.get("name") == "search_notes": # 检索结果双通道注入,防幻觉
msgs.append({"role": "system", "content": f"<reference>{result}</reference>"})
两个关键设计:
- 双通道注入:检索结果同时出现在 tool 消息和 system 参考块——7B 模型对 tool 消息注意力弱,双通道保证最终回答不编造;
- 来源强制标注:系统提示要求逐条标注 [文件名],回答可回溯、可审计。
十一、快速开始(10 分钟版)
# 1. 安装 Ollama,拉取模型(首次联网,之后永久离线)
ollama pull qwen3:8b
ollama pull bge-m3
# 国内网络:从 ModelScope 下载 GGUF 后 ollama create 导入(见第九节)
# 2. Python 依赖
pip install chromadb sentence-transformers requests fastapi uvicorn
# 3. 初始化 + 构建知识库
python hermes_core.py init
python hermes_core.py ingest --dir ~/SiYuan/data
# 4. 使用(CLI 与 Web 二选一)
python hermes_core.py chat # 命令行对话
python webui.py # Web 操作平台 http://127.0.0.1:8767
模型选择建议
|
内存 |
推荐模型 |
说明 |
|
8 GB |
Qwen3-4B |
可用,推理偏慢 |
|
16 GB |
Qwen3-8B |
推荐平衡点(本项目实测) |
|
≥32 GB |
Qwen3-14B / 32B |
质量更好 |
BGE-M3 约 2.1 GB,纯 CPU 即可运行。
十二、谁适合这套方案
- 个人知识工作者:笔记量大、重视隐私、不想持续付费;高铁上、飞机上、断网时照常查自己的知识库;
- 企业与机构:数据主权敏感(金融 / 政务 / 研发),全栈国产化、可审计、可私有化部署;
- 开发者:MIT 开源,自由扩展工具、接入更多数据源、定制 Agent 工作流。
一句话:笔记层用思源,调度层用 Hermes,模型层跑 Ollama + Qwen3——中文适配、数据主权、离线能力全面占优,完全自主可控。
Hermes 已开源 · MIT 协议 · 可商用、可修改、可私有化部署
配套交付:hermes_core.py(核心 500 行)/ webui.py(Web 操作平台)/ verify_hermes.py(18 项校验)/ README.md(部署文档)

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 23
 0
- 0


 已为社区贡献2条内容

所有评论(0)