DeepSeek Harness 有哪些记忆插件?111 个插件的分类与流派
本文基于 awesome-dsh-plugin 目录 memory 分类下的全部 111 个插件(截至 2026-08-25)整理而成。注意:dsh 生态的记忆插件不止这 111 个,本文统计范围以该目录收录为准。最近在关注 DeepSeek Harness 的插件生态,开发过程中对当前的记忆插件有了比较详细的了解,顺手把分类笔记整理成文。我是其中第四类 dsh-project-memory 的作者,各插件的介绍信息均来自目录收录原文,有描述不准的地方欢迎指出,我会更新。
先说结论
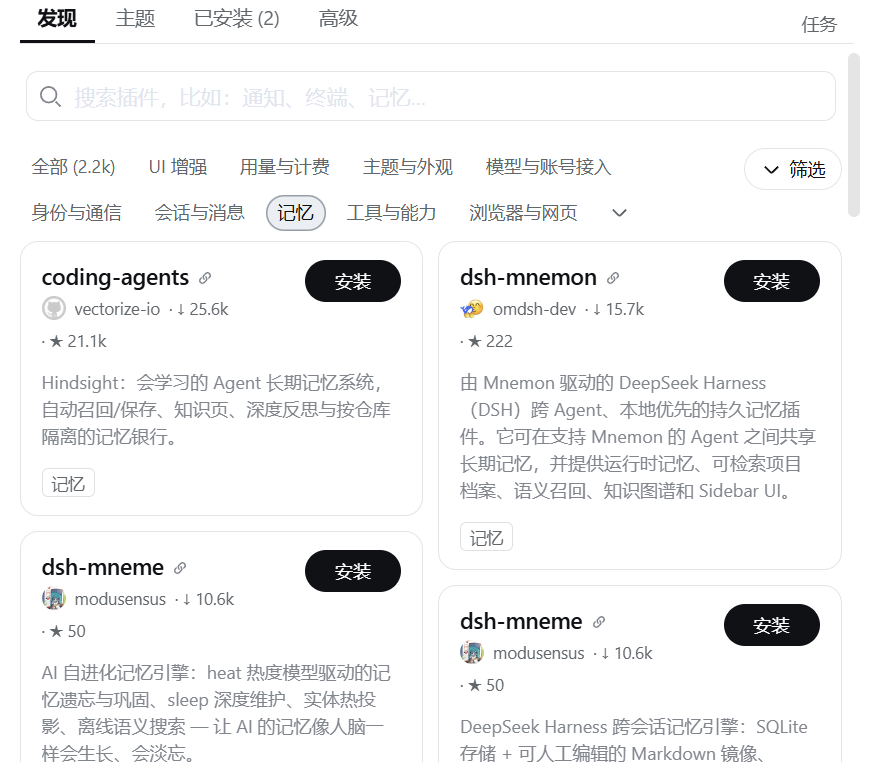
在 dsh 生态里搜"记忆插件",结果会覆盖至少六类完全不同的工具。它们共享"记忆"这个名字,但解决的问题几乎不相交:
| 流派 | 解决的问题 | 数量占比 |
|---|---|---|
| 一、对话事实记忆 | 记住聊过的偏好、决策、结论 | 约 40%,最大类 |
| 二、极简 Markdown 文件派 | 同上,但坚持纯文件、可手改 | 约 10% |
| 三、系统级/服务端记忆 | 团队级、产品化的记忆基础设施 | 约 10% |
| 四、项目内容索引 | 记住项目文件本身:文档写了什么、代码有什么 | 约 5 个 |
| 五、跨工具会话复用 | 把其他 AI 工具的历史会话变成可检索资产 | 约 6 个 |
| 六、特色机制 | 各自聚焦一个单点机制的创新 | 其余约 30 个 |
如果你正在为dsh挑选一个记忆插件,或者单纯想了解 dsh 记忆插件生态的全貌,都可以先了解这六个流派——先弄清每个流派在解决什么问题,再看代表插件的思路差异。下面逐类展开,每类介绍 3~4 个代表。
一、对话事实记忆(约 40 个)
最大的一类。核心动作是一对:remember(存)和 recall(取),对象是对话中产生的偏好、决策、事实。差异主要在三处:检索算法(BM25 / FTS5 / 向量 / 混合)、自动化程度(手动确认 / 自动提取 / 后台自进化)、存储格式(JSON / SQLite / Markdown)。
代表:
| 插件 | 思路 |
|---|---|
| @max-null/dsh-memory | 确定性 BM25 关键词召回,无向量嵌入;模型只能写"建议",人工 confirm 才生效——把控制权做成了卖点 |
| dsh-memory-connect | 走另一个极端:零配置自动提取,SQLite FTS5 + RRF 召回每轮注入,附"全局灵魂"soul.md |
| dsh-mneme | heat 热度模型驱动遗忘与巩固、sleep 深度维护——让记忆像人脑一样淡忘 |
| dsh-meow-memory | 七层 SQLite 存储(soul/user/project/fact/lesson 等)、缓存友好注入、空闲时 dream 自动整理——社区数据最硬的一家 |
| dsh-evolve 系列 | 多家实现的"记忆+自进化"组合:从对话蒸馏事实再升级为可复用技能 |
这一类选择最多,差异集中在三点:检索算法(BM25 / FTS5 / 向量 / 混合)、自动化程度(手动确认 / 自动提取 / 后台自进化)、存储格式(JSON / SQLite / Markdown)——按自己最在意的那一点挑即可。
二、极简 Markdown 文件派(约 10 个)
信条是:记忆必须是用户可以直接打开、编辑、git 管理的纯文本。功能上普遍比第一类朴素,换来的是完全的透明和可控。
| 插件 | 思路 |
|---|---|
| dsh-simple-wiki-memory | 一个索引文档自动加载 + 每主题一个 md 按需读取 |
| dsh-memory-palace | 用户级 + 工作区级双层 MEMORY.md,回合结束自动写日志并定期蒸馏 |
| dsh-hermes-memory | 有界双记忆库(固定字符预算)、冻结快照注入,零 LLM 成本 |
| engramory | 一条事实一个文件,任何编辑器都能打开 |
适合在意"我的数据必须是我能读懂的文件"的人。
三、系统级/服务端记忆(约 10 个)
把记忆做成一套需要部署的基础设施,换来的容量和能力是个体插件无法比的。
| 插件 | 思路 |
|---|---|
| Hindsight(vectorize-io) | Docker/Cloud 部署的记忆系统,LongMemEval 榜首,retain/recall/reflect 三操作 + 知识页;公司级产品 |
| OpenViking(火山引擎) | 服务端语义检索 + pre-step 自动召回 + 画像注入,配合其生态使用 |
| dsh-butler-memory | PostgreSQL 持久化 + MCP 工具 + Web 审核面板 |
适合团队共用记忆池,或需要产品级能力(基准成绩、管理面板、托管服务)的场景。
四、项目内容索引(约 5 个)
前三类记的都是"对话里说过什么"。这一类记的是项目文件本身:文档内容、代码结构、两者之间的引用关系。动机也很简单——AI 每次开新会话都要重新理解一遍代码库,这件事不该重复发生。
| 插件 | 思路 |
|---|---|
| dsh-project-memory | 读到即索引(模型读哪个文件才索引哪个):PDF/Markdown 出 LLM 摘要、代码出零 token 符号表,doc↔symbol 自动交叉链接,每条结果带 path:line 可回源文件核实;查询默认零 token |
| dsh-code-intel | Tree-sitter AST 解析建符号索引,词法或可选 embedding 辅助检索——精度取向 |
| dsh-openwolf* | 预索引项目地图 + 文件摘要 + 读写拦截,agent 不必重读整个文件 |
| PerryLink/dsh-library、omdsh-dev/dsh-kb-sieve | 把本地 md/txt/pdf 文档转成可检索知识库,偏"资料库"而非"代码库" |
几家按技术路线各有侧重:Tree-sitter AST 精度取向、向量检索语义取向、零依赖工程取向。另外这一类和第一类不冲突——一个管项目、一个管对话,同时装是常见用法。
*注:dsh-openwolf 在目录中归类于代码类,因功能高度相关在此并列。
五、跨工具会话复用(约 6 个)
思路:你之前在 Claude Code、Cursor 里积累的会话历史,本身就是一座金矿。
| 插件 | 思路 |
|---|---|
| deja-vu | 读取本机其他 19 个编程智能体的会话文件(含安装前的历史),本地 BM25 索引、不联网 |
| dsh-memory(Jesse-njx) | 基于 dsh 无损会话日志的引用式记忆:蒸馏事实附带 sessionId+行号引用,可回溯原始事件 |
| dsh-recall(Relistencode) | 字面/模糊/语义三层检索全部历史会话原文,完全本地离线 |
| dsh-memory-porter | 把 Claude/ChatGPT 导出的 memories.json 搬进 dsh |
如果你是多工具重度用户,这一类的性价比可能出乎意料。
六、特色机制(其余约 30 个)
单点机制上的创新,选型时作为补充视野:
- 时间轴:dsh-memory-pyramid(npm)——定宽只追加的事实日志 + 摘要金字塔,读取成本不随记忆量增长
- 触点触发:dsh-cue-bank——提取对话触点,话题切换时注入相关历史
- 负面知识:dsh-negative-ledger——只记录被证伪的路径,防止重复踩坑
- 证据分级:dsh-akn-plugin——经验按 H0-H4 分级,审阅后才晋升
- 零 LLM 捕获:dsh-engram——规则匹配自动捕获 + 证据闭环协议
另有一个容易混淆的小族群:上下文压缩/裁剪类(compaction、pruner 等 5 个)。它们管的是"当前对话太长怎么删",而非"跨会话记住什么"。
怎么选
一句话需求对照:
- “AI 总忘了我说的偏好和决策” → 第一类或第二类(要省心选前者,要透明选后者)
- “团队要共用一套记忆” 或 “我要做产品” → 第三类
- “AI 每次都不了解我这个项目的文档和代码” → 第四类
- “我想利用在其他 AI 工具里的历史” → 第五类
- 就想尝鲜奇怪的机制 → 第六类
两个补充判断:
- 类别之间可以组合:第四类 + 第一类是最常见的搭配(项目归项目、对话归对话),互不抢地盘
数据说明
- 统计范围:awesome-dsh-plugin 目录 memory 分类全部 111 个条目(2026-08-25)
- 明显误分类项已过滤(如二维码生成器、技能推荐工具)
- 部分插件仅在 npm 发布而未进入该目录(如 dsh-persona-memory、dsh-memory-pyramid),不在本文统计内
- 各插件描述以目录收录原文为准;功能细节请以各自仓库为准
- 我是第四类 dsh-project-memory 的作者,欢迎各插件作者与读者指出文中不准确之处

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐


 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)