[人工智能]Claude、GPT、Gemini、Copilot与Llama:概念、架构、应用与评估
Claude、GPT、Gemini、Copilot与Llama:概念、架构、应用与评估
报告目的。本报告从工程视角介绍五类具有代表性的LLM模型家族和产品生态。内容区分基础模型能力与产品封装,解释预训练、后训练、检索增强和工具调用的关系,并讨论如何从实验性原型走向可靠的生产系统。
适用范围。本文以决策和系统设计为导向,不构成模型版本或产品能力排名。模型版本、可用区域、上下文长度、授权方式和产品特性会持续变化,实际采购和部署前应依据最新官方资料,并使用企业真实任务进行验证。
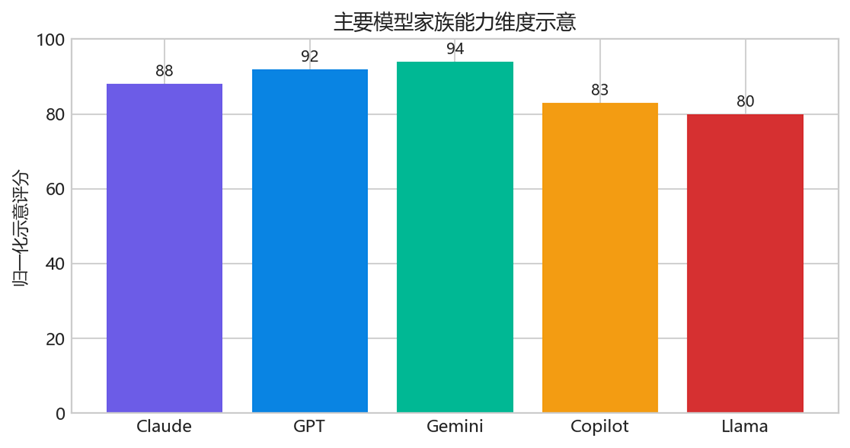
图1:主要LLM模型家族能力维度的示意性比较,不代表正式基准测试结果。
|
模型家族 |
组织 |
定位 |
优势方向 |
工程关注点 |
|
Claude |
Anthropic |
面向助手场景、强调宪法式AI理念的模型体系 |
安全性、长上下文推理、写作与分析 |
策略约束、评测、工具调用 |
|
GPT |
OpenAI |
通用生成式模型家族 |
推理、编程、多模态交互与智能体 |
预训练、后训练、工具和结构化输出 |
|
Gemini |
|
多模态模型家族 |
文本、图像、音频、视频、代码与长上下文工作流 |
原生多模态、检索和生态集成 |
|
Copilot |
Microsoft |
面向生产力的AI体验 |
编程、文档、会议、搜索和办公协作 |
接地、权限控制和企业工作流集成 |
|
Llama |
Meta |
开放权重模型家族 |
定制部署、研究、微调和边缘场景 |
模型权重、生态灵活性和部署控制 |
表1:Claude、GPT、Gemini、Copilot与Llama的高层比较。
1. 一个LLM系统实际包含什么
生产级LLM应用通常并不只是一个神经网络,而是由基础模型、指令和策略层、企业知识检索、工具、记忆、观测系统以及用户界面共同组成。模型负责生成候选文本或动作,外围系统则决定模型可以看到哪些信息、可以执行哪些操作,以及结果如何被校验。
比较Claude、GPT、Gemini、Copilot与Llama时必须注意这一点。托管式助手可能提供权限、连接器、审计和治理能力;开放权重模型则可能提供更强的推理部署、微调和基础设施控制。相似的用户体验,背后的系统架构可能完全不同。
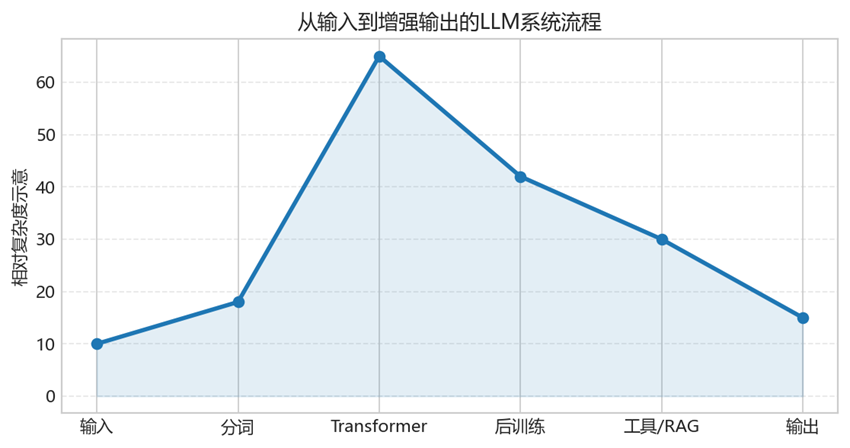
图2:从用户输入、模型处理、后训练行为到工具和接地输出的LLM系统流程示意。
2. Claude
Claude通常被用于谨慎推理、写作、分析和企业知识工作。评估时不仅要看答案质量,还应检查模型能否遵守政策、区分证据与假设、稳定处理长文档,以及在面对不安全或无权限请求时正确拒绝。
企业部署需要同时关注数据留存、提示注入防护、引用行为、权限边界和工具调用。长上下文能力应使用真实的检索与推理任务测试,而不能只依赖单一的合成上下文实验。
3. GPT
GPT代表广泛的通用模型家族,可用于对话、编程、推理、多模态交互和智能体工作流。其工程价值通常来自模型能力与平台能力的组合,包括结构化输出、工具调用、评测流程、API以及应用集成模式。
GPT应用应为每项任务定义明确的接口契约,包括输入格式、允许使用的工具、输出格式、拒答行为、不确定性处理方式和延迟目标。结构化输出有助于降低集成歧义,但不能替代语义校验、授权检查和业务规则测试。
4. Gemini
Gemini常用于覆盖文本、图像、音频、视频和代码的多模态工作流,适合文档理解、视觉检查、会议分析、媒体摘要和多模态搜索等输入并非纯文本的场景。
多模态评估应先分别测试各模态能力,再测试跨模态推理。例如,可以评估视觉信息抽取、视频时间推理、文档页码定位,以及图像结论与文字来源之间的一致性。生产系统还需要文件校验、安全控制和模态不可用时的降级路径。
5. Copilot
Copilot更适合被理解为面向生产力的一组AI体验,而不是单一模型端点。它的价值往往来自AI嵌入代码编辑器、文档、会议、搜索和协作工具。由于它接近组织数据,接地、身份和权限感知检索尤其关键。
主要工程风险包括访问范围过宽、来源不清以及缺少审核的自动化动作。稳健部署应使用最小权限连接器、可审计检索、明确的生成内容标识,并对外部沟通或高影响动作设置人工审核门槛。
6. Llama
Llama通常与开放权重部署、微调、量化、推理和研究生态联系在一起。这种模式支持区域托管、私有化部署、专项适配和边缘场景,但也会把更多安全、运维和治理责任转移给使用方。
Llama部署需要建立模型供应链:验证模型来源、记录精确版本、扫描依赖、评估授权义务、保护权重文件并记录微调数据。量化和小型模型可以降低成本与延迟,但必须验证其对推理、多语言、安全性和工具调用的影响。
7. 按决策维度比较
|
维度 |
Claude |
GPT |
Gemini |
Copilot |
Llama |
|
主要决策视角 |
谨慎的助手行为 |
广泛的平台能力 |
多模态生态 |
工作流集成 |
部署控制 |
|
典型适配场景 |
分析与写作 |
通用应用与智能体 |
多模态产品 |
企业生产力 |
私有或定制化服务 |
|
关键风险 |
过度相信流畅分析 |
工具自主性失控 |
跨模态接地错误 |
权限和来源缺口 |
运维与治理负担 |
|
首要测试 |
长文档证据任务 |
结构化工具工作流 |
跨模态基准任务 |
权限感知业务任务 |
成本-质量部署测试 |
表2:面向决策的定性比较,不代表产品保证。
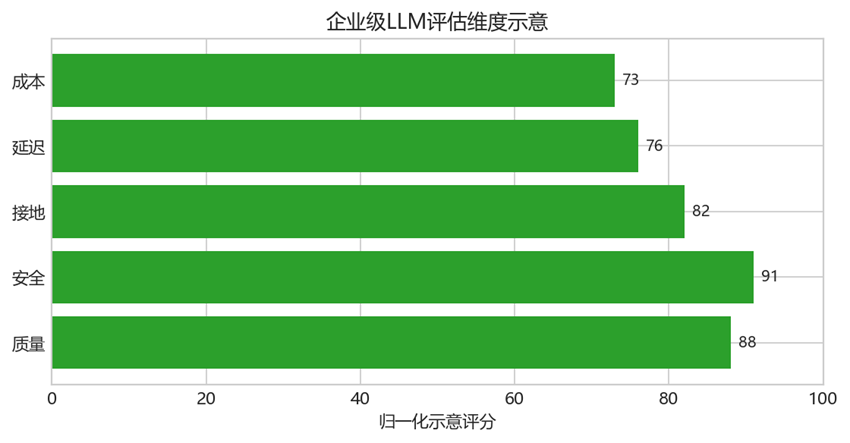
图3:企业级LLM系统评估维度示意,数值不代表正式基准结果。
8. 训练与后训练
预训练从大规模语料中学习统计结构,使模型具备文本续写和模式泛化能力,但不会自动理解某个组织的政策、权限或工作流程。后训练则通过监督样本、偏好优化、强化式方法、安全训练和工具示例来塑造模型行为。
检索增强生成与训练是互补关系。检索在请求时提供最新或私有证据,训练则塑造通用行为和任务模式。微调适用于稳定、重复的行为,不应被用来替代访问控制、来源更新机制和确定性的业务逻辑。
9. 检索、智能体与工具调用
智能体工作流允许模型选择工具、收集信息、转换数据或请求审批。安全的做法是实施边界明确的自主性:提供窄化工具协议,在模型之外校验参数和授权,设置预算并保留审计记录。系统应支持停止、重试和升级,而不是无限循环。
- 接地:为重要结论保留来源标识和实际使用的证据。
- 授权:在检索和执行动作时都检查用户权限,不能只依赖提示词。
- 校验:对工具结果应用结构、类型、业务规则和后置条件检查。
- 可观测性:记录延迟、令牌用量、工具调用、拒答、失败和人工修正。
- 降级:为来源缺失、工具不可用、指令含糊和模型错误定义备用路径。
10. 评估与负责任部署
评估应结合离线测试集、对抗测试、人工审查和线上监控。测试集需要包含真实代表性任务、困难边界案例、多语言样例、策略敏感提示,以及正确行为是澄清或拒绝的案例。
治理范围应覆盖隐私、安全、知识产权、模型风险、可解释性和事故响应。对于高影响场景,应记录预期用途、禁止用途、人工监督、升级路径、数据边界和回滚方案。无论模型是热门托管产品还是开放权重模型,都不会自动获得安全保证。
|
评估层 |
核心问题 |
示例证据 |
|
能力 |
是否准确完成任务? |
任务成功率、事实性、代码测试 |
|
接地 |
结论能否追溯到批准来源? |
引用精度、检索召回率 |
|
安全 |
是否抵抗有害或无权限行为? |
红队测试、拒答质量 |
|
运维 |
能否满足生产约束? |
延迟、成本、可用性、吞吐 |
|
人为因素 |
是否改善工作并呈现不确定性? |
修正率、信任校准 |
表3:选择和运营LLM系统的实用评估框架。
11. 推荐的选型流程
- 明确业务任务、用户、数据分类、可接受风险和可量化成功标准。
- 建立统一评测工具,让所有候选模型面对同一组真实代表性任务。
- 同时比较质量、接地、安全、延迟、成本、集成工作量和运维责任。
- 先进行人工审查和权限受限的试点,再逐步启用自动动作。
- 当模型、提示词、工具或知识源发生变化时,重新评估线上行为。
结论。Claude、GPT、Gemini、Copilot与Llama不应只按模型名称比较,而应综合考虑模型行为、产品界面、部署方式和治理能力。最优选择是能够以可衡量的质量、受控的风险和可持续的运营模式满足实际任务的方案。
欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐
 24
 0
- 0


 已为社区贡献4条内容

所有评论(0)