人工智能啥都知道,为什么还需要老师?
以 Claude 为例,聊聊 AI 在教学场景里到底强在哪、又弱在哪
利益相关:写代码和做量化研究不到十年,带过几拨实习生和转行的朋友,自己也是 Claude、Claude Code 的重度用户。下面的数据都标了出处,观点是我自己的,欢迎拍砖。
先说结论
如果你只想看三句话:
- AI 能不能提升学习效果,几乎不取决于模型多强,而取决于它被施加了什么约束。 同样是 GPT-4 内核,约束设计好的教学系统效应量能到 1.3 个标准差;不加约束直接丢给学生,反而让成绩掉了 17%。
- AI 最擅长的,恰恰是学生最不该外包的那部分认知工作。 Anthropic 自己的数据显示,Claude 在学生对话里承担的主要是”创造”和”分析”这两个最高阶层级,合计 70%。
- 老师这个岗位不会消失,但工种在变——从”知识的搬运工”变成”认知负荷的设计师”。 这个新工种的核心技能,AI 目前一项都不具备。
考虑到国内订阅claude确实有点困难,可以参考一下这里:Claudemax.shop
下面展开。
一、一个让我后背发凉的实验
先讲一个 2025 年发表在 PNAS 上的随机对照试验(Bastani 等人),我第一次看到结果的时候,第一反应是”这不就是过拟合吗”。
研究者在土耳其一所高中找了近 1000 名 9–11 年级学生,随机分成三组做数学:
- 对照组:只能用课本和笔记;
- GPT Base 组:给一个和 ChatGPT 差不多的通用聊天界面,随便用;
- GPT Tutor 组:同样是 GPT-4,但界面被老师加了教学约束——只给提示不给答案、要求学生先说思路。
第一阶段是有 AI 陪着做练习题,第二阶段是撤走所有工具、独立考试。
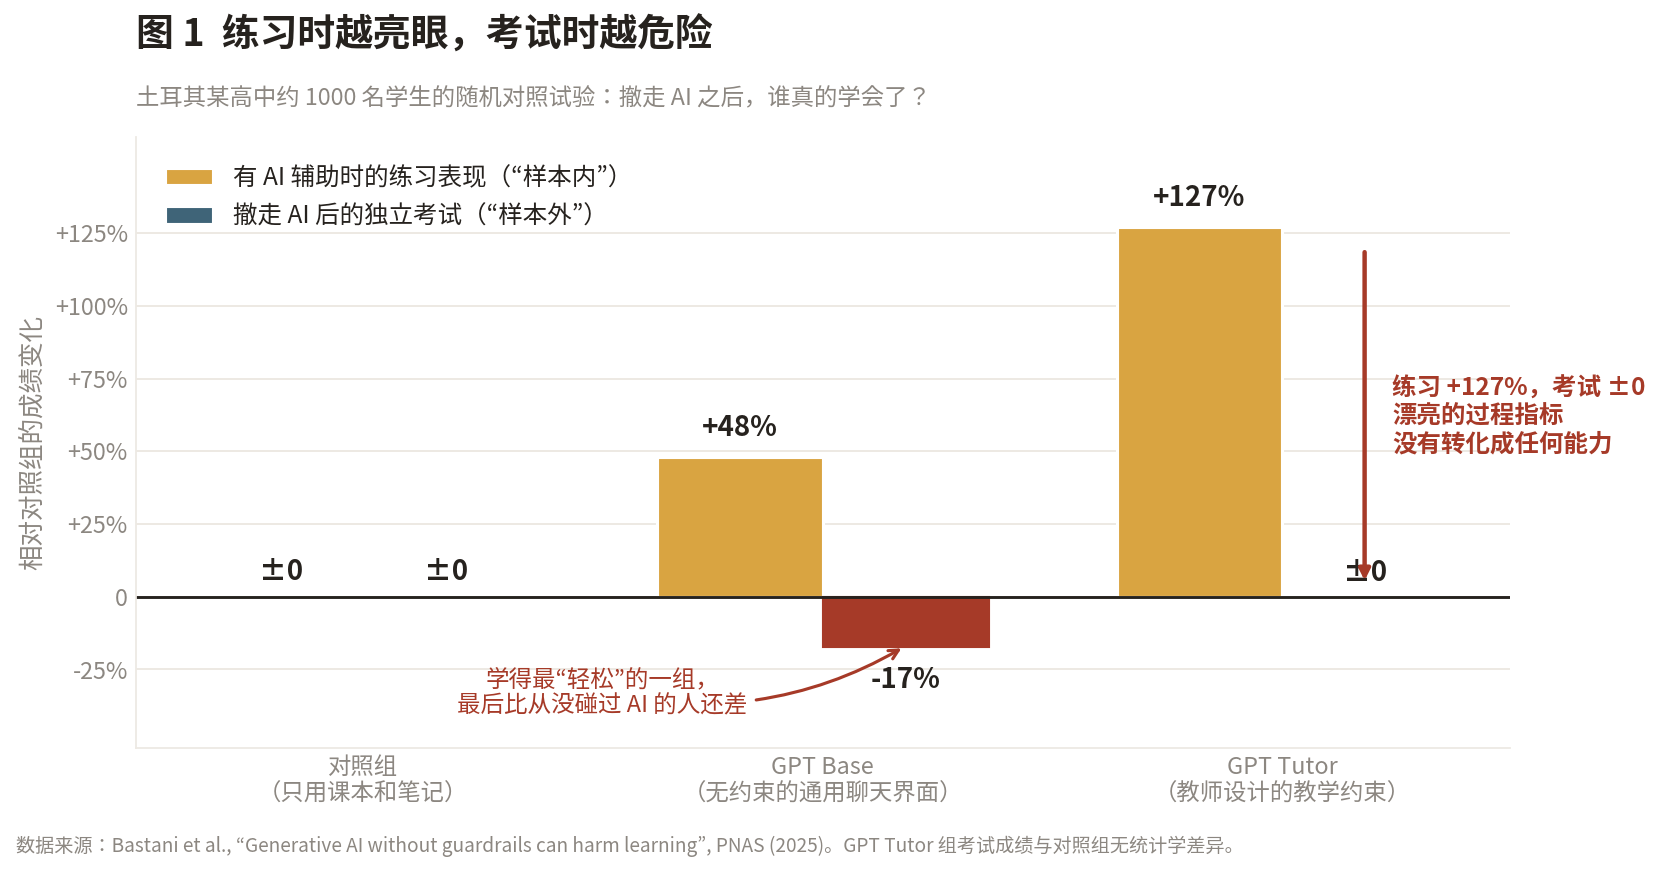
练习阶段,两个 AI 组的成绩都非常漂亮:GPT Base 比对照组高 48%,GPT Tutor 直接高出 127%。任何一个只看过程指标的人,到这一步都会宣布 AI 教学大获全胜。
然后 AI 被拿走了。
GPT Base 组的独立考试成绩,比从来没碰过 AI 的对照组还低 17%。GPT Tutor 组的表现和对照组基本没差别——注意,是”没差别”,不是”更好”。练习时高出 127% 的那 127%,一分都没留下来。
这就是”样本内”和”样本外”
做量化的人对这个形状太熟了。
你调了一个因子,回测曲线漂亮得不像话,夏普 3.5,最大回撤 6%。上线三个月,全还回去了。原因不复杂:你以为你在提取信号,其实你只是在记住噪声。 回测期的每一次”预测正确”,都不是模型真的理解了市场,只是它见过答案。
学生用无约束 AI 做练习题,就是完全同构的一件事。练习题的分数是样本内表现,撤走 AI 之后的考试是样本外表现。中间的落差有多大,就说明”知识”里有多少是借来的。
论文作者把这个叫 crutch effect(拐杖效应),我觉得叫”能力的过拟合”更准确:表现被优化了,能力没有被优化。而我们平时唯一在看的指标,恰好是表现。
这不是一个孤立的实验
如果你觉得单个 RCT 说明不了什么,2026 年 5 月挂出的一篇预印本(Rismanchian 等,加州大学欧文分校 + McGraw Hill)用了一个更狠的数据集:ALEKS 数学平台十年、320 万次学习交互的面板数据。
他们的识别策略很巧:把题目分成“AI 好使”的文字应用题和“AI 不好使”的交互式图形题,然后看 ChatGPT 发布前后两类题的行为分叉。
结果:ChatGPT 发布之后,大学生在文字题上的学习时长每季度下降 2.8%,十一个季度累计降了 26.9%;高中生降了 31.3%;初中生 9%;五年级学生没有可检测的变化(越大的孩子越会把题复制进聊天框,这个梯度本身就很说明问题)。而图形题没有这个趋势——排除了”疫情学习损失”“这届学生不行”之类的解释。
最要命的是那个对照:在有监考的评估里,这个分叉完全消失了;而在随机分配的监考型保留测验上,答对的几率累计下降了 25%。作者把这个现象命名为 cognitive surrender(认知投降)——不是像用计算器那样把一个子任务外包出去(用计算器的人仍然自己搭解题框架、自己判断结果合不合理),而是把整个解题控制权交出去,直接把 AI 的输出当成自己的答案。
对做教育系统的人来说还有个副作用:ALEKS 这类自适应系统靠”掌握信号”来推荐下一题。学生用 AI 做对了题,系统以为他掌握了,于是往前推进。评估信号被污染,自适应逻辑就跟着一起坏掉。
这一点在工程上有个精确对应:你的单元测试全绿,但测试用例是被测代码自己生成的。
二、但同一批模型,也能做出效应量 1.3 的教学系统
如果故事到这里为止,结论就是”AI 有害,禁了算了”。但这个结论是错的,而且错得挺离谱。
2025 年 6 月,哈佛物理系的 Kestin 等人在 Scientific Reports 上发了另一个 RCT。194 名学生,每人一周在哈佛引以为豪的”主动学习”课堂上学一个主题,另一周在宿舍里用定制 AI 助教(叫 PS2 Pal)学另一个主题,顺序随机。
结果是 AI 组赢,而且赢得不小:效应量 0.73–1.3 个标准差,学习时长中位数 49 分钟 vs 课堂 60+ 分钟。在教育研究里,这是几乎见不到的量级。
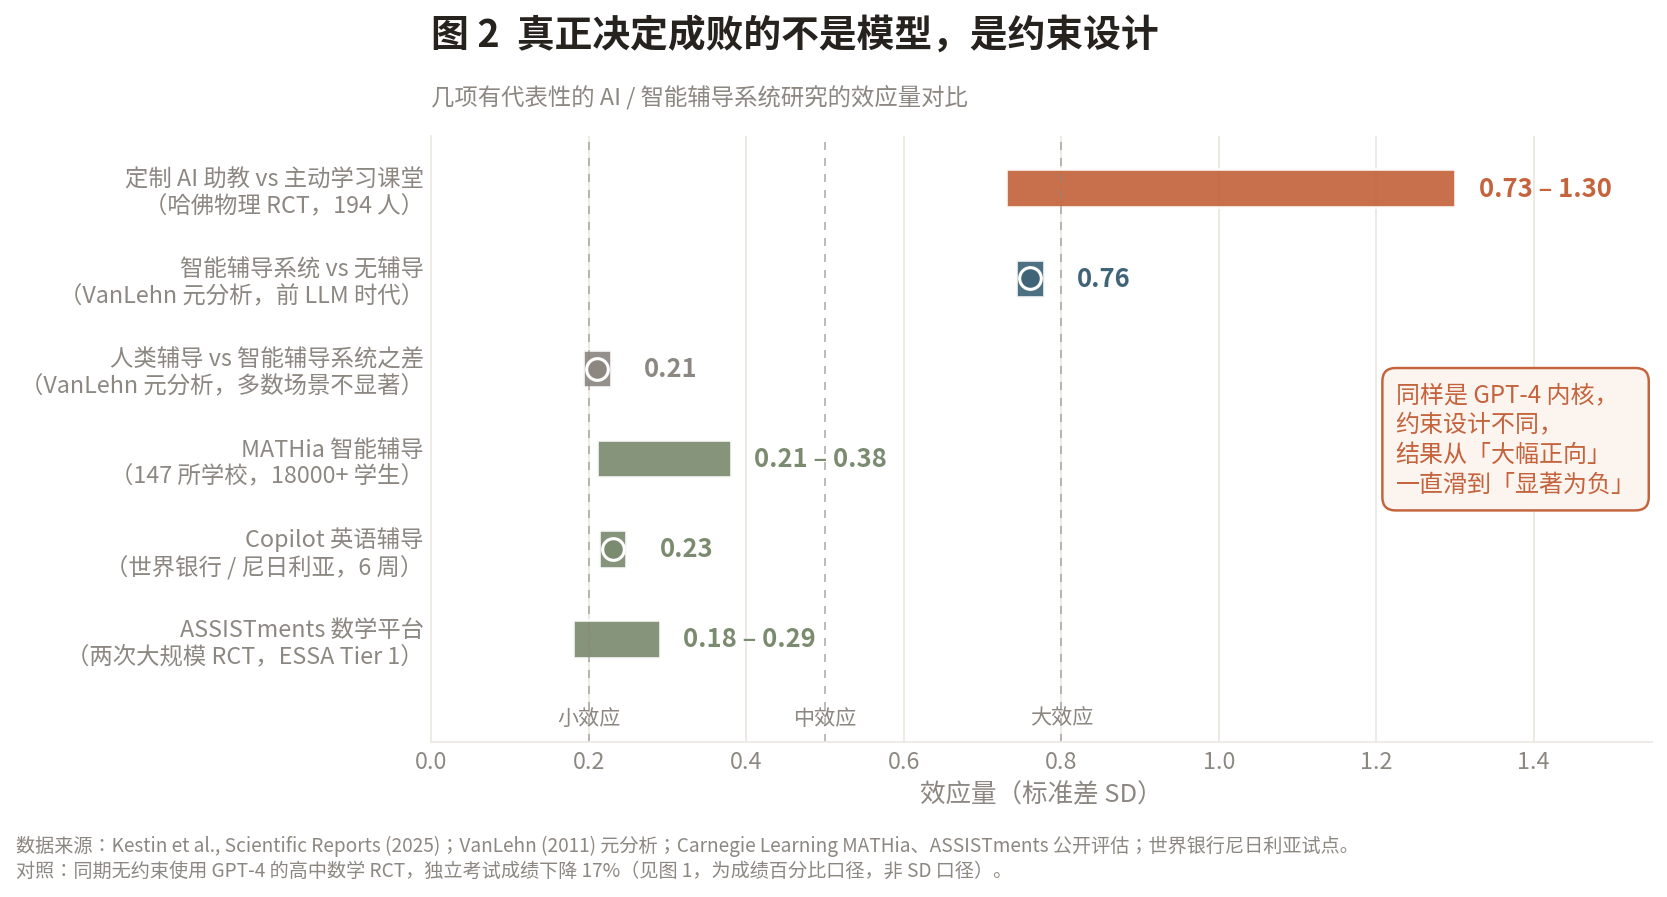
放在一起看就很清楚了。前 LLM 时代 VanLehn 的经典元分析里,智能辅导系统对比”没有辅导”是 0.76 个标准差;而智能辅导系统和真人辅导之间的差距只有 0.21,在多数场景下统计上不显著——这个数字二十年前就摆在那儿了,只是没人当回事。
关键在于:PS2 Pal 不是”把 GPT 丢进物理课”。
它被专门设计成抵抗大模型”有求必应”的天性:答案是预先写好的,模型不许自由发挥(这是为了防幻觉);它被要求先追问学生的思路,一步一步给,不许一次性倒出完整解法;它主动在该增加认知负荷的地方增加认知负荷。
对比一下 Bastani 实验里的 GPT Base——同样的模型底座,一个把摩擦力加回去,一个把摩擦力全部拿掉。前者效应量 +1.3,后者成绩 -17%。
所以真正的自变量从来不是”用不用 AI”,而是”AI 被设计成什么样”。 而”设计成什么样”这件事,本身就是教学法问题,不是工程问题。
三、那 Claude 在教学场景里的生产力,具体强在哪?
上面说的都是”要小心”。现在说说它真的很能打的地方——而且这部分我觉得被严重低估了,因为大多数人还停留在”把 Claude 当搜索引擎”的用法上。
3.1 最大的变化:从”回答问题”到”造出可运行的教具”
Anthropic 2025 年 8 月那份教师报告里,我认为最有价值的发现不是使用占比,而是这句:老师们已经不满足于聊天了,他们在用 Artifacts 直接造工具。
报告里列出来的实际产出包括:网页版的化学计量游戏、带自动反馈的遗传学测验、历史时间线的交互可视化、计算物理模型、能自动填充并导出 PDF 的教学日历、CSV 成绩处理器。
有位受访教师的说法很戳我:以前因为”时间成本高得不可承受”而做不了的定制仿真和交互实验,现在能做了。
这件事的意义,做过工程的人应该秒懂:教具的边际成本塌了。
过去要给一个概念做交互式演示,你得会写前端、有设计资源、还得有两三天空闲——所以现实里大家就用 PPT 讲。现在这个 loop 缩短到十几分钟。一个概念讲不清,就当场再造一个演示,换个角度再来。
我自己带人做量化的时候,最常用这招做三样东西:
- IC 衰减的交互演示:拖动滑块调半衰期和噪声比,实时看信号怎么被吃掉。讲十遍不如让人自己拖三下。
- 样本内/样本外的可视化对比:这个上面刚讲过——最好的教法是让学员亲手过拟合一次,然后看着曲线在样本外崩掉。
- 数据泄露(look-ahead bias)的踩坑器:故意留个用了未来数据的 bug 在里面,让人自己找。
这三个东西以前我得写小半天,现在描述清楚要什么,十分钟出第一版,再迭代两轮就能用。
3.2 约束本身被产品化了
上一节的结论是”约束设计决定成败”。Claude 这两年做的一件正确的事,是把约束做成了产品功能,而不是让每个老师自己去写 prompt。
- Learning Mode:2025 年 4 月先在 Claude for Education 里试,8 月开放给所有 claude.ai 用户,在样式下拉里选”Learning”就行。开了之后它不直接给答案,先反问你”你打算怎么下手”“什么证据支持你这个结论”。
- Claude Code 的两个输出样式(
/output-styles切换):Explanatory:一边写一边解释为什么这么写、权衡了什么、有哪些替代方案——相当于身边坐了个愿意碎碎念的资深工程师;Learning:更狠,它会在代码里留#TODO,要求你自己把关键的几行补上。
第二个我个人觉得是目前 AI 编程教育里最被低估的功能。因为初学者用 Claude Code 最大的问题从来不是写不出代码,而是代码全写出来了,人什么都没学到。留白是最朴素也最有效的干预——它把”合意困难”(desirable difficulty)重新加回了流程里。
坦白说,Learning Mode 也不是万能的。查个 API 参数还被反问三轮,纯粹是浪费时间。它真正有用的场景是开放式推理:理解一个证明、想清楚一个架构、debug 一个你其实没搞懂的逻辑。这也是我建议按场景开关、而不是常开的原因。
3.3 Claude for Teachers:把”合规”和”课标对齐”焊进去了
2026 年 7 月 14 日,Anthropic 发了 Claude for Teachers,面向通过验证的美国 K-12 教师免费(2027 年 6 月 30 日前注册,免费一年)。几个我觉得有信息量的点:
- Learning Commons 连接器(和 Chan Zuckerberg Initiative 合作):接进了全美 50 个州的学业标准,以及每条标准底下更细的能力点,还有 OpenSciEd、Illustrative Mathematics IM v.360 这类经过验证的课程体系。意思是生成的教案默认就对着课标和学生的已有基础,省掉了老师事后一条条核对的时间。
- FERPA 对齐的数据条款,和美国教师联合会(AFT)共同制定,明确不拿教师数据训练。
- 打包了 Claude Code 和 Cowork:可以挂定时任务,比如每天下午 4 点自动跑一遍当天的课堂小测(exit ticket)汇总。
第三点是我最感兴趣的。因为老师真正的瓶颈从来不是”写不出教案”,而是每周 49 小时的工作量里塞满了不产生教学价值的碎活。Gallup 的调查里,老师报告 AI 工具平均每周替他们省下 5.9 小时——这 5.9 小时如果真能还给”和学生说话”,那才是这轮技术最实在的红利。
(顺便,高教这边也在铺:斯坦福从 2026 年 6 月 30 日起给全校师生员工开了 Claude for Education。国内节奏也不慢,教育部等五部门 2026 年 4 月印发了《”人工智能+教育”行动计划》,配套的还有《中小学人工智能通识教育指南(2025 年版)》。方向盘已经打了,剩下的是怎么开的问题。)
3.4 我自己带人时的四个具体用法
前面都是别人的数据,这里说点我自己踩出来的:
① 让它出题,别让它答题。 “就 pandas 的 groupby + 时间序列重采样,出 30 道题,难度从易到难分五档,每题给测试用例和期望输出,答案单独放一个文件我先不看。” 这个用法的好处是:AI 的生产力全部用在扩大练习量上,而练习本身仍然由人完成。这正好是 GPT Tutor 组和 GPT Base 组的分界线。
② 反向讲解:让 AI 当学生,我来讲。 “你现在是一个刚学完线性回归、但完全不懂时间序列的实习生。我来给你讲为什么截面回归里要做行业中性化,你听不懂的地方就打断我。” 费曼学习法的自动化版本。AI 扮演听众的能力,比它扮演老师的能力可靠得多——因为前者不需要它判断对错。
③ 把 AI 当 code reviewer,不当 ghostwriter。 先自己写完,再让它挑刺,并且要求”只指出问题和原因,不要直接给修改后的代码”。加上这半句约束,学习效果差出一个量级。
④ 定期断网考试。 这条最重要,也最反人性。每隔一段时间,关掉所有 AI,限时手写一段东西——一个滚动窗口的因子计算、一段带边界条件的二分查找,什么都行。
因为你在 AI 辅助下的表现是样本内的。你唯一能拿到样本外估计的办法,就是把 AI 拿掉,然后诚实地看结果。这是你自己给自己做的那个”撤走 AI 的第二阶段”。
四、那为什么还需要老师?
好,铺垫完了。现在回答标题。
先看一张让我印象最深的数据图。Anthropic 用 Clio 分析了约一百万条学生对话(筛出 57 万余条),然后用布鲁姆认知层级去分类 Claude 在对话里实际承担了哪一层认知工作:
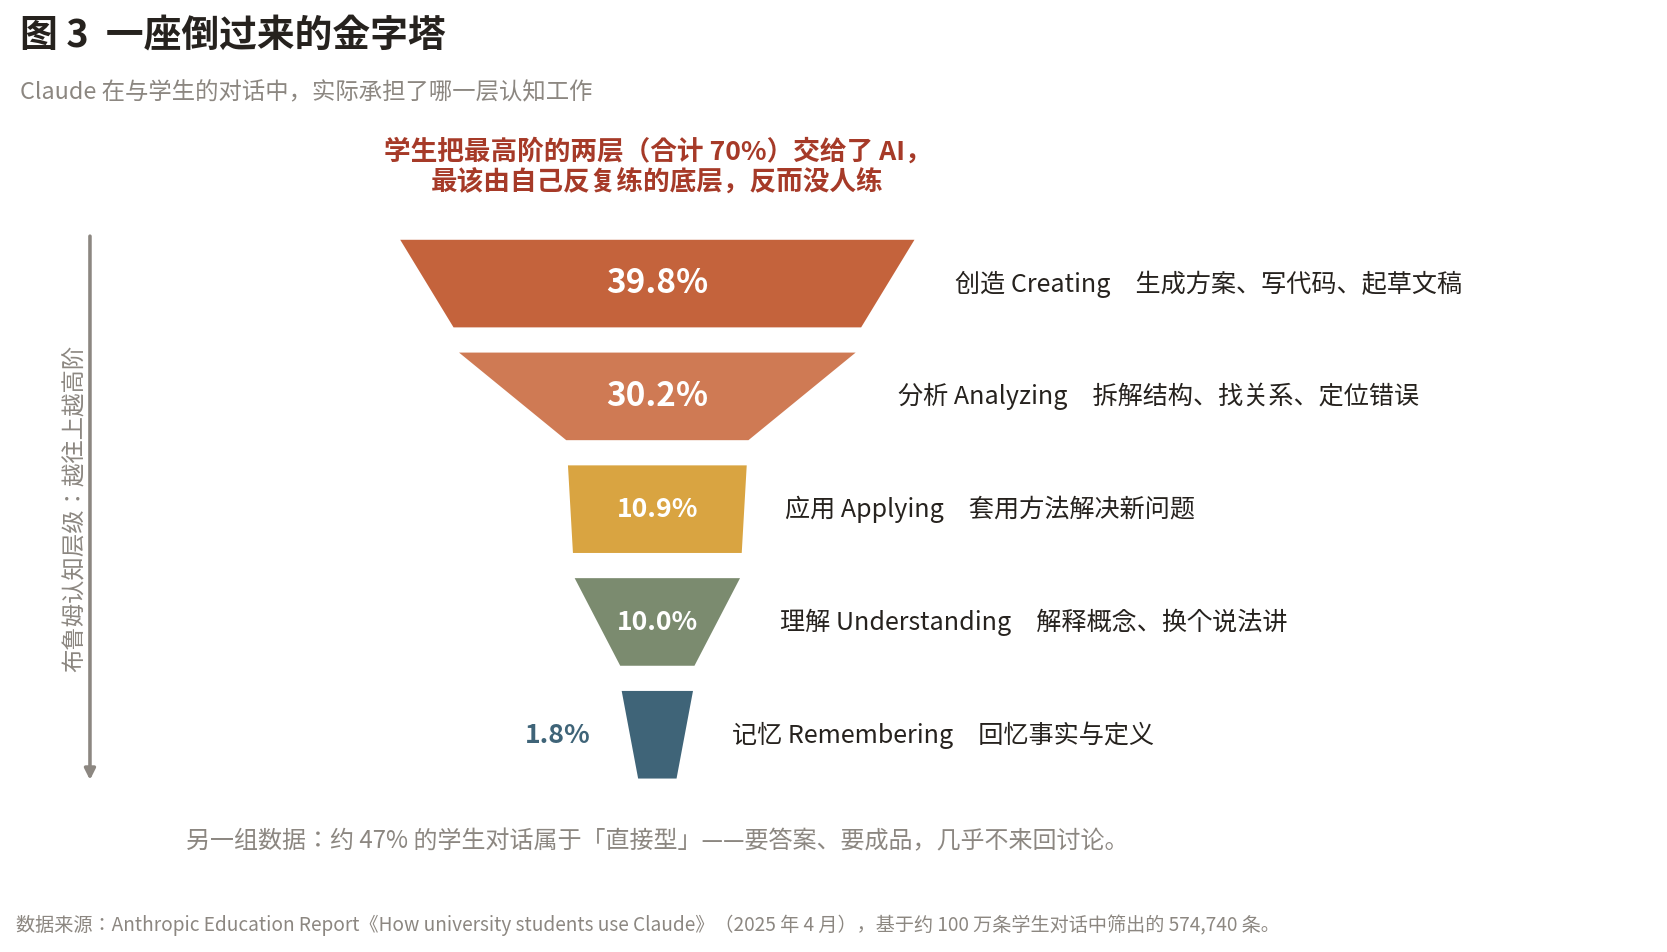
创造 39.8%,分析 30.2%,应用 10.9%,理解 10.0%,记忆 1.8%。
布鲁姆金字塔被完整地倒了过来。
AI 在替学生干最高阶的活,而底下那几层——反复练、练到形成直觉的部分——反而空着。Anthropic 自己在报告里的评价很克制但很到位:倒过来的金字塔,是会翻的。
还有个配套数据:约 47% 的学生对话属于”直接型”,要答案、要成品,几乎不来回讨论。
那么,AI 能力这么强,为什么还需要老师?我的答案是四件事,而且这四件事在结构上就不是模型能力增长能解决的。
4.1 决定”什么时候不该帮”
这是最根本的一条。
大模型被训练成”有帮助”。你问什么它答什么,答得越完整越好——这是它的目标函数。而教学的目标函数在很多时刻恰恰相反:最有价值的干预是”忍住不给”。
认知科学里管这个叫合意困难(desirable difficulty):提取练习、间隔重复、适度的困惑感,这些在当下都让人不舒服、都让”表现”变差,但恰恰是它们制造了持久的学习。
问题在于,“该忍到什么程度”是一个需要判断的量,而判断的依据是老师对这个具体学生此刻状态的了解:他是卡在概念不通,还是卡在符号看不懂,还是纯粹昨晚没睡好?是快要突破了值得再撑五分钟,还是已经挫败到要放弃了得赶紧接一把?
Learning Mode 是这个方向上很好的一步,但它是全局的、无状态的:它对所有人、在所有时刻,用同一个力度反问。真正的教学要求的是动态调节的难度曲线,而调节这条曲线所需的信息,绝大部分根本没有进入聊天窗口。
用工程的话说:AI 现在能执行策略,但制定策略需要的观测量,它拿不到。
4.2 判断”你到底会没会”
这是第二条,也是被 AI 直接破坏掉的一条。
上面 ALEKS 那个研究已经把问题挑明了:当学生可以用 AI 完成任务,任何基于”任务完成情况”的评估都失效了。 作业分数、平台的掌握度、提交的项目——这些信号全部被污染。
而评估失效的后果不只是”没法打分”,是整个反馈回路断了。学生不知道自己哪里不会,老师不知道该讲什么,自适应系统不知道下一题该出什么。
重建可信评估的手段——口头答辩、白板推导、当场改需求、追问”你为什么选了这个方案而不是那个”、监考——没有一样能由 AI 独立完成,因为它们的本质是在一个 AI 无法介入的信道里做测量。这在定义上就必须有人在场。
我招人的时候现在只做一件事:给一段他自己写的代码,让他讲清楚为什么这么写、当时排除了哪些方案、如果需求变成 X 要改哪里。会不会写已经不是信息量最大的问题了,能不能对自己的选择负责才是。
4.3 决定”该学什么”
AI 能回答任何问题,但它不能决定哪个问题值得问。
这在我这行特别明显。一个想做量化的新人,面前有一百条路:深度学习、另类数据、高频微结构、期权做市、宏观 CTA。每条路上都有一堆看起来很厉害的东西。AI 会把每一条都给你讲得头头是道。
但“以你的背景、在这个市场环境下、给定你只有两年时间,该先啃哪一块”——这是一个需要品味、需要行业实感、需要对这个具体的人有判断的问题。它不是信息检索问题,甚至不完全是理性推理问题。
课程设计的本质是取舍,而取舍的依据是价值判断和局部经验。这恰恰是通用模型最弱的地方——它见过所有人的经验,因此没有任何一个人的处境。
4.4 让人愿意坐下来吃苦
最后一条最俗,但骗不了人。
学习的瓶颈从来不是”找不到解释”。B 站上什么都有,MIT 的公开课挂了十几年,现在还有一个 24 小时不烦不累、比大多数助教都耐心的 Claude。
瓶颈是你愿不愿意在难受的时候再坐十分钟。
而这个”愿意”,历史上主要靠三样东西支撑:有人在等你的进展、有人会因为你做出来而高兴、有人对你有一个你还没达到的期待。这些都是关系。AI 目前提供不了——不是因为它不够聪明,是因为它没有利害相关性。你放它鸽子,什么都不会发生。
老师自己已经用脚投了票
有意思的是,这四条在教师的实际使用行为里,有一个非常干净的印证。
Anthropic 分析了约 74,000 条高校教师与 Claude 的对话,把每一次使用标记为”增强”(人和 AI 一起做,人留在回路里)还是”自动化”(整件事直接交出去):
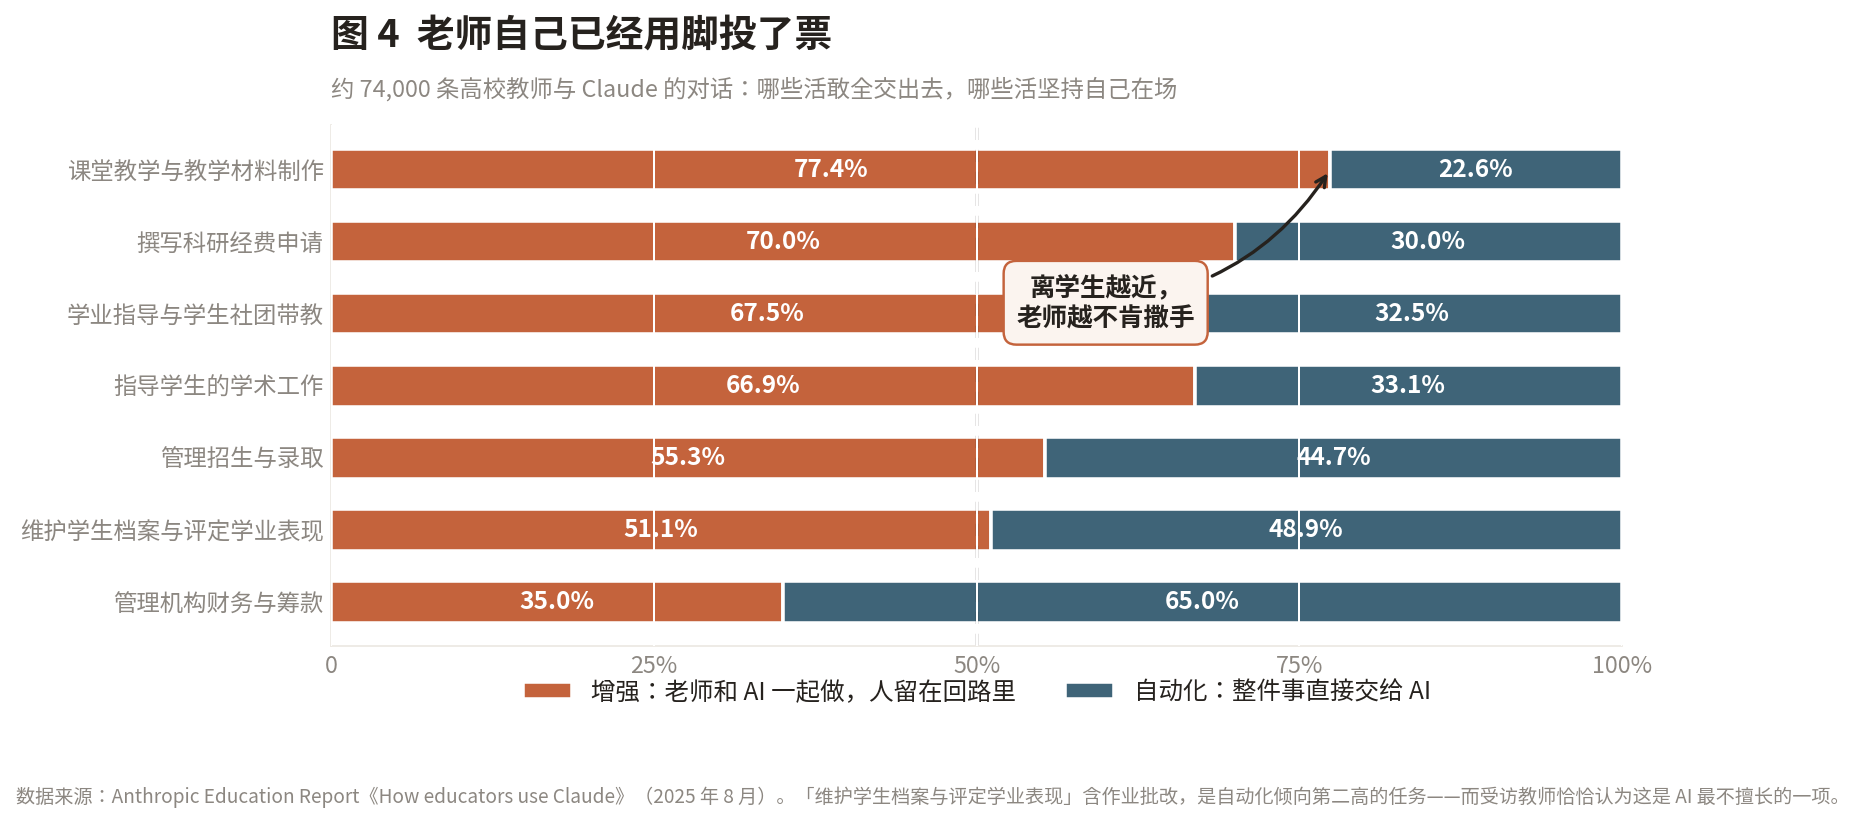
规律清楚得不像话:离学生越近的活,老师越不肯撒手。
课堂教学和教学材料制作,77.4% 是增强;学业指导、指导学生学术工作,都在 67% 上下。而机构财务与筹款,65% 直接自动化。
没有人开会讨论过这条边界,它是几万个老师各自做决策之后自然浮现出来的。 我觉得这比任何一份专家共识都更有说服力。
(报告里也有个刺眼的数字:涉及作业批改和学业评定的对话,48.9% 是自动化倾向——是自动化第二高的任务。而同一批受访教师恰恰认为,批改是 AI 最不擅长的一项。认为不该做,和实际在做,中间那道裂缝,就是现在教育界最真实的焦虑。)
五、落到操作层
说了这么多,给三类人各留一份可执行的清单。
如果你是学生 / 自学者:
- 先做后问。 卡住之前不要打开 AI。真正有学习价值的那几分钟,正好发生在你卡住、还没放弃的那个窗口里。
- 让它出题,不让它答题。 把 AI 的产能全部用在扩大练习量上。
- 要求”只说问题,不给代码”。 一句话的约束,效果差一个量级。
- 每两周断网考一次。 你在 AI 辅助下的水平是样本内的。没有样本外估计,你对自己的能力评估就是一条漂亮的回测曲线。
如果你在带人 / 教书:
- 把 AI 用在材料生产上,把自己留在难度设计和评估上。 这两件事的边界,就是图 4 那条 50% 线。
- 重建不可污染的评估信道。 口头答辩、白板推导、当场改需求。这是现在最值钱的教学工作,没有之一。
- 别把批改整条外包。 数据显示很多人在这么干,而他们自己也知道不该这么干。
- 重新设计作业,而不是禁用 AI。 报告里有位教授说得挺好:如果 AI 能独立完成这份作业,那该反省的不是学生。
给所有人的一条:
Anthropic 2026 年 3 月的经济指数报告里有个发现值得记一下:使用 Claude 超过半年的用户,任务成功率比新用户高约 10%,而且在控制了任务类型、模型、国家之后依然成立。
也就是说,“会用 AI”本身就是一项需要时间习得的技能,而且存在明显的学习曲线。
这句话有点悖论意味,但它是这篇文章最好的收尾:连”如何学习 AI 的使用”本身,都需要被教。
六、结语
回到标题的问题。
“人工智能啥都知道,为什么还需要老师”——这个问句里藏着一个陈旧的假设:老师的价值在于知道得比学生多。
如果这个假设成立,那老师这个职业确实已经被判了死刑,而且死因不是 AI,是 1990 年代的搜索引擎。
但看完上面那些数据,我的判断正好相反。AI 越强,老师越重要,只是重要的地方全变了。
当获取答案的边际成本归零,稀缺的东西就从”答案”转移到了:
- 判断什么时候不该给答案;
- 设计能测出真实能力的评估;
- 决定在无穷多可学的东西里,先学哪一个;
- 以及,让一个人在难受的时候愿意再坐十分钟。
这四件事,没有一件是”知道得多”。
所以我更愿意这么说:老师的岗位没有消失,只是从”知识的搬运工”变成了”认知负荷的设计师”。
那个 -17% 和那个 +1.3 个标准差,用的是同一个模型。中间隔着的,全部是人的判断。
而只要那个判断还是稀缺的,这个职业就还在。

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 10
 0
- 0


 已为社区贡献13条内容

所有评论(0)