Claude Opus 4.7 刚更新,我先看到的不是变强,而是变贵了
如果大家想自己上手试一下最新的 Opus 4.7,也可以直接用我正在用得 Unity2.Ai 公测入口。它支持标准 OpenAI 和 Anthropic 格式,接插件、IDE 和各类现成工具比如 codex、claude code、opencode 会比较省事,适合想尽快跑起来的人。
Anthropic 在 2026 年 4 月 16 日发布了 Claude Opus 4.7。
我看完整篇公告后的第一反应,不是“模型又变强了”,而是两件更现实的事:它开始更像一个能真正放进生产流程里的工具,同时也很可能会比上一版更贵。
如果要我先下一个判断,我会这么说:
Claude Opus 4.7 最值得关注的,不是单项能力再抬高了一点,而是它在复杂任务里的稳定性、可控性和完成度更强了,但代价也更直接了:token 消耗可能升到原来的 1 到 1.35 倍。
我最先注意到的,不是“更强”,而是“更能把事做完”
Anthropic 这次反复强调一个点:Opus 4.7 更适合处理复杂、长时间运行的任务,而且更会在输出前做自我检查。
我觉得这比一句“代码能力提升”更重要。
因为过去很多模型的问题,不是起步不行,而是跑到中段开始失真:上下文丢了、工具调错了、任务做了一半拐到别处去了,最后还一本正经地给你交答案。真正影响体验的,往往不是第一步会不会,而是它能不能把一件复杂的事完整推进下去。
从这个角度看,Opus 4.7 这次更像是把模型能力从“能做”往“能做成”推了一步。
这对我来说,是最核心的变化。
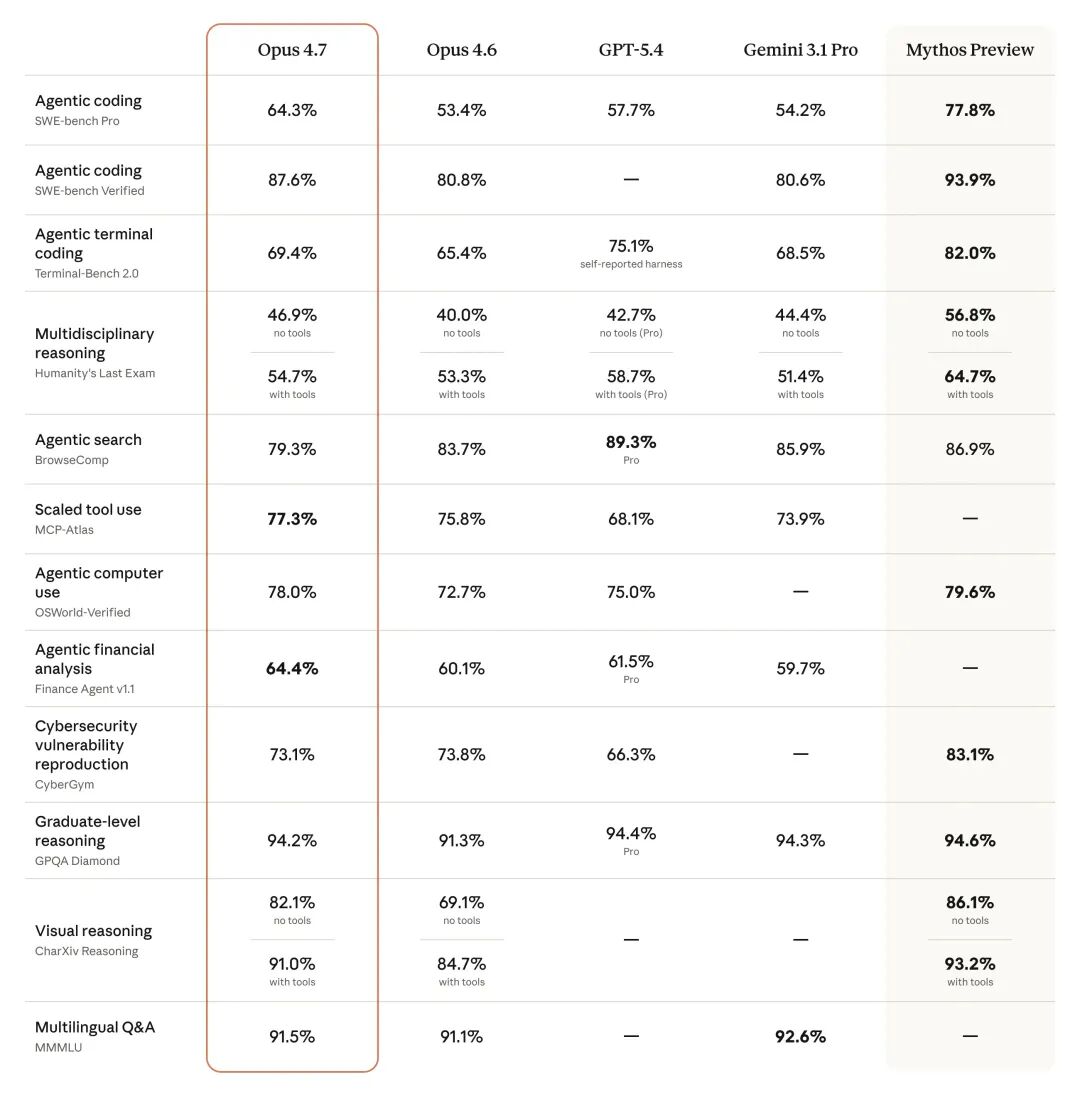
如果我拿它来写代码,我会更在意这几个点
Anthropic 官方的说法很直接:Opus 4.7 在最难的软件工程任务上,比 Opus 4.6 更强。
但如果只停在这句话,其实没什么意思。真正有价值的是后面那层含义。
我更看重的,不是它能不能一次性写出一段漂亮代码,而是它在长链路开发任务里,是不是更少跑偏,更能按要求执行,更愿意在交付前自己检查一遍。这三个点一旦成立,模型在开发流程里的位置就会变。
以前很多时候,模型像一个速度很快的初级同事,能帮我把第一稿冲出来,但我默认要重审一遍。
如果 Opus 4.7 真像公告里说的那样,在复杂任务里更稳定,那它带来的变化就不是“写得更快”,而是“我能把更多连续性工作交给它”。
这两者差别很大。
前者只是提效,后者才是在改工作方式。
视觉能力这次的升级,我觉得会被很多人低估
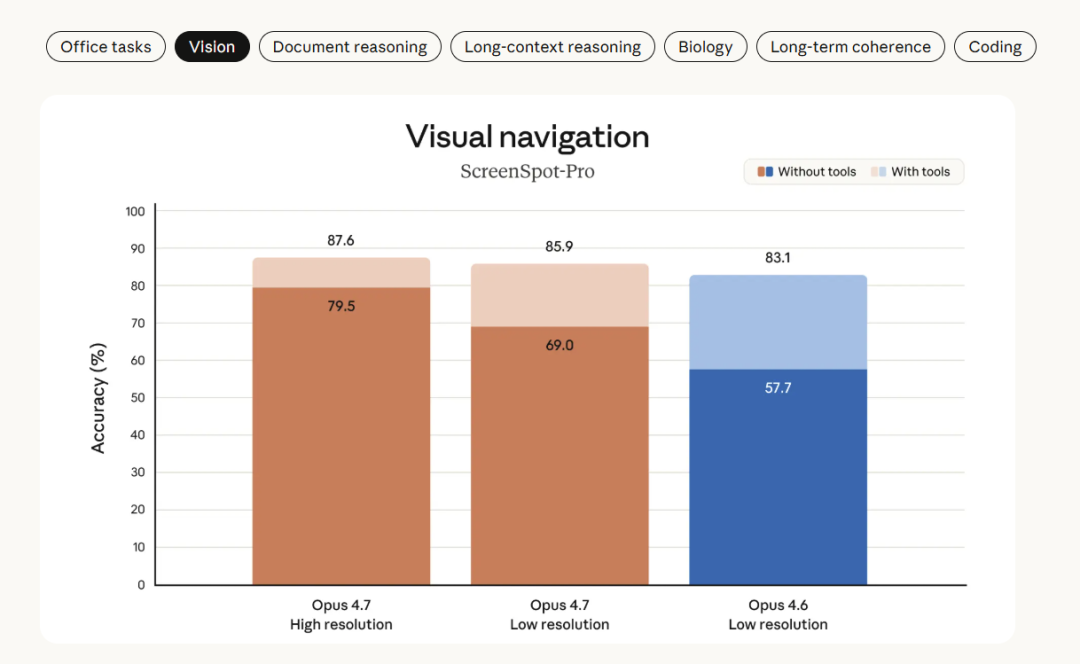
这次还有一个很容易被忽略的更新:Opus 4.7 支持更高分辨率的图像输入,长边最高 2576 像素,约 375 万像素,超过此前 Claude 模型的三倍。
很多人看到这里,可能只会把它理解成“看图更清楚了”。
但我觉得它真正影响的是一批很具体的工作场景,比如读复杂截图、看产品界面、分析图表、处理视觉密度很高的文档,或者根据页面参考图来生成更像样的文案、页面结构和演示内容。
说白了,这不是“多了一个能力”,而是让模型开始更像一个能处理真实工作材料的助手。
很多工作资料本来就不是纯文本,而是截图、表格、页面、图表、流程图、PPT 草稿。图像理解上限一旦抬高,模型能接的活就会明显变多。
我觉得这次另一个关键信号,是它更“听话”了
Anthropic 在公告里专门提醒,Opus 4.7 会比之前版本更字面地执行指令。
这个变化看起来很小,但我反而觉得它很关键。
一方面,这说明模型的可控性更强了。对开发者来说,可控比聪明更重要。一个很聪明但经常自由发挥的模型,实际并不好用。相反,一个边界清晰、执行稳定的模型,更容易接进真实流程。
另一方面,这也意味着老提示词不一定还能照搬。
以前一些比较松、比较模糊的写法,也许模型还能“猜着办”;但到了 Opus 4.7,这类写法可能反而会放大问题。
所以我会把这次更新看成一个提醒:不是模型升级了,提示词就能自动变好;很多时候,模型越强,反而越要求你把任务说清楚。
官方价格没涨,但实际用起来很可能更贵了
这次 Anthropic 没有上调价格,仍然维持和 Opus 4.6 一样的定价:每百万输入 token 5 美元,每百万输出 token 25 美元。
乍一看,这像是一个利好,因为它决定了这次更新不是一个“只适合围观”的发布,而是一个可以认真评估迁移成本的版本。
但这里也有个容易忽略的地方。Anthropic 同时提到,新 tokenizer 可能让同样的内容产生更多 token,大致会在原来的 1.0 到 1.35 倍之间;另外,高 effort 档位下,模型也可能产出更多推理 token。
这句话翻译成人话其实很简单:官方单价没涨,但如果同样一段任务要消耗原来 1 到 1.35 倍的 token,那实际使用成本大概率就是更高了。
所以如果让我给一个实操建议,我不会说“直接切过去就行”,而是会先重新测一遍真实任务成本。
表面价格没变,不代表你最后账单没变;从使用结果看,Opus 4.7 很可能就是更贵了。模型更强了,预算控制反而要更细。
我会把这次更新理解成:Anthropic 正在补齐一整套生产工具链
除了模型本身,Anthropic 这次还同步给了几个配套更新:
- 新增
xhigheffort 档位,放在high和max之间。 - Claude Platform 开始公测 task budgets。
- Claude Code 增加
/ultrareview命令,做更深入的代码审查。
我看这些更新时,感受很明确:他们已经不只是想做一个“回答更聪明”的模型,而是在往完整工作流里走。
模型负责推理,effort 控制深度,task budgets 控制成本,Claude Code 往工程执行和审查环节延伸。把这些连起来看,Opus 4.7 其实不是一个孤立版本,而是 Anthropic 整套产品策略的一部分。
如果这个方向继续走下去,未来比拼的就不会只是模型本身,而是谁能把“模型 + 工具 + 成本 + 安全”组合成一套真正可用的工作系统。
这次更新,最后让我得出的结论是什么
如果只看表面,Claude Opus 4.7 当然也是一次常规意义上的模型升级:代码更强、看图更清楚、专业任务表现更好。
但如果站在实际使用者的角度去看,我认为它真正带来的变化有三点:
- 模型更适合承担复杂、连续、需要校验的任务了。
- 模型开始更像生产工具,而不是单点问答工具。
- 官方单价没变,但因为 token 消耗可能升到原来的 1 到 1.35 倍,实际使用成本很可能更高了。
- 模型厂商竞争的重点,正在从“谁更聪明”转向“谁更稳定、谁更可控、谁更能落地”。
这也是为什么我看完这次发布后,会觉得 Opus 4.7 值得认真关注。
它不只是又更新了一版参数,而是在往“真正能干活”的方向,迈了一步。
最后
如果大家想自己上手试一下最新的 Opus 4.7,也可以直接用我正在用得 Unity2.Ai 公测入口。它支持标准 OpenAI 和 Anthropic 格式,接插件、IDE 和各类现成工具比如 codex、claude code、opencode 会比较省事,适合想尽快跑起来的人。注册地址:https://unity2.ai。

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 8
 0
- 0


 已为社区贡献35条内容

所有评论(0)