多开几个 Agent,为什么反而更难把活干好?---- 从 Claude Code、Codex 到 DeepSeek Harness,拆解多 Agent 的收益、成本与运行机制。
先把两个概念放回各自的位置
Claude Code 的 Agent Teams、Codex 的 Subagents、OpenCode 的子会话,以及 pi 和 DeepSeek Harness 的扩展机制,都让「多个 Agent 一起工作」成为具体的工程选择。但这些产品里的相似名字,并不对应同一套组织方式。
先核对一个容易被当成旧闻的事实:截至 2026-09-16,Claude Code 官方文档仍把 Agent Teams 标为实验特性,默认关闭,需要设置 CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1。这描述的是 Claude Code 的具体功能,不代表所有产品的多智能体能力都处于实验阶段。当前官方文档
这引出一个概念问题:Agent Team 和 Multi-agent,是不是一回事?
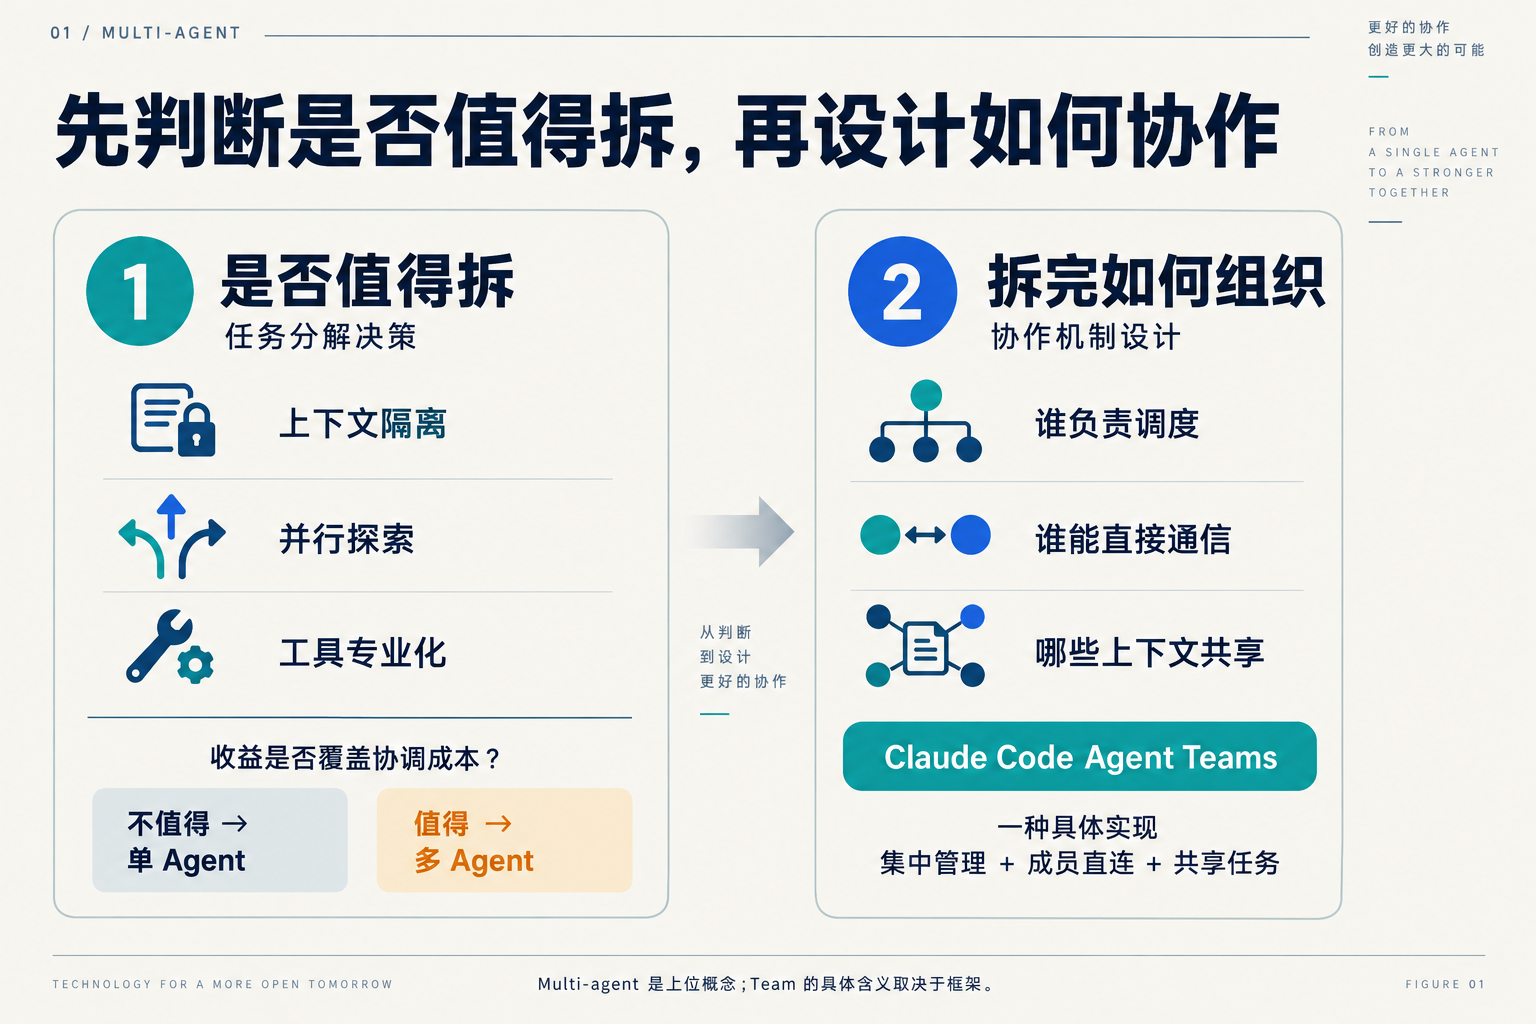
Multi-agent 是上位概念,Claude Code 的 Agent Teams 是其中一种具体实现。 泛称的 Team 并没有跨框架统一的定义,不能仅凭名字断定它采用什么拓扑。
标题把工程选型压成两道题:先判断「这件事值不值得交给多个 Agent」,再设计「它们如何分工、交换信息和推进任务」。这是便于讨论的决策顺序,不是 Multi-agent 与 Team 的严格术语定义;实际设计中,两道题需要反复校正。
把这两个问题分开,后面所有的对比才有地方安放。
第一层:Multi-agent 在解决什么
Anthropic 在 2026-01-23 发布的《Building multi-agent systems: When and how to use them》里讨论了三类常见拆分动机。这些原则仍有参考价值,但工具数量、成本倍数与模型能力需要在当前环境重新评估。原文
上下文保护。 当一类信息只在某个环节有用,之后全是噪声,可以考虑把它放进独立的上下文。官方给的例子是客服场景:取订单历史动辄 2000 多个 token,全量灌进主对话会污染后续的技术排查;交给一个专门的订单查询 Agent,回来的只是 50 到 100 个 token 的摘要。
并行化。 一个开放式问题的若干个侧面可以同时探,互不等待。Anthropic 自己的研究系统就是这么搭的:主控 Agent 分析查询、制定策略,派出多个子 Agent 并行调查不同侧面,再由主控综合。
专业化。 工具集和系统提示词收窄之后,可能改善工具选择和执行可靠性。官方给的判断信号很具体:一个 Agent 手里握着 20 个以上的工具、不相关工具之间出现领域混淆、每加一项新能力整体表现就退一步。
2025 年的研究系统实验曾提供多智能体收益的量化证据,但其中的模型配置和比较基线不能直接用于今天的 Coding Agent 选型。历史数字放在后文的成本口径中;判断当前方案,优先看实际任务上的验证结果。
所以第一层决策要看:更广的覆盖、更好的上下文管理或更短的等待,能否覆盖新增的推理与协调成本。并行也未必缩短总耗时——如果团队调查得更多,总工作量可能增长得更快。先建立单 Agent 基线,再用同一组任务比较成功率、总 token、耗时和返工次数。
第二层:拆完之后,分别看调度、通信和上下文
到这一步,多个 Agent 值得参与,但它们如何组织仍然需要设计。orchestrator、supervisor、crew、team、swarm、handoff 各有语境,不能仅凭名称判断架构。
第一,谁负责调度。 可以由主 Agent 委派,由固定规则决定顺序,也可以由当前 Agent 通过 handoff 选择下一位。按固定顺序轮流执行,不等于成员自主决定下一步。
第二,谁能直接通信。 成员可以只向调用方返回结果,也可以定向互发消息,或者在公共频道广播。能互发消息,不代表成员拥有创建团队、分配权限或更换负责人的权力。
第三,哪些上下文可见。 独立上下文窗口可以通过消息、共享文件或检索访问同一份资料;共享消息历史也不意味着系统提示词、工具结果和私有状态完全一致。真正要设计的是哪些内容完整传递、哪些摘要传递,以及谁可以重新读取原始证据。
这些机制可以组合:主控负责分配任务,成员之间仍可直连;成员有独立窗口,仍可共享任务文件。不能根据 Team、Swarm 或 Subagent 的名字,直接推断控制权、数据流和隔离边界。
Claude Code 的 Agent Teams 则是一个明确的混合形态:成员之间可以直接通信、认领任务,但 Lead 固定且唯一,团队管理仍集中在 Lead。更准确的描述是「集中管理 + 成员直接协调」。
还有一个会影响全文结论的细节:当前 Claude Code 的命名 Subagent 也能互发消息。因此,「能否互相说话」不能作为 Subagent 和 Agent Teams 的唯一分界,还需要比较会话形态、任务管理与工作流由谁负责。官方对照
把视野扩展到当前的 Coding Agent 与 Harness
比较 Codex、OpenCode、pi 和 DeepSeek Harness 时,还要补充一个概念:Harness 是支撑 Agent 运行的系统,包括工具执行、会话状态、上下文管理、权限、恢复和调度等能力。Team 描述成员如何组织;Harness 决定这种组织方式如何被执行和记录。单 Agent 也需要 Harness,多智能体编排可以由其内置功能、插件或外层程序实现。
因此,下面是一张实现机制对照表,而非把所有产品硬排成同类框架的榜单:
| 产品或运行时 | 当前可核验机制 | 对选型的意义 |
|---|---|---|
| Claude Code | Subagent 委派与 Agent Teams 并存;后者仍需显式开启 | 比较主会话整合与成员直接协调的差别 |
| Codex | 当前版本默认启用子代理能力;主任务负责创建、跟进、等待和汇总 | 并行委派可直接由编码工具提供,无须先引入独立编排框架 |
| OpenCode | 本文采用 V2 文档口径:primary/subagent 模式,子代理在新上下文的前台或后台子会话运行 | 角色、模型、权限与父子会话关系是可配置的边界 |
| pi | 核心有意不内置 Subagent,允许通过扩展或软件包加入 | 编排也可以按需装配,不能把某个插件的能力写成核心默认行为 |
| DeepSeek Harness | 开发者预览;模型、会话、调度等组件插件化,Standard 模式包含子代理和工作流 | 除了谁做什么,还要考察执行记录、上下文注入与恢复机制 |
来源:Codex Subagents、OpenCode V2 Agents、pi 官网、DeepSeek Harness 官方介绍。Claude Code 机制见上文官方链接。
这里有三处不能省略的限定。Codex 的「默认启用」指能力开关,不等于每个任务都会自动拆分;当前本地版本依用户或适用项目指令触发委派。OpenCode 的版本文档需要统一,不能把不同代际的配置与内置角色混写。DeepSeek Harness 是具体项目名称,与 DeepSeek 模型需要区分。
DeepSeek Harness 还把子代理调度和上下文注入纳入可检查的会话记录。这给比较增加了一个有用的问题:任务失败后,能否追溯当时谁看到了什么、调用了什么、在哪一步失去进展。它不能仅由一张成员关系图回答。运行记录说明
CrewAI 和 AutoGen 应放在什么位置
它们仍可用于解释编排机制,但需要更新背景。AutoGen 官方仓库已进入维护模式,不再新增功能,并建议新用户采用 Microsoft Agent Framework。继续把 AutoGen 当成新项目的默认代表会产生误导。维护声明
CrewAI 不能据此判为停止发展。 官方发布页在 9 月仍有更新,1.15.21 发布于 9 月 9 日。它偏向应用编排,本文重点则是开发者直接使用的 Coding Agent 与 Harness,讨论权重可以降低,但理由是主题适配度,而非未经测量的「已经没人关注」。发布记录
本文不据此判断市场份额。维护状态、发布频率、社区关注和真实采用量是不同指标,GitHub Star 或某个社区的讨论体感不足以替代它们。
第三层:落到 Claude Code,两种形态长什么样
Claude Code 提供 Subagent 和 Agent Teams 两种机制。它们都能用于构建多智能体工作流,组织方式不同。
Subagent:以委派和结果返回为主
Subagent 是受委派执行子任务的 Agent。自定义角色可通过 .claude/agents/(项目级)或 ~/.claude/agents/(用户级)的 Markdown 文件配置,用 YAML frontmatter 指定名称、描述、工具和模型;也存在内置、插件及会话级定义。配置文件描述角色,并不是运行中的 Agent 本身。官方文档
运行时的关键性质有三条。第一,非 fork 的 subagent 从全新隔离的上下文窗口启动,主对话的历史不会带过去。第二,工作完成后回到主会话的只是一份最终报告,冗长的中间过程留在子上下文里。第三,工作流通常由主 Agent 管理;命名 Subagent 可以通信,不能把汇报式理解为技术上禁止横向消息。
官方对它的定位说得很直白:当一个旁支任务会用搜索结果、日志、文件内容把主对话淹没,而这些内容之后不会再被引用时,就该用 subagent。当前文档列出的普通 Agent 工具调用默认并发上限为 20,嵌套深度默认 3 层,可用环境变量调整;这是版本相关默认值,不是所有运行方式的硬上限。
Agent Teams:集中管理与成员直接协调
Agent Teams 是另一套机制。团队由四个部件组成(官方文档):team lead 是主会话,负责拉起 teammate 和协调工作;teammates 是各自独立的完整 Claude Code 实例;task list 是共享的工作项列表,teammate 从中认领;mailbox 是 Agent 之间的消息系统。
实现细节解释了这套机制的能力边界。每个 Agent 的 mailbox 是一个 JSON 文件,落在 ~/.claude/teams/{team-name}/inboxes/{agent-name}.json;任务列表在 ~/.claude/tasks/{team-name}/;团队名由会话 ID 前八位派生,格式是 session-xxxxxxxx。任务认领用文件锁防止多个 teammate 同时抢同一个任务产生竞态。任务之间可以声明依赖,前置任务完成时后续任务自动解锁。共享任务列表的操作还取决于成员是否具有 Task 工具;缺少这些工具的成员通过消息协调。
交互上,可以绕过 lead,直接跟任何一个 teammate 对话。在 in-process 模式下,用上下方向键在 agent 面板里选中一个 teammate,回车进入它的会话,直接打字就是给它发消息。
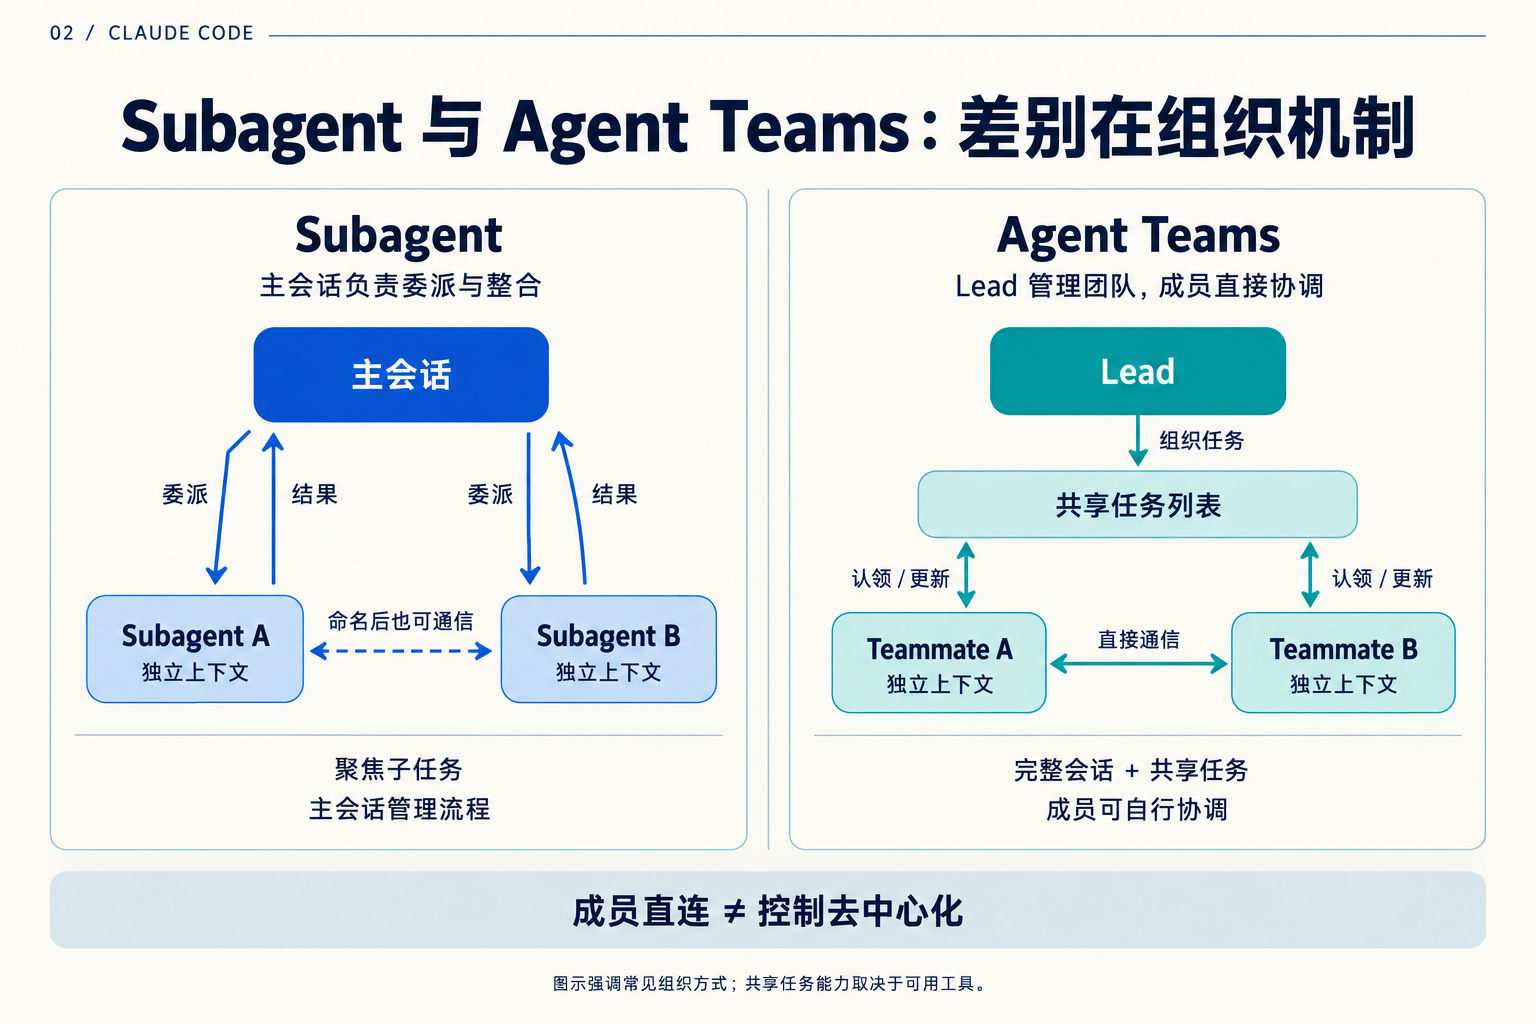
根据官方对照,核心区别可以概括为:
| Subagents | Agent Teams | |
|---|---|---|
| 上下文 | 独立窗口,结果返回调用方 | 独立窗口,可交换信息与访问共享资料 |
| 通信 | 向调用方返回结果;被命名的 subagent 之间也可互发消息 | teammate 之间直接互发消息 |
| 协调 | 主 Agent 管理工作流 | Lead 管理团队,成员通过消息与可用的 Task 工具协调 |
| 适合 | 只关心结果的聚焦任务 | 需要讨论与协作的复杂工作 |
| Token 成本 | 较低,结果摘要回主上下文 | 较高,每个 teammate 是一个独立实例 |
还有一条容易踩的联动:开启 agent teams 会改变普通委派的行为。 Claude 本来就会自己给 subagent 命名以便后续寻址,而在 agent teams 开启的状态下,一个被命名的 subagent 会以 teammate 的身份启动——官方原文是「teams can form even when you didn’t ask for one」(团队可能在没人要求的情况下就形成了)。三处例外:fork 调用、调用上显式传 isolation 的调用、-p 非交互模式(含 Agent SDK 会话),这几种情况下被命名的 subagent 仍按普通 subagent 跑。想退回去,在 settings.json 的 env 里设成 0 保存即可,不必重启;但项目设置、local 设置、--settings 与 managed settings 里的 1 优先级更高,仍会覆盖用户级的 0。
收益会重叠,协调方式才是选型重点
Subagent 和 Agent Teams 都能用于并行探索、上下文隔离与独立检查。区别在于组织这些工作需要多少直接交流和持续协调。
Subagent 的一个直接收益是保护主会话的上下文。 它的价值在于「噪声隔离」:跑测试、抓文档、处理日志,这些冗长输出留在子上下文里,只有结论回到主线。官方在成本文档里给的量化例子是 hook 场景——与其让 Claude 读完一万行日志,不如先过滤出 ERROR 行,上下文从几万 token 压到几百。Subagent 做的是同一件事的另一种形态。
Agent Teams 便于组织成员间的交叉讨论。 它可能帮助发现单一视角的遗漏,也适用于需要直接协调的并行实现。官方给的两个用例把这一点讲得很清楚。
一个是并行代码评审:派三个 teammate 分别盯安全、性能、测试覆盖,各自用不同的滤镜读同一份 PR,最后由 lead 综合。官方对它的解释是,单个评审者倾向于一次只盯一类问题。
另一个更有意思,是竞争性假设调试。官方给的提示词大意是:用户报告应用在第一条消息后就退出,派五个 teammate 去调查不同的假设,让它们互相对话、尝试证伪对方的理论,像一场科学辩论,最后把形成的共识写进结论文档。
这个用例希望缓解顺序调查中的锚定偏差:先探索的理论可能影响后续判断。不过,独立上下文不等于证据来源独立,更不等于错误相互独立。多个 Agent 也可能重复同一个错误前提,或者在讨论中形成过早共识。
作者建议:让成员先记录各自的假设与证据,再交换结果;争议应落到可复现的测试、原始材料和明确的验收标准。主 Agent 配合独立验证 Subagent,也能实现交叉检查。只有当成员需要反复互通发现、协商依赖或认领后续工作时,Agent Teams 的协调机制才更有价值。
比旧的拓扑分类更值得补充的三项材料
2026-02-05:并行编译器实验。 Anthropic 的 C 编译器项目展示了多会话并行,也记录了所有成员碰到同一阻塞、重复修复的失败。作者通过改造测试方式重新形成可并行任务。这里用到自建循环与测试设施,不能直接把项目成果归因于开启 Claude Code 的某个开关。工程记录
2026-03-24:长期应用开发的 Harness 设计。 Anthropic 使用 planner、generator、evaluator 分工,又随着模型改善逐项削减外部流程。这也提醒我们,「按职能分工通常无效」不能变成禁令:如果有明确规格、结构化交接和有效评估,角色分离可以产生收益;模型升级后,这些组件是否仍有价值还应重新测量。工程记录
2026-09-01:Harness-of-Harness。 这篇预印本直接以 Codex、OpenCode、Pi 的既有 Harness 为基础,研究跨轮次的计划、实现与测试,以及实现期间测试和独立评价的分离。它把问题从「选什么队形」推进到「怎样让已有编码 Agent 持续改进」。实验采用特定模型与任务组合,尚不能据此宣布某个产品全面领先。论文与项目
这些材料共同支持一个工程判断:协作的效果既取决于分工,也取决于运行记录、任务恢复和反馈是否有效。 这是本文从具体案例得出的判断,不是按产品热度统计得到的行业排名。
三笔要算清的账
Token 账
官方成本文档给的数字是:teammate 在 plan mode 下运行时,agent teams 大约消耗标准会话 7 倍的 token,因为每个 teammate 维持自己的上下文窗口,并作为独立实例运行。
这项当前文档中的估计,也不能成为所有工具的固定倍率。历史材料里的数字应分别阅读:
| 来源与时间 | 数字的比较口径 | 适用边界 |
|---|---|---|
| Anthropic 研究系统,2025-06-13 | 多智能体约为普通对话的 15 倍 token | 研究系统的历史观察,不能当成当前编码工具的报价 |
| Anthropic 选型文章,2026-01-23 | 同等任务下,多智能体通常为单 Agent 的 3–10 倍 token | 经验范围,需要在具体工作负载上重测 |
| Claude Code 成本文档,本次核验日 | Teammate 在 plan mode 下,约为标准会话的 7 倍 token | 模式相关估计,不是所有团队规模的常数 |
来源:2025 年研究系统、2026 年选型文章。token 倍数还受到缓存、模型单价和工作量的影响,不能直接换算成金额倍数。
控本可以从小规模团队、聚焦的任务说明和按难度选择模型开始。Teammate 会加载项目上下文,任务说明应补足目标与必要证据,避免反复复制大段材料。任务完成后及时关闭不再需要的成员。
官方提醒,活跃 teammate 会继续消耗 token。但不能把它改写成「进程活着就按时间持续计费」:token 消耗取决于实际模型请求及输入输出;后台工作、收到消息或新的轮次都可能产生请求。订阅额度和 API 金额也应分开看。
官方最佳实践给过 3 到 5 个 teammate、每人约 5 到 6 个任务的经验建议。这是任务规模合适时的起点,不是为了使用团队而必须凑齐的人数和任务配额。
分解账
Anthropic 观察到,团队经常把分解方式选错,导致协调开销吃掉多智能体本该带来的收益。官方给两种切法贴的标签很克制:problem-centric decomposition 被标为「常常适得其反」——按工作类型切,功能一组、测试一组、评审一组;context-centric decomposition 被标为「通常有效」——按「需要共享同一份理解」来分组。
这里应区分两个问题:按上下文边界拆分,决定谁需要理解什么;按写入归属分配,减少并发冲突。 两者有关,但不等价。不同文件也可能围绕同一不稳定接口反复协调;只读评审则可以让多位成员读取同一份代码。
例如,一个成员负责某个模块的实现及其测试,通常比「一个写所有功能、另一个补所有测试」更容易保留设计意图。相反,有明确输入输出标准的黑盒验证可以独立分配。文件归属、工作区隔离和集成测试仍需单独安排。拆分原则
信息账
反复摘要和转述可能丢失信息,Anthropic 用 telephone game(传话游戏)描述这一类失败模式。原文关注的是按工作类型切分导致的频繁交接;这不意味着每次交接或所有顺序流程都必然损失信息。
作为历史对照,LangChain 基于 GPT-4o 的 τ-bench 改造实验曾发现,减少 supervisor 转述和调整交接信息可改善结果。但样本只需一个子 Agent 回答,基本不涉及复杂多跳协作。这份旧实验适合解释信息损耗,不宜继续承担当前 Coding Agent 选型排名的证据角色。历史实验
作者推断:中心化可以让责任和路由更集中,但并不自动保证调度确定性;额外转述也不必然损失信息。关键是保留原始结果、按需转发、使用结构化交接,并用任务评测检验代价。
通常不适合并行团队的任务
Anthropic 在研究系统工程博客中,基于当时模型能力点名了两类不适合的工作:需要所有 Agent 共享同一份上下文的任务,以及 Agent 之间依赖关系密集的工作流。编码任务也被单独拎出来——真正可并行的部分比研究任务少;文中对实时协调能力的判断也应放在那次研究的模型与时间背景下,不能直接视为所有当前产品的能力上限。
Claude Code 的官方文档在这一点上是一致的:顺序任务、同文件编辑、依赖繁多的工作,单会话或 subagent 更有效。
Claude Code 的已知限制
Agent teams 目前标注为实验特性,官方列出的限制里有几条会直接影响使用方式:
- in-process teammate 不支持会话恢复。
/resume和/rewind不会恢复 in-process teammate;恢复会话后 lead 可能去给已经不存在的 teammate 发消息,只能让它重新拉人。 - 任务状态会滞后。 teammate 有时忘记把任务标成完成,导致依赖它的任务卡住,需要人工确认并更新。
- 一个会话一个团队,不能嵌套。 teammate 不能再拉自己的 teammate,只有 lead 能管团队。
- lead 固定。 主会话终身是 lead,不能把 teammate 提为 lead,也不能转移。
- 权限在 spawn 时确定。 teammate 继承 lead 的权限模式(
dontAsk除外),spawn 时不能逐个设定,spawn 之后才能单独改。 - 关闭可能较慢。 teammate 要跑完当前请求或工具调用才退出。
- in-process teammate 不能起后台 subagent。 teammate 的后台工作活不过 lead 进程。
- 分屏依赖 tmux 或 iTerm2。 VS Code 集成终端、Windows Terminal、Ghostty 都不支持;默认的 in-process 模式任何终端可用。
还有一条不在 Limitations 小节、但同样影响体感:teammate 的权限提示会冒到 lead 会话里,需要在那里逐一批准;官方给的缓解办法是提前把常用操作加进权限白名单,以减少打断。
选型清单
判断顺序建议是这样:
- 先试单 Agent。 提示词写具体,工具配齐,上下文该清就清。多数任务到这里就结束了。
- 明确拆分收益。 上下文隔离、并行探索、工具专业化或独立验证,都可能成为理由。上下文够用,不代表并行一定没有价值。
- 先检查上下文与写入边界。 强依赖或同文件并发编辑优先集中处理,必要时串行委派。多人只读同一材料没有写入冲突,但仍要控制重复调查。
- 根据协调需求选择。 子任务明确、主会话能统一整合时,优先 Subagent;需要成员持续互通发现、协商依赖和认领任务时,再考虑 Agent Teams。多视角评审本身不要求使用团队。
- 按上下文边界分工。 明确每位成员的目标、可写范围、输入输出和验收标准;以完成任务所需的最小团队起步,评估后再扩大。
- 按任务难度选模型,设置停止条件。 跟踪实际 token、耗时与返工,完成后关闭不再需要的成员;不要把团队共识直接当成验收证据。
- 从只读任务开始练手。 官方建议新手从 PR 评审、库调研、问题排查这类不写代码的任务入门,先看到并行探索的价值,再处理并行实现的协调难题。
- 核查运行时能否支持这些安排。 能否查看各成员轨迹、恢复中断任务、约束写入范围、获得真实测试反馈,比单看有没有 Team 按钮更有判断价值。
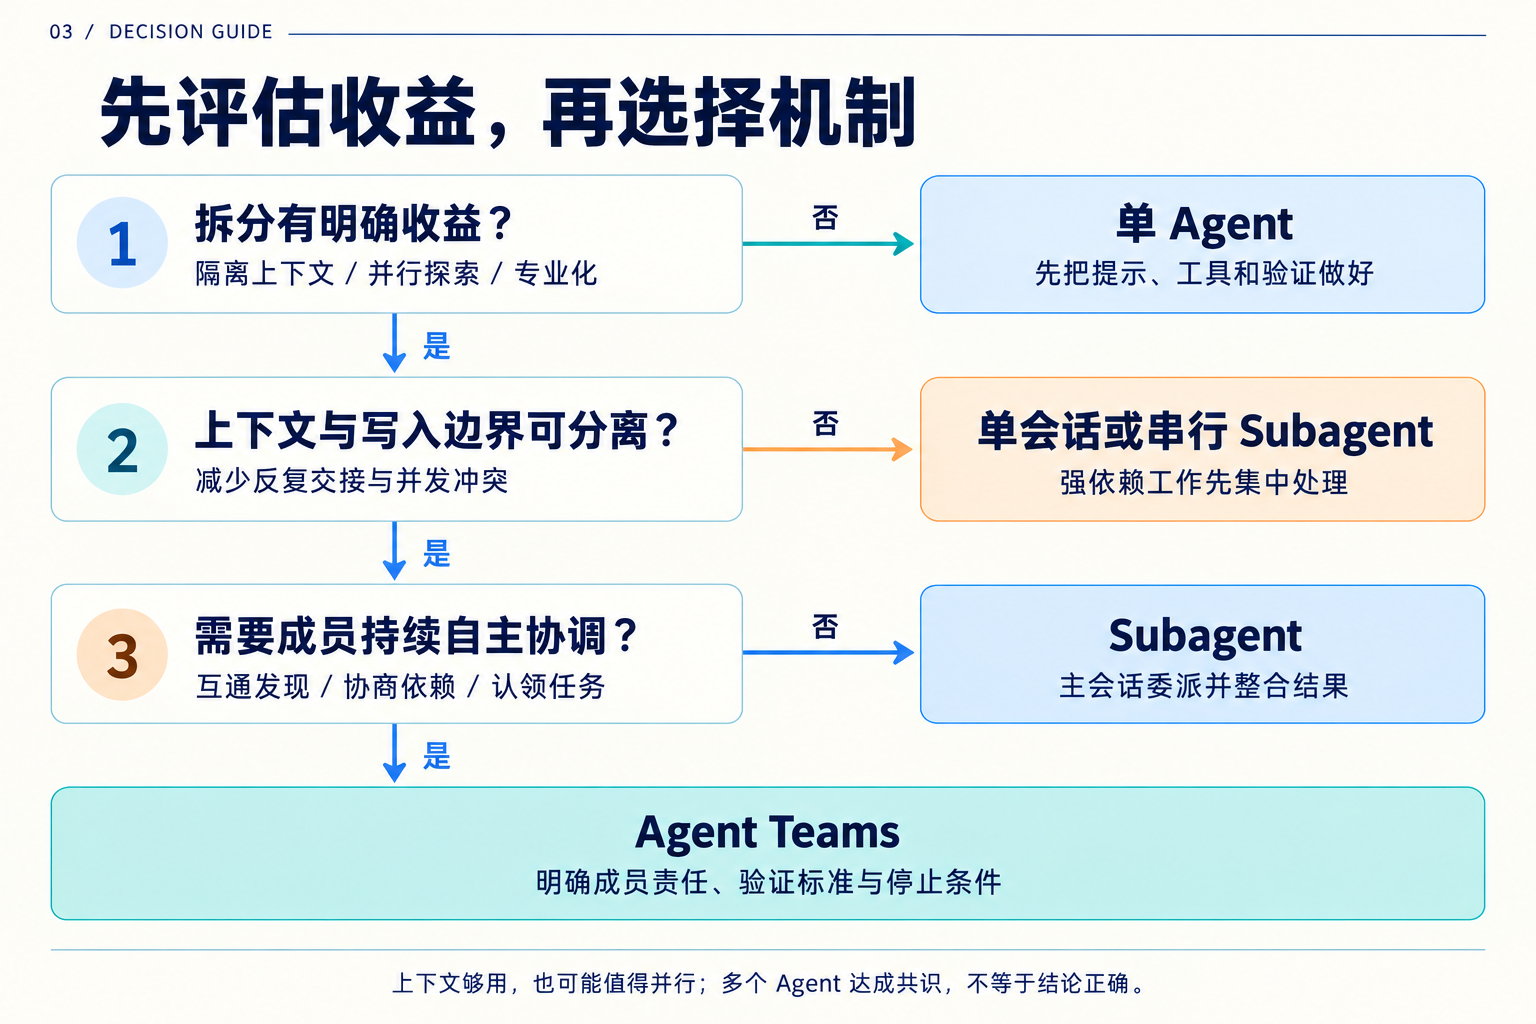
图 3 的具体选项对应 Claude Code。跨产品使用时,应按前文机制表映射到各自的内置能力或扩展,不能假定所有 Harness 都提供名为 Agent Teams 的功能。
一句话收束
先证明拆分值得,再设计成员如何协作,并检查 Harness 能否支撑它长期运行。Claude Code、Codex、OpenCode、pi 和 DeepSeek Harness 给出了不同的实现选择;最终收益仍要靠合理边界、原始证据和可复现验证来兑现。
来源
当前产品文档与维护状态
- Orchestrate teams of Claude Code sessions — Claude Code 官方文档
- Subagents — Claude Code 官方文档
- Manage costs effectively — Claude Code 官方文档
- Subagents — Codex 官方文档
- Agents — OpenCode V2 官方文档
- pi — 官方网站
- DeepSeek Harness — 官方介绍
- AutoGen — 官方仓库维护声明
- Microsoft Agent Framework — 官方仓库
- CrewAI 1.15.21 — 官方发布记录
2026 年工程案例与近期研究
- Harness-of-Harness — 2026-09-01,预印本
- Harness design for long-running application development — 2026-03-24,Anthropic
- Building a C compiler with a team of parallel Claudes — 2026-02-05,Anthropic
- Building multi-agent systems: When and how to use them — 2026-01-23,Anthropic
历史实验,仅用于解释机制与比较口径
- How we built our multi-agent research system — 2025-06-13,Anthropic
- Benchmarking Multi-Agent Architectures — 基于 GPT-4o 的 LangChain 实验
标签
Agent 多智能体 Claude Code AI 编程 架构设计

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 1
 1
- 0


 已为社区贡献2条内容

所有评论(0)