RK3588安卓上部署Qwen3-VL-2B多模态模型
Qwen3-VL-2B的部署分为两步:
- 第一步是将多模态的大语言模型中的视觉部分转为
rknn格式,即safetensors->onnx->rknn,其中onnx->rknn的过程依赖rknn-toolkit2工具; - 第二步是将多模态的大语言模型中的语言部分(LLM)转为
rkllm格式,即safetensors->onnx->rkllm,其中onnx->rkllm的过程依赖rkllm-toolkit工具
下载rknn,rknn-llm源码:
airockchip/rknn-llm 2.3.2版本
airockchip/rknn-toolkit2 1.3.0版本
搭建rknn 和 rkllm两个python环境:
搭建rknn:
conda create -n rknn python=3.8 -y
conda activate rknn
pip install rknn-toolkit2
搭建rkllm:
conda create -n rkllm python=3.10 -y
conda activate rkllm
cd rknn-llm
pip install -r ./rkllm-toolkit/packages/requirements.txt
pip install onnx=1.17.0
pip install transformers==4.57.3
这里transformers安装的版本,要降级一下,我这降级到了4.57.3,为了导出正确的onnx模型!!!
高版本的transformers,在导出时,找不到visual(self.vpm = vlm.visual),仍然能通过将self.vpm = vlm.visual改为self.vpm = vlm.model.visual,能成功导出onnx,并转为rknn,但是导出的模型结构已经变了,在板端程序运行时会报:段错误
------------------------------------------------
第一步:下载Qwen3-VL-2B模型
任意环境下运行下面命令:
pip install modelscope
modelscope download --model Qwen/Qwen3-VL-2B-Instruct
模型下载在:C:\Users\***\.cache\modelscope\models\Qwen--Qwen3-VL-2B-Instruct\snapshots\master
也可以用下面程序,在电脑上测试一下
# from transformers import Qwen3VLForConditionalGeneration, AutoProcessor
from modelscope import Qwen3VLForConditionalGeneration, AutoProcessor

# default: Load the model on the available device(s)
model = Qwen3VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen3-VL-2B-Instruct", dtype="auto", device_map="auto"
)

# We recommend enabling flash_attention_2 for better acceleration and memory saving, especially in multi-image and video scenarios.
# model = Qwen3VLForConditionalGeneration.from_pretrained(
#     "Qwen/Qwen3-VL-2B-Instruct",
#     dtype=torch.bfloat16,
#     attn_implementation="flash_attention_2",
#     device_map="auto",
# )

processor = AutoProcessor.from_pretrained("Qwen/Qwen3-VL-2B-Instruct")

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

# Preparation for inference
inputs = processor.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_dict=True,
    return_tensors="pt"
)
inputs = inputs.to(model.device)

# Inference: Generation of the output
generated_ids = model.generate(**inputs, max_new_tokens=128)
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text)
第二步:模型转为onnx
使用rkllm虚拟环境,export_vision.py脚本,导出onnx模型
cd rknn-llm/examples/multimodal_model_demo
python export/export_vision.py \
--path ***/.cache/modelscope/models/Qwen--Qwen3-VL-2B-Instruct/snapshots/master \
--model_name qwen3-vl \
--height=224 \
--width=224 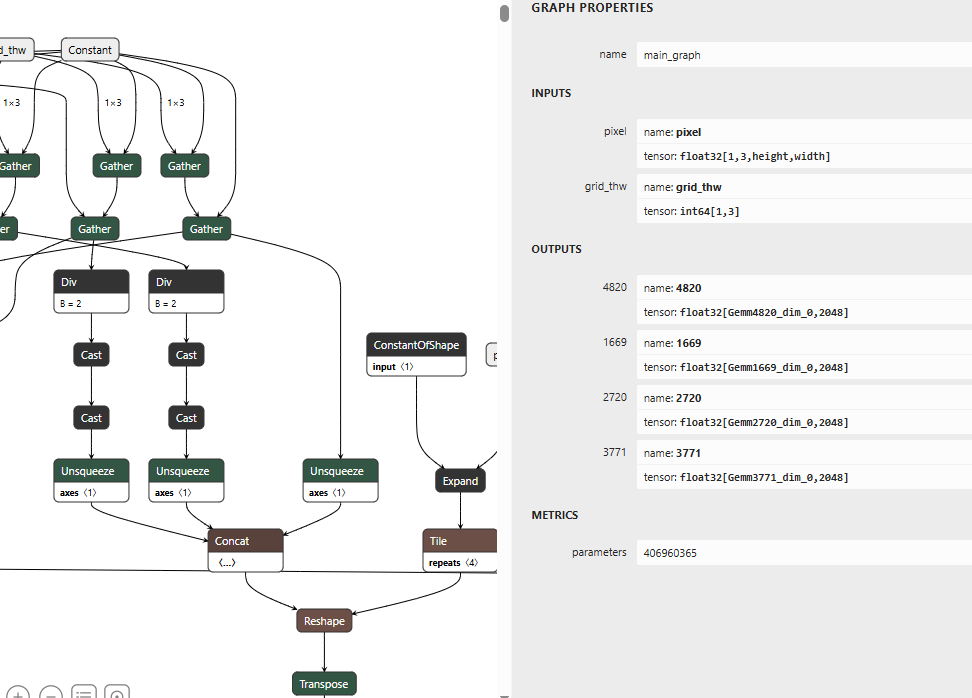
第三步:onnx转rknn
使用rknn虚拟环境,export_vision_rknn.py脚本,转换为rknn模型
python export/export_vision_rknn.py \
--path onnx/qwen3-vl_vision.onnx \
--model_name qwen3-vl \
--height  224 \
--width 224 \
--target-platform rk3588
生成了qwen3-vl_vision_rk3588.rknn,视觉模块+投影模块的转换已完成
第四步:准备量化用的校准数据
使用rkllm虚拟环境,make_input_embeds_for_quantize.py脚本
python data/make_input_embeds_for_quantize.py \
--path ***/.cache/modelscope/models/Qwen--Qwen3-VL-2B-Instruct/snapshots/master \
--model_type qwen3vl
会在data文件夹下生成,llm_inputs文件夹和llm_inputs.json文件
第五步:量化并导出rkllm
使用rkllm虚拟环境,export_rkllm.py脚本
修改export_rkllm.py脚本,将dataset = 'data/inputs.json' 修改为 dataset = 'data/llm_inputs.json'
前面搭建rkllm环境时,没有安装rkllm_toolkit,先安装,再执行export_rkllm.py脚本
pip install rkllm-toolkit/packages/rkllm_toolkit-1.2.3-cp310-cp310-linux_x86_64.whl
cd examples/multimodal_model_demo
python export/export_rkllm.py \
--path ***/.cache/modelscope/models/Qwen--Qwen3-VL-2B-Instruct/snapshots/master \
--target-platform rk3588 \
--num_npu_core 3 \
--quantized_dtype w8a8 \
--savepath qwen3-vl-2b-instruct_w8a8_rk3588.rkllm
生成了qwen3-vl-2b-instruct_w8a8_rk3588.rkllm,LLM模块导出完毕
第六步:编译板端demo
我是用的安卓系统,需安装安卓系统的交叉编译链,下载地址:
NDK 下载 | Android NDK | Android Developers
demo位于:rknn-llm\examples\multimodal_model_demo\deploy
build-android.sh中设置的android-ndk-r21e,我也下载的android-ndk-r21e编译链,放在/opt下
修改build-android.sh,将ANDROID_NDK_PATH=~/opts/android-ndk-r21e 改为
ANDROID_NDK_PATH=/opt/android-ndk-r21e
cd rknn-llm/examples/multimodal_model_demo/deploy
chmod +x build-android.sh
./build-android.sh
编译完后,会生成install/demo_Android_arm64-v8a文件夹
第七步:在板端运行
将demo_Android_arm64-v8a,放入板端中
将qwen3-vl-2b-instruct_w8a8_rk3588.rkllm 和 qwen3-vl_vision_rk3588.rknn 放入板端的demo_Android_arm64-v8a中。
运行:
chmod +x demo
export LD_LIBRARY_PATH=/***/demo_Android_arm64-v8a/lib
./demo demo.jpg ./qwen3-vl_vision_rk3588.rknn ./qwen3-vl-2b-instruct_w8a8_rk3588.rkllm 256 2048 3 rk3588
会报错,缺少libomp.so,回到编译链中,将libomp.so拷贝到板端,重新运行即可!

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)