Harness Engineering学习四 —— LangChain 的实践
通过Harness Engineering改进Deep Agents
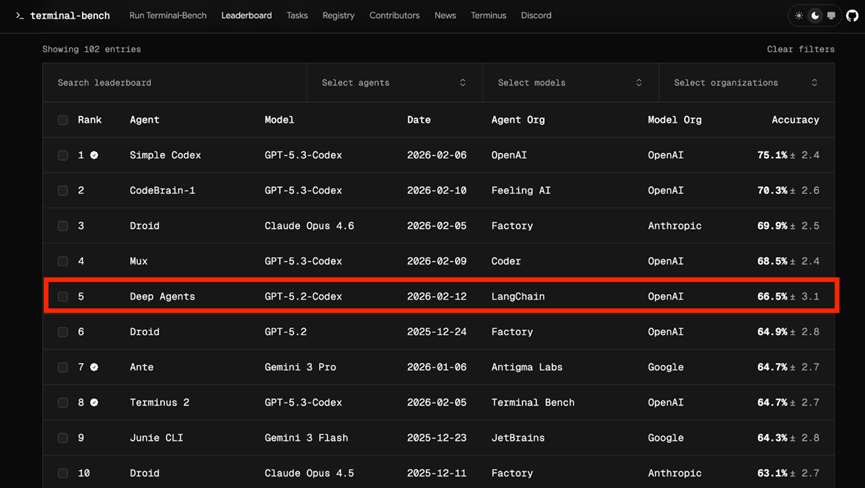
我们的编码智能体在Terminal Bench 2.0中的排名从第30位跃升至第5位。我们仅对Harness进行了调整。以下是我们Harness工程的方法(预告:自我验证和跟踪非常有帮助)。
1 Harness功能目标
Harness的目标是为我们所关心的任务塑造模型固有的尖端智能。Harness工程涉及系统,你在围绕模型构建工具,以优化任务性能,token效率,延时等目标。设计决策包括系统提词、工具选择,和运行流。
如何通过修改Harness来改进智能体呢?在LangChain,我们使用Trace来大规模理解智能体的失效模式。如今的模型在很大程度上是黑箱模型,其内部机制难以解释。但我们可以在文本空间中看到它们的输入和输出,然后将其用于我们的改进循环中。
我们使用了一个简单的方法来迭代改进deepagents-cli(我们的编码智能体),使其在Terminal Bench 2.0上从52.8提高到66.5,提高了13.7个百分点。我们仅对Harness进行了微调,而模型gpt-5.2-codex保持不变。
2 Harness实验设置和旋钮
Terminal-bench 2.0是当前的一个标准测试基准,用于评估智能体化编程。有89个跨领域的任务,如机器学习、调试、生物学。我们使用Harbor来编排运行。它会启动沙盒(Daytona),与我们的智能体循环交互,并执行验证+评分。
每个智能体的活动都存储到LangSmith平台。包括延时、token数量、费用等度量指标。
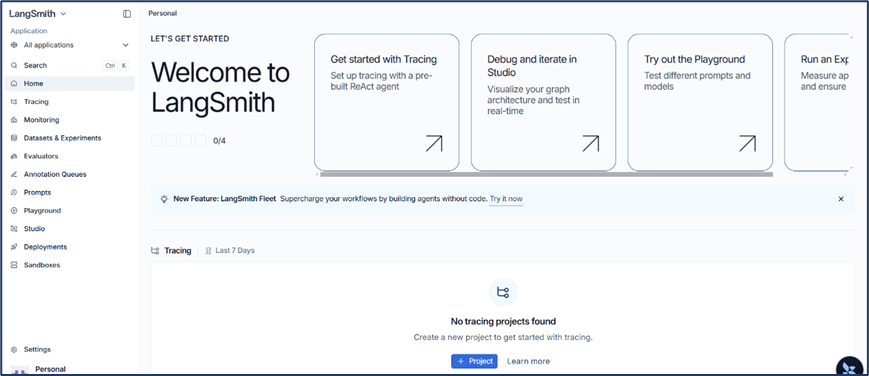
LangSmith Web页面
2.1 可调旋钮
智能体Harness有许多调节旋钮(功能):系统提词、工具、钩子/中间件、技能、子智能体代理、记忆系统等。我们有意地压缩了优化空间,并重点关注三个方面:系统提词、工具、中间件(用来指代围绕模型和工具调用的钩子的术语)。
我们从默认提词和标准工具+中间件开始。使用GPT-5.2-Codex时,这一组合的得分为52.8%。这是一个不错的分数,刚好在今天排行榜的前30名之外,但仍有提升的空间。
|
运行 |
修改了什么 |
评分 |
|
基线 |
用于编码、文件系统工具、制定计划等的基础提词 |
52.8% |
|
自定义提词&中间件 |
聚焦构建-验证循环、注入环境上下文。添加循环保护,以及超时报警 |
63.6% |
|
自适应推理 |
xhigh + high推理(推理的三明治策略) |
66.5% |
2.2 Trace分析器技能
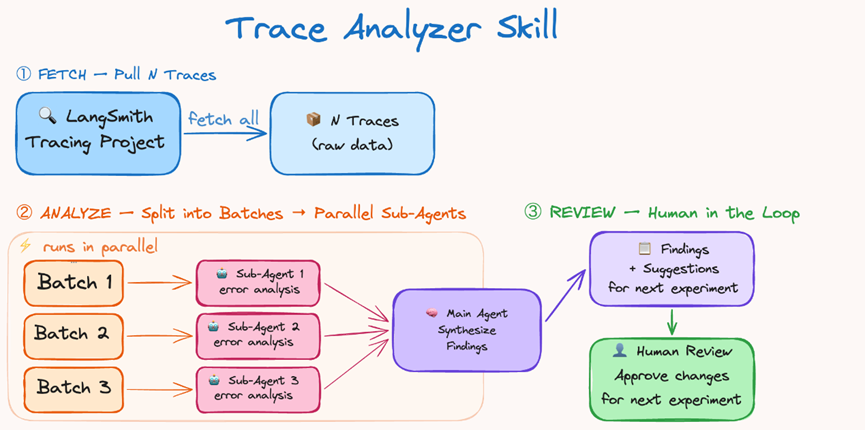
我们希望Trace分析具有可重复性,因此我们将其设计为一项智能体技能(技能是可以被重复使用的技术、方法、策略)。这可作为我们分析各次运行中的错误,并对Harness进行改进的方法。流程如下:
1)从LangSmith获取实验Trace;
2)生成并行的错误分析智能体 → 主智能体综合分析结果 + 提出建议;
3)汇总反馈并对Harness进行有针对性的修改。
这与机器学习中的Boost算法训练类似,后者聚焦之前运行中的错误。第3步中,人工验证和讨论提出的修改会非常有帮助(尽管不是必需)。对某一任务的修改过拟合是不利于泛化的,甚至可能导致在其他任务上的表现退步。
自动的Trace分析节省了数小时时间,并使得快速尝试实验变得容易。我们即将发布这项技能,目前正在对其进行广泛地测试,用于提词优化。
3 究竟什么提升了智能体性能
自动化的Trace分析使我们能够找出智能体出错的地方。问题包括推理错误、不遵循任务指令、缺少测试和验证、运行超时等。以下是部分改进措施。
3.1 构建&自我验证
如今的模型都是卓越的自我完善机器。
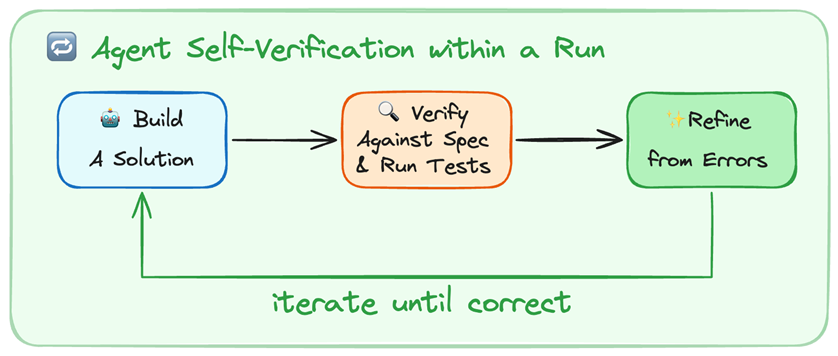
自我验证使智能体能够在运行过程中通过反馈实现自我改进。然而,它们并没有自然地倾向于进入这种构建-验证循环。
最常见的失败模式是,智能体编写了一个解决方案,重新阅读自己的代码,确认看起来没问题,然后就停止了。测试是自主智能体化编码的关键部分。它有助于测试整体正确性,同时为智能体提供登山算法的信号。
我们在系统提示中增加了关于如何解决问题的指导:
- 计划和发现:阅读任务、扫描代码库,基于任务规格和如何验证解决方案来制定初始计划;
- 构建:实现计划时,要考虑到验证环节,如果测试不存在,则构建测试,并测试正常路径和边缘情况;
- 验证:运行测试,查看完整输出,与所提问题(而非你自己的代码)进行对比;
- 修复:分析所有错误,重新审视原始规格,并修复问题。
我们非常重视测试,因为它推动了每次迭代的变更。我们发现,除了提词外,确定性上下文注入还能帮助智能体验证其工作。我们使用PreCompletionChecklistMiddleware中间件,它在智能体退出之前进行拦截,并提醒它对任务规范进行一次验证。这与拉尔夫·威格姆环(Ralph Wiggum Loop)类似,在该循环中,一个钩子(hook)会强制智能体在退出时继续运行,我们利用这一点进行验证。
3.2 智能体上下文环境
Harness工程的一部分是为上下文工程构建一个良好的发布机制。终端任务具有目录结构、内置工具、严格的超时限制。
- 目录上下文和工具:智能体启动时运行LocalContextMiddleware中间件,用于映射当前工作目录(cwd)以及其他父目录和子目录。运行bash命令来查找工具,如Python部署。上下文发现和搜索容易出错,因此注入上下文可以减少出错,并有助于智能体融入其所在环境。
- 指导智能体写出可测试代码:智能体不知道它的代码如何具备可测性。我们添加提词,说明他们的工作将通过程序化测试进行评估,类似于提交代码时的评估。例如,任务规格中提及的文件路径应严格遵守,以确保解决方案在自动评分步骤中有效。提词强调边缘情况,有助于避免智能体仅检查“常规路径”的情况。强制模型符合测试标准,是避免随时间推移而出现“性能下降”的有效策略。
- 时间预计:我们注入时间预计警告,以督促智能体完成工作,并转向验证阶段。智能体在时间估计方面表现不佳,因此这种启发式方法在这种环境中很有帮助。现实世界中的编程通常没有严格的时间限制,但如果不加入时间约束,智能体就无法在规定时间内完成任务。
智能体知道越多关于环境、约束、评估指标,就越能自动地进行自我工作指导。
Harness工程目标:准备和发布上下文,使得智能体能够自动完成工作。
3.3 鼓励智能体退一步并重新考虑计划
一旦智能体决定了一个导致“恶性循环”的计划,它会变得短视,对同一个错误的方法进行微小的调整(在某些轨迹中甚至会进行10次以上的调整)。
我们使用LoopDetectionMiddleware中间件通过工具调用钩子,跟踪每个文件的编辑次数。在对同一个文件进行N次编辑后,添加诸如“…考虑重新考虑你的方法”这样的上下文提示。这有助于智能体从死循环中恢复出来,尽管如果模型认为其判断是正确的,它仍会继续沿着相同的路径运行下去。
重要提醒:这是一种设计启发式,解决当前工程师所认知的模型问题。随着模型的改进,这些防护措施可能变得不再必要,但目前它们有助于智能体正确地和自主地运行。
3.4 选择在推理上投入多少计算资源
推理模型可以自动运行数小时,因此,我们需要决策在每个子任务上投入多少计算资源。你可以在每个任务上使用最大推理预算,但大部分工作可以从优化的推理计算资源投入中受益。
终端超时限制需要进行权衡。更多的推理有助于智能体评估每一步工作,但消耗的token或时间会增加两倍以上。gpt-5.2-codex有4个推理模型:low, medium, high, 和xhigh。
我们发现,推理有助于制定计划,以充分理解问题,一些终端任务非常困难。一个好的计划有助于更快地找到可行的解决方案。
后续阶段的验证工作同样从更多的推理中获益,捕获错误,以及提交解决方案。作为一种启发式方法,我们选择xhigh-high-xhigh形式的“推理三明治”作为基线。
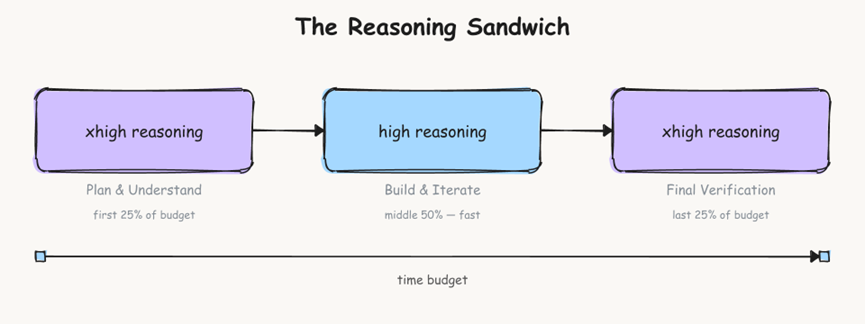
投入更多推理计算资源在规划和验证工作上。
只运行xhigh,得分53.9%。只运行high得分63.6%。采用推理三明治方法,得分达到66.5%
模型的自然方法是自适应推理,这在Claude和Gemini模型中可见一斑。在这些模型中,模型自行决定在推理上投入多少计算资源。
在多模型Harness中,平衡推理预算的方式可能是使用大型模型进行规划,然后切换到较小的模型进行实施。
4 构建智能体Harness的实践要点
智能体的设计空间很大。以下是我们从实验中总结出的一些通用原则,以及构建深度智能体的总体思路:
- 智能体上下文工程:对于今天的智能体而言,上下文集成仍然是困难的,尤其在未见过的环境中。内置带有诸如:目录结构、可用工具、编码最佳实践和问题解决策略的模型,有助于减少因搜索不当和规划失误而导致的错误。
- 助力智能体自检工作:模型倾向于其首个看似合理的解决方案。积极鼓励他们通过运行测试和优化解决方案来验证自己的工作。这对于无人在环的自动编程系统来说尤其重要。
- Trace作为反馈信号:Trace使智能体能够自我评估和自我调试。同时调试工具和推理过程非常重要(例如:因为缺乏工具或如何操作的指令,模型运行到错误路径上)。
- 短时间内检测并修复不良模式:当前模型并不完美。Harness设计师的工作是给未来更智能的模型制定规划时,围绕的是当前存在不足之处的模型进行设计。盲目重试和不验证工作成果就是很好的例子。这些护栏几乎肯定会随着时间的推移而消失,但为了构建稳定的智能体应用,它们是值得一试的有用工具。
- 为模型定制Harness:Codex和Claude提词指南显示,不同模型需要不同的提词。早期版本的Harness在 Claude Opus 4.6上运行得分59.6%,虽然具有竞争力,但不如Codex,因为我们没有使用与Claude相同的改进循环。许多原则可以推广,如:良好的上下文准备、注重验证,但针对你的任务运行几轮Harness迭代有助于最大化智能体在各项任务中的表现。
很多关于Harness设计的开放研究,如
- 多模型系统(Codex、Gemini、Claude);
- 持续学习的记忆原语,以便智能体能够自主地改进任务;
- 衡量不同模型间的Harness的变化。
欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐
 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)