DeepSeek 一次开源三个仓库:模型厂开始把“部署栈“也开源了
DeepSeek 一次开源三个仓库:模型厂开始把"部署栈"也开源了
TL;DR 速览
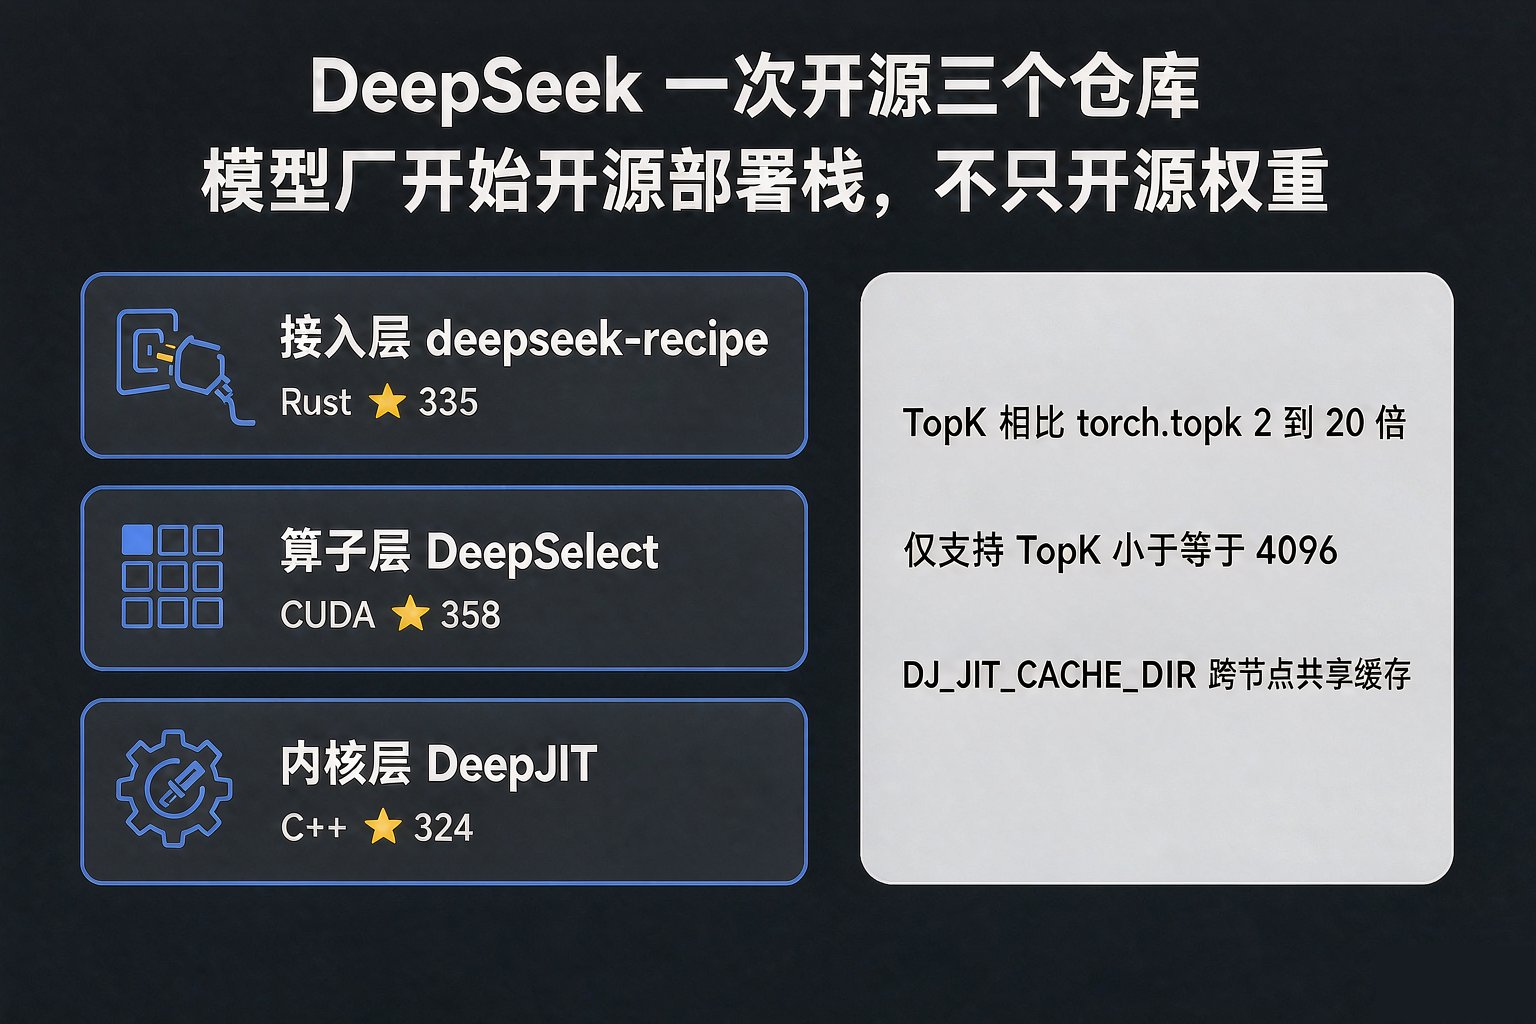
- 事实:DeepSeek 公开三个仓库——deepseek-recipe(协议适配,★335、Rust、MIT)、DeepSelect(TopK 算子,★358、CUDA、MIT)、DeepJIT(内核 JIT,★324、C++),分别对应接入层 / 算子层 / 内核层
- 一个常见误读要纠正:TopK kernel 在 DeepSelect 里,不在 recipe 里——recipe 做的是协议与编码转换
- DeepSelect 的算法:分块扫描 + 阈值筛选 + 候选缓冲精简到 K + 用最小值更新阈值,相比
torch.topk2~20 倍加速;但只支持小 TopK(≤4096),不是通用替代- DeepJIT 最实用的一点:编译产物支持跨进程、跨节点的共享缓存,多机部署不用每台重编
- 要提醒的:DeepJIT 仓库目前没有挂许可证文件,商用前需自行确认
9 月 10 日,DeepSeek 公开了三个新仓库。DeepSeek Harness 团队负责人 Tianyi Cui 在 X 上公布这件事时,措辞很克制——“方便更容易地部署 V4.1 Flash 以及后续的开源模型”。
这三个仓库(deepseek-recipe、DeepSelect、DeepJIT)看起来是三个互不相关的效率工具。放在一起看才发现,它们各自补的是一道落地时一定会撞上的墙。
一、先把一个流传很广的误读纠正掉
网上有些解读把"TopK 算子"算到了 deepseek-recipe 头上。不对。三个仓库的分工是完全分开的:
| 仓库 | 语言 / 星标 | 解决的墙 |
|---|---|---|
| deepseek-recipe | Rust + Python 绑定,★335 | 接入层:协议、对话模板、多模态、工具调用、思考内容的格式转换 |
| DeepSelect | CUDA,★358 | 算子层:DSA 稀疏注意力与采样用的高性能 TopK |
| DeepJIT | C++,★324 | 内核层:跨硬件的 kernel 编译、缓存与加载 |
recipe 里没有任何 TopK kernel——它做的是请求进来、响应出去的格式适配。这个区分很重要,因为它决定了你去哪个仓库找什么。
二、接入层:recipe 把"迁移成本的大头"标准化了
recipe 的定位是一句话能说清的:把不同格式的 API 请求统一转换成 Conversation 格式,编码成 DeepSeek V4 / V4.1 需要的 prompt 或 token IDs,模型生成之后再转换回对应协议的完整或流式响应。
支持范围包括:Messages、Chat Completions、Responses 等格式;流式响应;文本、图片、thinking blocks、工具调用;temperature、top_p 等生成参数;图片还支持 OpenCV 预处理。
# 官方示例:把 Chat Completions 请求转成 DeepSeek V4.1 的 prompt
from deepseek_recipe import ChatCompletionRequest, ConversionOptions, DeepseekV41Encoding

request = ChatCompletionRequest({
    "model": "deepseek-flash",
    "messages": [{"role": "user", "content": "Hello"}],
})
converted = request.convert(ConversionOptions())
rendered = DeepseekV41Encoding().render_conversation(converted.conversation)
print(rendered.prompt)
Rust 侧也有对应的 crate。有 Python 3.10+ 和 Rust 环境的话,pip install deepseek-recipe 或 cargo add deepseek-recipe@0.1 就能起步。
为什么这一层单独开源价值大? 因为迁移成本的大头从来不是 model= 后面那个名字。你原来跑在闭源 API 上的业务,请求体结构、工具调用约定、思考链字段、图片传法,全是各家私有的约定。要迁到 V4.1,这些得逐个对齐——改一行模型名跑通只是开始,跑通之后才是逐个字段对齐的过程。
recipe 把这套对齐标准化了。对做推理服务的团队,这意味着协议适配从"每家自己攒"变成"用官方实现"。 这是实打实的工期节省。
边界也说清楚:目前不支持 logprobs、单次多候选(n>1)、JSON Schema 约束。另外官方给的 Python 服务示例默认返回的是 mock 的 “Hello world!”,不需要模型权重——要拿到真实模型输出,仍然得接自己的推理后端。模型推理、工具执行、HTTP 传输这三件事,recipe 都不管。
三、算子层:TopK 为什么是稀疏注意力的命门
DeepSelect 是这三个仓库里技术含量最高的一个。
它实现的是 DSA(DeepSeek Sparse Attention,稀疏注意力) 里的 TopK kernel,以及采样时用到的 TopK——DSA 从 V3.2 一路用到 V4、V4.1。相比原生 torch.topk,官方给出的加速比是 2~20 倍。
为什么 TopK 在这里是命门?
稀疏注意力的思路是不对全部 KV 做注意力,而是先给候选块打分、再用 TopK 挑出最相关的那一小部分来计算。关键在于这一步发生的频率:它是逐块、每一步解码都要重算的操作。也就是说 TopK 不是偶发调用,而是 decode 阶段的高频热点。
这个位置很要命:如果选择这一步本身就慢,稀疏注意力省下来的算力会被原样还回去。 架构上省掉的计算和算子上多花的时间会互相抵消——上层设计再漂亮,底下的算子慢了也补不回来。
它的算法可以压成三个动作:
- 分块扫描:按随机顺序扫描输入,只有高于当前阈值的元素才进候选缓冲区;
- 动态收紧阈值:缓冲区变大或扫描结束时,在共享内存里把候选精简到 K 个,再用其中的最小值更新阈值;
- 阈值生效:阈值提高之后,后续的更多元素可以直接被过滤掉。
换句话说,它把"先全部算出来再排序取前 K"改成了"边走边筛、阈值越走越严"。扫描顺序随机化是为了让阈值尽快接近真实分位数——先撞到几个大值,后面的过滤就能更彻底。
import torch, deep_select
batch_size, vocab_size, topk = 4, 204800, 1024
x = torch.randn(batch_size, vocab_size, dtype=torch.bfloat16, device="cuda")
values, indices = deep_select.topk(x, topk, sorted_index=True, indices_type=torch.int32)
必须说明它的适用边界,否则容易用错:
- 只支持小 TopK(≤4096);
- 对输入 dtype 和 tensor shape 有约束;
- 它不是通用
torch.topk的替代品——它是针对这一类特定负载优化过的实现。
官方的性能对照分两组:bf16 输入、topk=512 的场景,以及 fp32 采样场景(vocab_size 129280、topk=512,也就是从词表里选候选 token)。这两组对应的是两个真实负载,而不是"什么情况都快 20 倍"。
顺带说一个背景数字:V4.1 Flash 的技术报告里,CSA2 层的 Top-K 设为 512。这个数字解释了 DeepSelect 为什么把优化重点放在小 K 场景——它不是通用算子库,它是把这一条链路的最底下一级抠出来做快了。
四、内核层:DeepJIT 解决"换卡重编"
DeepJIT 是一个 header-only 的 C++20 JIT 运行时,面向 NVIDIA CUDA GPU 与华为昇腾 NPU,提供统一接口做四件事:运行时编译内核源码、缓存编译产物、加载到设备、按后端专有选项启动。
它要解决的是写自定义 kernel 的老问题:换一张卡、换一个输入 shape,往往就得重新编译、重新验证。 而推理服务里请求的 shape 是千变万化的,提前把所有 shape 编译好既不现实也不经济——运行时按 shape 编译并缓存,才是贴合真实流量分布的做法。
最实用的一点是缓存设计:它支持本地与分布式文件系统上的共享缓存。 也就是说编译产物可以在多个进程、多个节点之间复用——通过环境变量指定缓存目录即可:
export DJ_JIT_CACHE_DIR=/shared/deep_jit
对多机部署来说,这一条的价值最直接: 一个集群几十个节点,如果每个节点首次收到新 shape 都要自己编一遍,那"冷启动"的代价会随节点数放大。共享缓存把这个代价从"每个节点一次"变成"整个集群一次"。
另外它对国产算力的意义值得单独说:同一份计算在 CUDA 和昇腾上是两套 kernel,靠人工逐个适配根本跟不上迭代节奏。统一运行时接口 + 按后端提供实现,是把适配工作从"每次重做"变成"一次配置"的前提。
但这里必须提醒一处:DeepJIT 仓库目前没有挂许可证文件。 三个仓库里 recipe 和 DeepSelect 都是 MIT,DeepJIT 的 LICENSE 是缺的。在做技术选型时这不影响评估,但进入商用前需要自行确认授权条款——这类细节很容易被"官方开源"四个字盖过去。
五、放到一起看,释放的信号比工具本身重要
把三个仓库对应起来,图景很清楚:
| 层 | 工具 | 卡点 |
|---|---|---|
| 接入层 | recipe | 从闭源 API 迁出的协议摩擦 |
| 算子层 | DeepSelect | 稀疏注意力与采样的单步效率 |
| 内核层 | DeepJIT | 换卡重编、异构硬件适配 |
再加上你已经在用的推理引擎(vLLM、SGLang 之类管运行时调度),这就是一条把 V4.1 Flash 跑进生产的官方最小路径。
但真正的信号在工具之外:模型厂开始开源"部署栈",而不是只开源权重。
过去几年"开源模型"的实际含义往往就是 HuggingFace 上的一组权重文件——能不能低成本、高吞吐、跨硬件地跑起来,全看各家用工自己攒。这部分工程能力不做宣传、不进论文,但它实实在在决定了采用率。
把部署栈一起开源,等于把"采用这个模型的工程成本"一次性压下来。 对做推理部署的团队,这比多一个权重文件有用得多;对模型厂自己,这是在把生态往自己这边绑——权重负责让人来,部署栈负责让人留下。
我的判断
三个仓库里,短期最有用的是 recipe,长期影响最大的是 DeepSelect。
recipe 的价值立刻兑现:任何要把业务从闭源 API 迁过来的人,都能省掉协议适配的工期。而 DeepSelect 的意义更微妙——它把 DSA 里最影响实际吞吐的那一级单独抠出来优化,这等于告诉你:稀疏注意力的收益能不能落地,取决于选择算子做得多快。
这件事对做推理优化的团队是一个提醒:别只盯着模型架构和显存占用,算子级的热点往往才是吞吐的真正瓶颈。 一个在 decode 阶段每步都调用的 TopK,慢一点就会被放大到整个服务上。
至于 DeepJIT,我的判断是要看它的生态跟不跟。JIT 运行时这类东西的价值完全取决于有多少 kernel 愿意基于它写——单个团队自己接,收益是"少编几次";如果形成公共缓存与共享实现,收益才变成"整个生态少编很多次"。
最后一句给正在做迁移的同行:这三个仓库让"把 DeepSeek 跑进生产"的路径清楚了,但路径清楚不等于问题解决。 你的真实瓶颈可能在别处——上下文长度带来的显存压力、并发下的调度策略、或者业务本身的数据链路。先把自己的瓶颈找出来,再决定这三个仓库里哪个对你真正有用。 全都接一遍,多半是浪费工期。
这类"一次开三个仓库"的发布,我会先把各自的分工列成表再写——这份对照表连同选题一起存在 墨衍 里,下次同类发布可以直接接着比。

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)