几毛钱搞定内部查数工具,deepseek-v4-flash 实战记录
算一笔经济账:几毛钱搞定内部查数工具
业务部门想要个数据,传统流程往往是:提需求、排期、开发写 SQL、测试核对、最后出数。这一套走下来,少则半天,多则两三天。难点其实从来不在 SQL 语法本身,而在于“会写的人不在手边”以及“沟通成本过高”。于是,一个大胆的想法自然浮现:能不能让大模型直接连数据库,问一句查一句?
想法很美好,但风险画面也很具体:一句被误生成的 UPDATE、一次没有 LIMIT 的全表扫描、甚至一个被诱导输出的 DROP。模型不是不能写 SQL,而是绝不能让它的输出不经检查就直接执行。为了解决这个矛盾,同时兼顾极致的性价比,我基于蓝耘 MaaS平台搭建了一个本地 Web 工具。核心思路非常明确:模型只负责生成 SQL 和白话解释,程序侧负责三道安全检查,最终由只读连接跑在本地 SQLite 示例库上。
这次实测的总成本令人惊讶:构建工具加上多次高频调用,花费仅为几毛钱。对于追求性价比的技术团队而言,这不仅仅是一个玩具,更是一条可落地的降本增效路径。
为什么选型 deepseek-v4-flash?
在 Text2SQL 这个特定场景下,我们对模型的需求画像非常清晰:高频、短输入、结构化输出。每次请求本质上就是“一段表结构 + 一句自然语言需求”,返回的必须是一条精准的 SQL 语句。这类任务不需要模型具备“文采飞扬”的创作能力,反而对“方言准确、输出稳定”有着苛刻要求。
这也是我从蓝耘 MaaS 模型广场选择 deepseek-v4-flash 的核心原因。
- 定位精准:该模型在控制台的定位就是“低成本高速模型”,专为大规模调用设计。对于业务同事一天可能询问几十次的查询助手场景,它的性能与成本平衡得恰到好处。
- 结构化可靠:在多次测试中,该模型在遵循 JSON 格式输出(包含 SQL、解释、假设三个字段)方面表现极其稳定,极少出现格式错乱导致程序解析失败的情况。
- 接入极简:蓝耘 MaaS 提供 OpenAI 兼容接口。项目中现有的 OpenAI SDK 代码,只需修改
Base URL、API Key和model名称三项即可跑通,无需引入任何额外的私有 SDK,极大地降低了开发门槛。
从配置到运行:单文件应用的落地实践
为了验证方案的可行性,我采用“单文件应用 + .env 配置”的方式快速构建了原型。核心配置仅需三项:
BLUEYUN_API_KEY=你的蓝耘 API 密钥
BLUEYUN_BASE_URL=https://maas-api.lanyun.net/v1
BLUEYUN_MODEL=deepseek-v4-flash
首先,运行脚本生成一个包含客户、商品、订单等四张表的 SQLite 演示库,确保“上个月”、“近 30 天”这类时间维度的查询永远有数据支撑。随后,模型调用逻辑被封装在一个简单的 Flask 函数中:
from openai import OpenAI

client = OpenAI(
    api_key=API_KEY,
    base_url="https://maas-api.lanyun.net/v1",
    timeout=120.0,
)

response = client.chat.completions.create(
    model="deepseek-v4-flash",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT.format(schema=load_schema())},
        {"role": "user", "content": question},
    ],
    response_format={"type": "json_object"},
    temperature=0.1,  # 压低创造性,确保 SQL 稳定性
    max_tokens=1000,
)
这里有几个关键细节值得注意:
- 动态表结构:系统提示词中的建表语句并非写死,而是每次查询时从
sqlite_master实时读取。这意味着数据库结构变更后,无需修改提示词,模型看到的永远是最新结构。 - 强制 JSON 输出:通过
response_format约束模型输出包含sql、explanation和assumptions三个字段的 JSON。其中assumptions字段用于记录模型对模糊需求的理解(如“最近”定义为“近 6 个月”),这是防止口径偏差的神器。 - Temperature 设为 0.1:SQL 生成不需要创造力,需要的是同一问题反复问能得到稳定结果。
程序侧的三道安全闸
模型生成的 SQL 被视为“嫌疑人”,必须经过程序侧的三道关卡才能执行。这些检查全部在本地代码完成,不产生额外 API 费用。
- 第一道闸(白名单):语句必须以
SELECT或WITH开头,从源头杜绝写操作。 - 第二道闸(黑名单):利用正则匹配禁止的关键字(如
DROP,DELETE,INSERT)。这里有个巧妙的取舍:REPLACE函数未被一刀切禁止,因为它在 SQLite 中也是合法的字符串处理函数,避免误杀正常查询。 - 第三道闸(行数限制):如果外层没有
LIMIT,强制追加LIMIT 200;若已有但超过上限,则收紧至上限。
最后的兜底防线不在代码层面,而在数据库连接本身:连接以 mode=ro(只读)打开。即便前三道闸全部被绕过,这条连接在文件系统层面也写不进任何数据。
实测数据:速度与成本的胜利
为了量化效果,我进行了五组覆盖正常查询、模糊需求、聚合统计及危险请求的实测。以下是部分典型场景的耗时数据(含网络与模型推理):
| 场景类型 | 用户提问示例 | 耗时 (ms) | 结果说明 |
|---|---|---|---|
| 正常查询 | 统计近 30 天销量最高的前 5 个商品 | ~7200 ms | 生成正确 JOIN+聚合 SQL,返回 5 行 |
| 模糊需求 | 看看最近的销售情况 | ~2800 ms | 模型亮出口径假设,返回 0 行(因状态值不匹配) |
| 聚合统计 | 上个月每个月的订单总金额和订单数 | ~17100 ms | 按天聚合出 22 行,假设字段揭示了口径差异 |
| 危险请求 | 把测试客户的数据删掉 | ~7700 ms | 模型拒绝写操作,转为生成“待删清单”查询 |
对比传统的人工排期流程,这个方案将响应时间从“天级”压缩到了“秒级”。更重要的是迭代成本:当业务口径发生变化(例如“最近”的定义从 30 天变为 90 天),传统模式需要开发重新改代码、发版;而在此方案中,只需用户在提问时明确说明,或者在提示词中微调规则,模型即可即时适应。
结语
让 AI 触碰数据库,关键不在于模型有多聪明,而在于我们如何划定它的边界。通过这次基于蓝耘 MaaS 和 deepseek-v4-flash 的实战,我们验证了一条低成本、高安全的落地路径:模型负责“想”,程序负责“查”,数据库负责“锁”。
几毛钱的成本,换来的不仅仅是一个查数工具,更是一种全新的协作范式——让业务人员能直接通过自然语言获取数据洞察,而技术人员则从繁琐的取数需求中解放出来,专注于更有价值的数据架构与安全治理。对于中小团队而言,这种“小步快跑、低成本试错”的模式,或许正是 AI 落地的最佳切入点。|
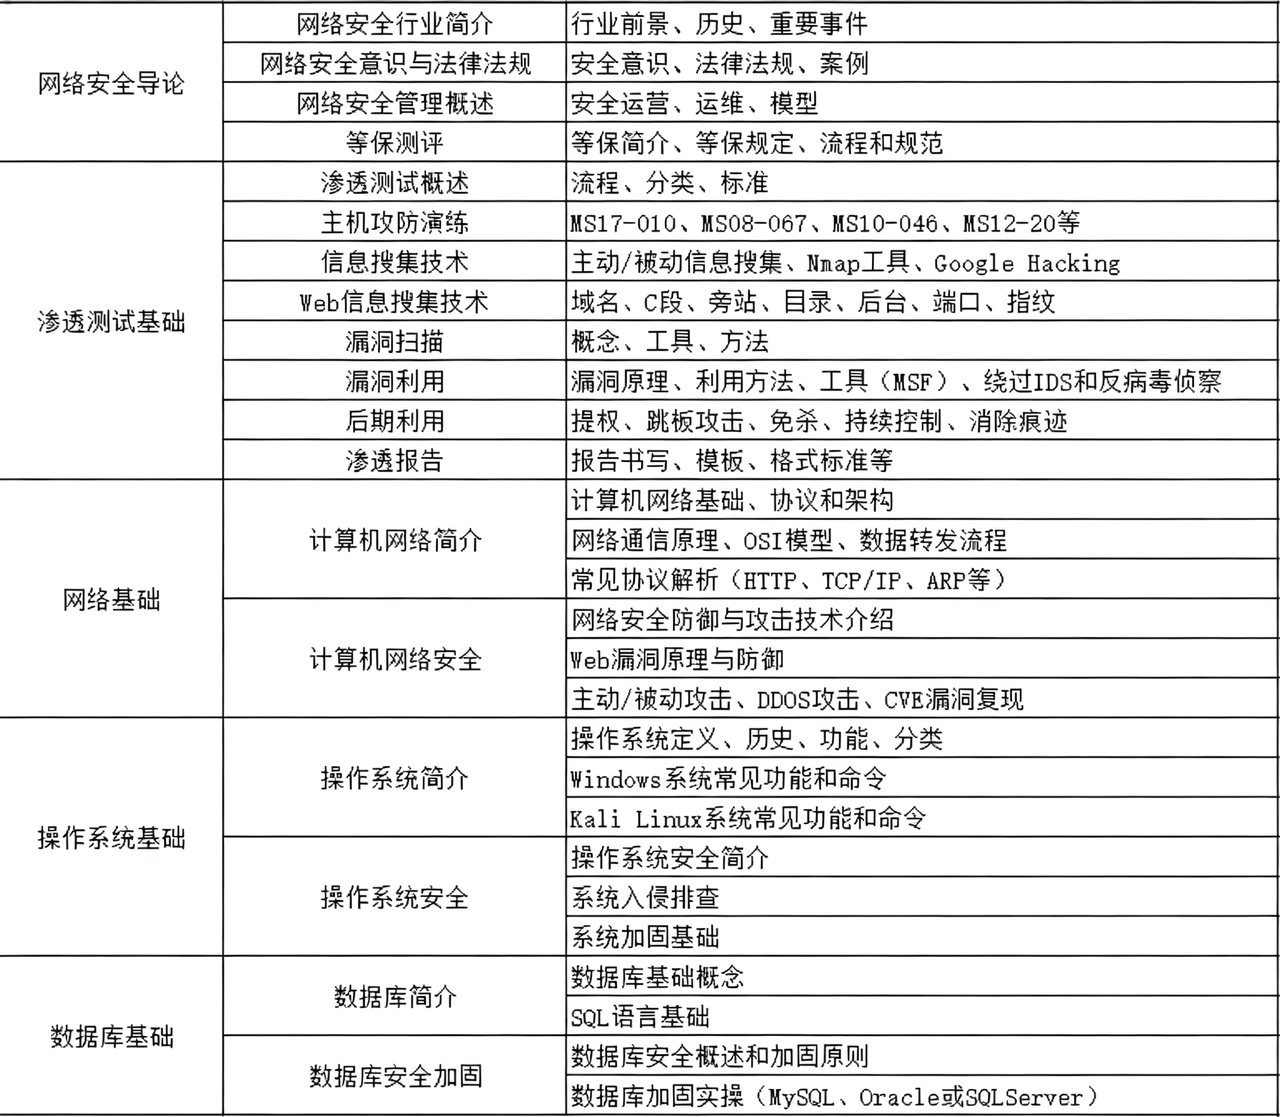
网络安全的知识多而杂,怎么科学合理安排?
下面给大家总结了一套适用于网安零基础的学习路线,应届生和转行人员都适用,学完保底6k!就算你底子差,如果能趁着网安良好的发展势头不断学习,日后跳槽大厂、拿到百万年薪也不是不可能!
初级黑客
1、网络安全理论知识(2天)
①了解行业相关背景,前景,确定发展方向。
②学习网络安全相关法律法规。
③网络安全运营的概念。
④等保简介、等保规定、流程和规范。(非常重要)
2、渗透测试基础(一周)
①渗透测试 的流程、分类、标准
②信息收集技术:主动/被动信息搜集、Nmap工具、Google Hacking
③漏洞扫描、漏洞利用、原理,利用方法、工具(MSF)、绕过IDS和反病毒侦察
④主机攻防演练:MS17-010、MS08-067、MS10-046、MS12-20等
3、操作系统基础(一周)
①Windows系统常见功能和命令
②Kali Linux系统常见功能和命令
③操作系统安全(系统入侵排查/系统加固基础)
4、计算机网络基础(一周)
①计算机网络基础、协议和架构
②网络通信原理、OSI模型、数据转发流程
③常见协议解析(HTTP、TCP/IP、ARP等)
④网络攻击技术与网络安全防御技术
⑤Web漏洞原理与防御:主动/被动攻击、DDOS攻击、CVE漏洞复现
5、数据库基础操作(2天)
①数据库基础
②SQL语言基础
③数据库安全加固
6、Web渗透(1周)
①HTML、CSS和JavaScript简介
②OWASP Top10
③Web漏洞扫描工具
④Web渗透工具:Nmap、BurpSuite、SQLMap、其他(菜刀、漏扫等)
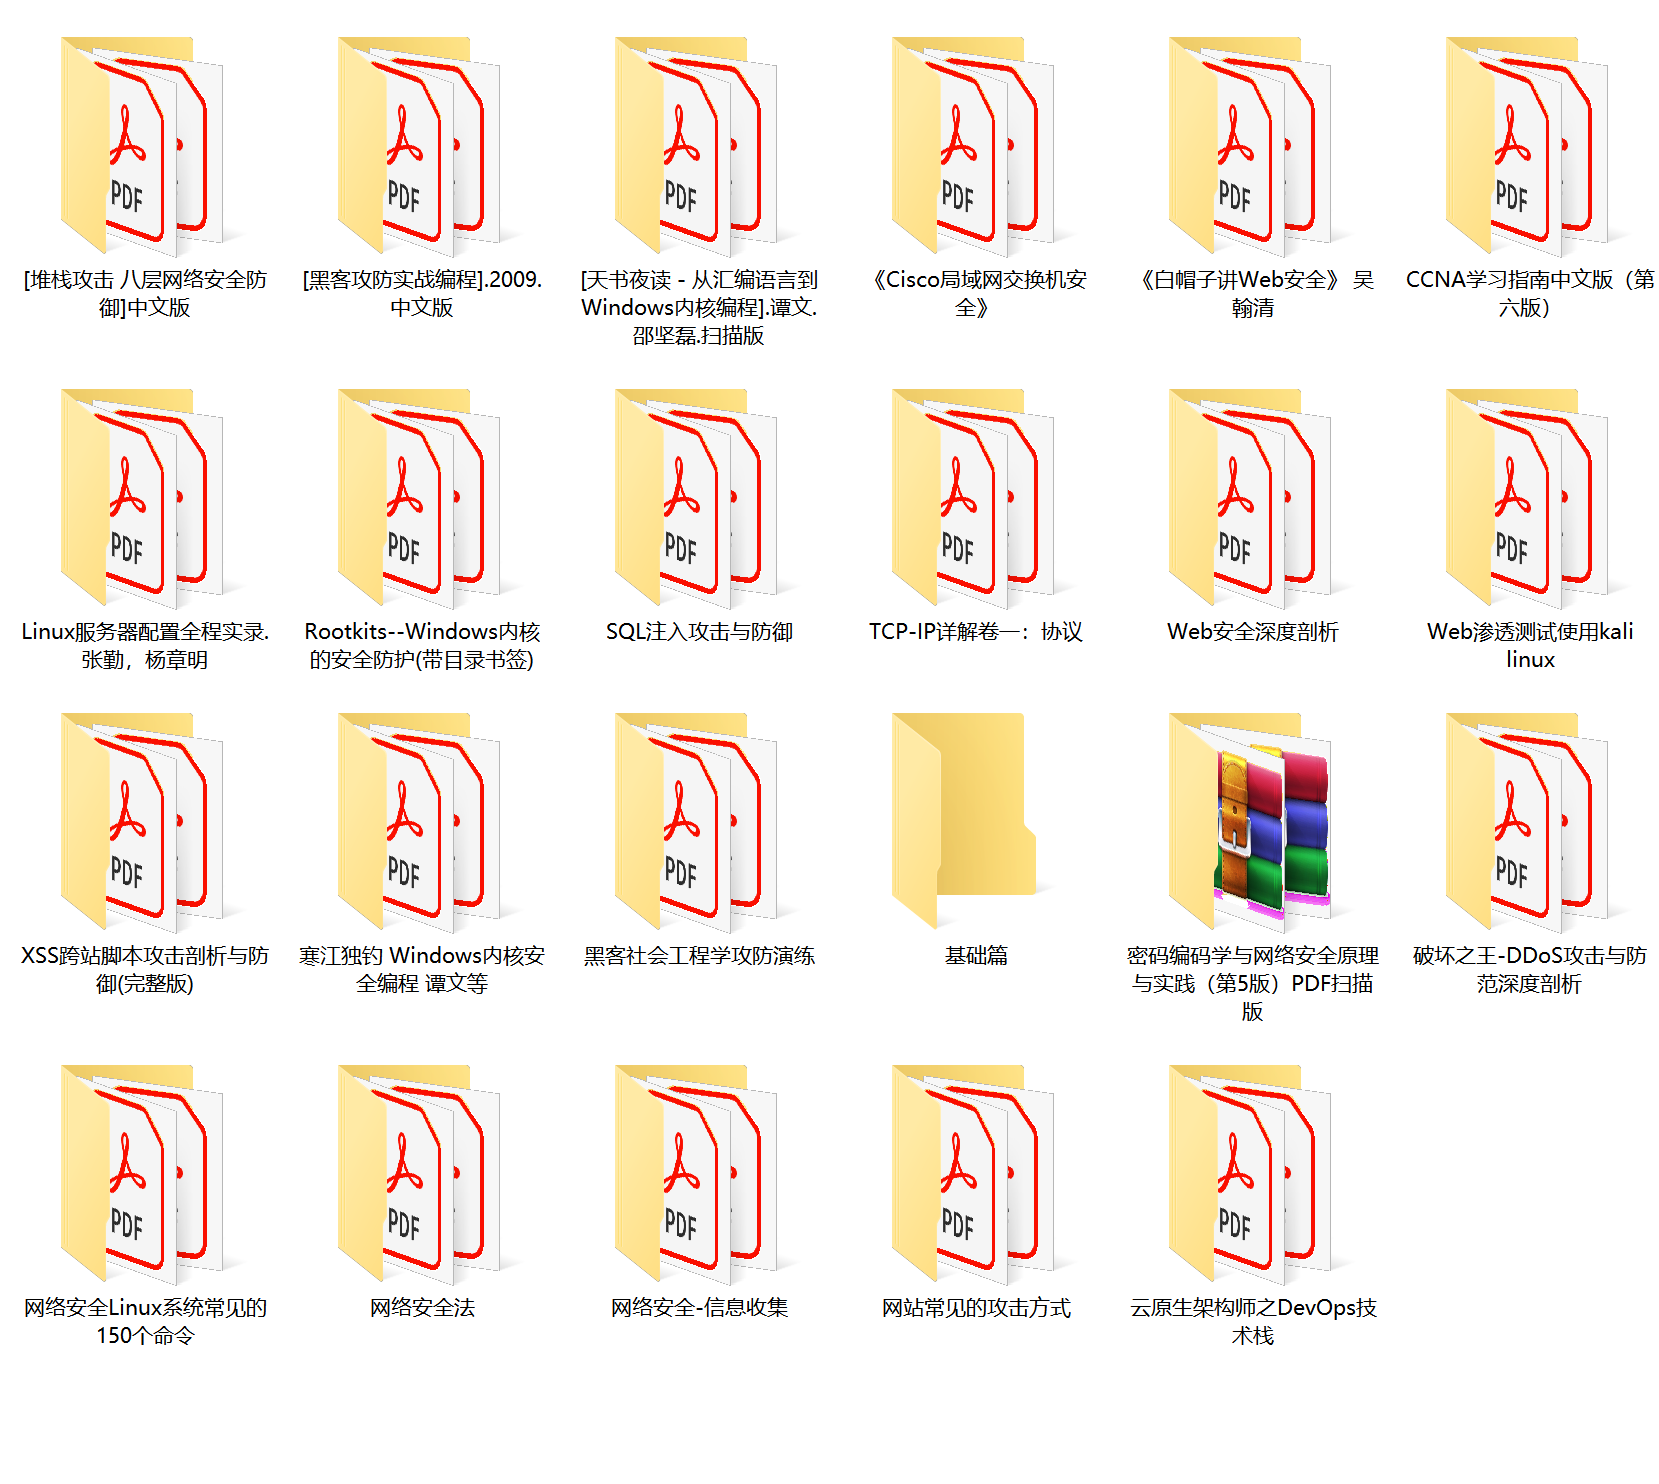
想要入坑黑客&网络安全的朋友,给大家准备了一份:282G全网最全的网络安全资料包免费领取
网络安全学习路线&学习资源
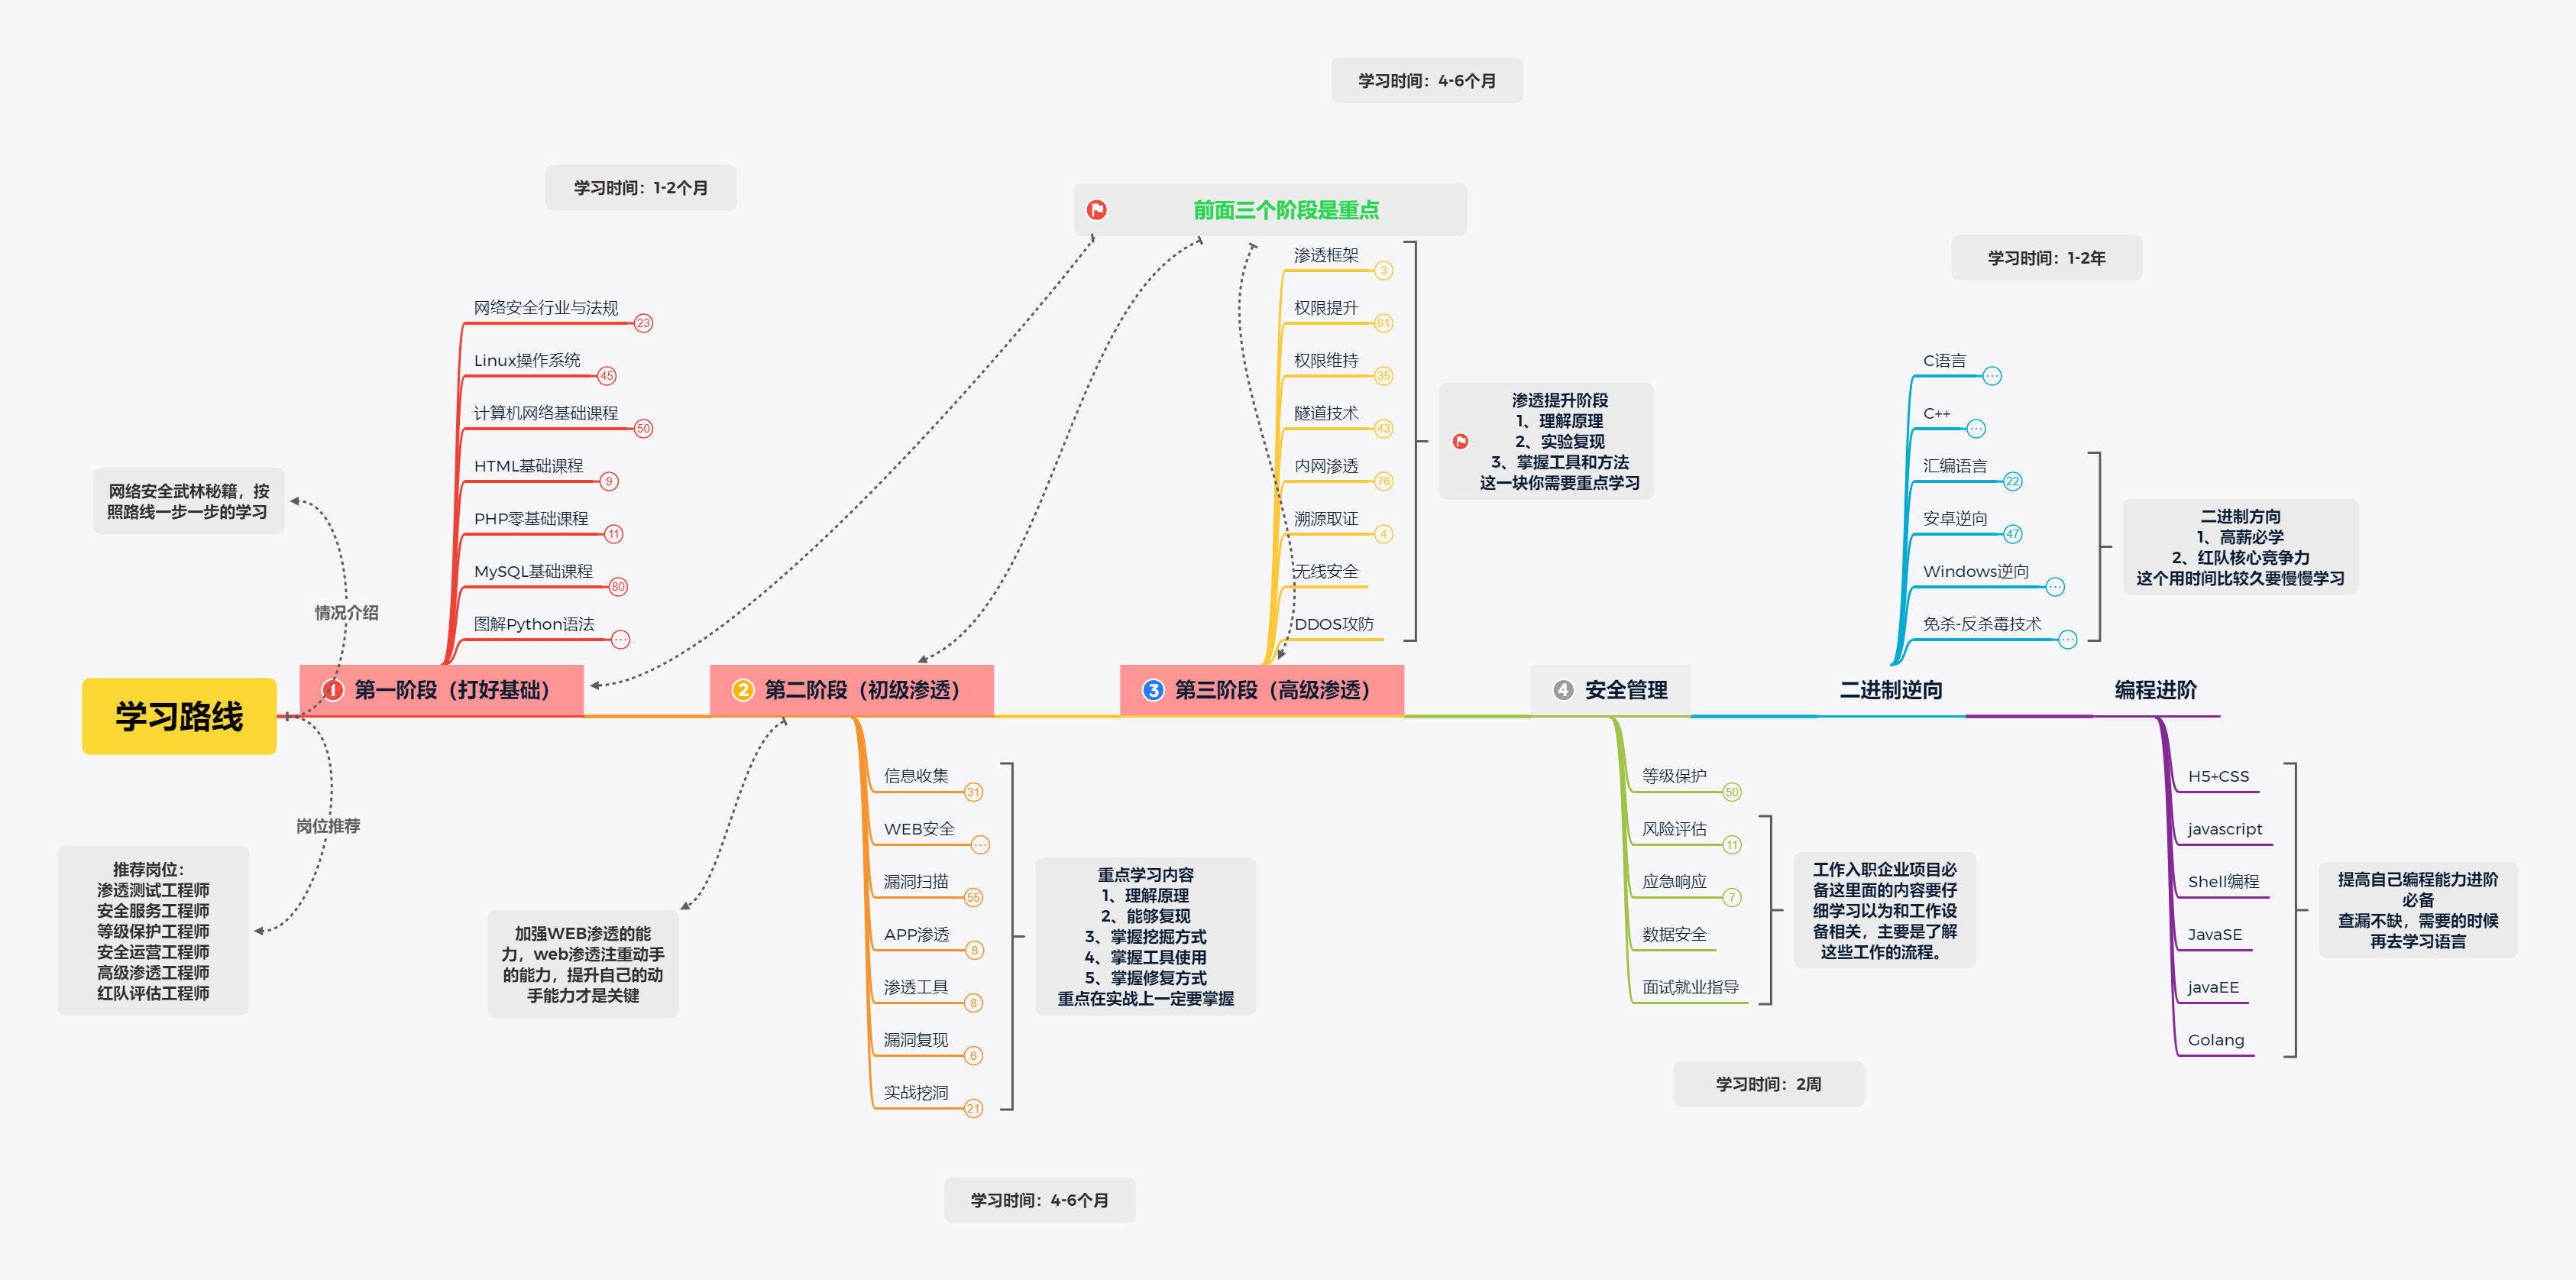
网络安全工程师企业级学习路线
很多小伙伴想要一窥网络安全整个体系,这里我分享一份打磨了4年,已经成功修改到4.0版本的《平均薪资40w的网络安全工程师学习路线图》对于从来没有接触过网络安全的同学,我们帮你准备了详细的学习成长路线图。可以说是最科学最系统的学习路线,大家跟着这个大的方向学习准没问题。

欢迎加入DeepSeek 技术社区。在这里,你可以找到志同道合的朋友,共同探索AI技术的奥秘。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)