登录社区云,与社区用户共同成长
邀请您加入社区
暂无图片
为遵守国家网络实名制规定,未绑定将限制内容发布与互动
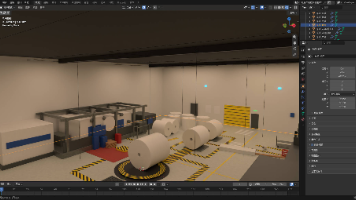
本文介绍一条 "从基于大模型构建3D模型生产到应用发布" 的快速构建链路:上游由大模型驱动 Blender 辅助实时建模,下游把模型变成可拖拽配置的元件,业务人员无需人工3D建模和开发业务代码即可产出浏览器应用。
DeepSeek涨价致月成本翻倍至48000元,缓存命中价最高涨300%。替代模型A、B月成本分别约36000元、30000元。建议个人开发者降本续用,中小团队评估迁移或混合方案,大型企业分步迁移并保留回滚预案。通过缓存复用、请求合并与模型分层调用,可降低40%成本。综合成本、能力与迁移难度,使用五维评分表决策更科学。
用DeepSeek辅助孩子学编程——3个能立刻用起来的提示词模板
QQ 机器人接大模型,真正容易出问题的不是调用一次 Chat API,而是消息从 QQ 客户端到模型再回到 QQ 的每一段是否可观测。2026-09-14 发布的 CSDN 社区教程《QQ 机器人怎么接上 AI?用 AstrBot + NapCat 搭一套可扩展的 DeepSeek 助手》给出了一条可复现路径。需要先说明:它不是 AstrBot、NapCat 或 DeepSeek 的官方公告,而是
如何让“蓝色大肥鱼”帮你免费干活?国际版 WorkBuddy 的 DeepSeek V4.1 Flash 虽然限免真香,但一换账号历史会话、MCP 工具和长期记忆全被清空。借助开源工具 WorkBuddy Tools,一键打包带走全部工作上下文与配置,让多账号高配模型轮流给你当免费打工人!
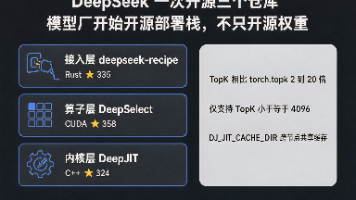
DeepSelect 是这三个仓库里技术含量最高的一个。它实现的是DSA(DeepSeek Sparse Attention,稀疏注意力)里的 TopK kernel,以及采样时用到的 TopK——DSA 从 V3.2 一路用到 V4、V4.1。相比原生torch.topk,官方给出的加速比是2~20 倍。为什么 TopK 在这里是命门?稀疏注意力的思路是不对全部 KV 做注意力,而是先给候选块打
更合理的比较维度是:是否允许自定义模型提供方,密钥是否可安全管理,错误信息是否可读,日志是否可导出,是否支持代理,是否能锁定模型版本,是否支持本地部署端点,是否便于替换生成模型。其他摘要集中在 DeepSeek 概述、架构、本地部署和模型系列,提到 DeepSeek-V2、V3、R1、R1 Zero、混合专家架构、多头潜在注意力、强化学习、蒸馏小模型、本地部署、微调等。第一层是接入形态:应用程序、
回答"支持DeepSeek吗":在619个模型列表里,DeepSeek的多个版本都在。接水管(模型列表里有)、测水压(链路监控定期测)、装水表(消费日志记每笔调用)、装过滤器(脱敏+输入防护+输出过滤+访问控制),四步走完。支持私有化部署,所有请求储存在本地,数据不出企业。有三个软件版本和两个一体机系列。魔芋AI大模型网关I全球大模型一站式调用及服务平台魔芋AI大模型聚合平台(大模型网关平台)专注
同样的话,如果出自自媒体,是焦虑营销;出自 Anthropic / OpenAI 研究员,像胜利者劝退;出自刘胜与,分量在于:他刚交付完最前沿模型的底层组件,转头说“我这活儿快没我了”。AI 不该被少数人锁起来。他不信任最强智能集中在个别闭源巨头手里,怕世界滑向“2077”——少数公司握 AGI,普通人用玩具模型。我可以被 AI 替代,但我不想让 AI 变成新的神权。所以这篇文章的底层情绪不是丧,
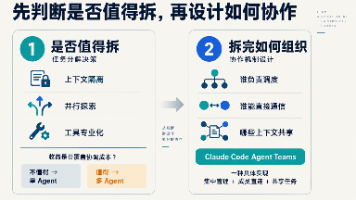
Multi-agent 描述多个 Agent 参与的系统,Team 的含义取决于具体实现。本文从 Claude Code 的 Subagent 与 Agent Teams 出发,结合 Codex、OpenCode、pi 和 DeepSeek Harness,比较任务分解、通信与运行时机制,并引入 2026 年的工程实验及 9 月的研究,说明何时值得拆分、如何验证收益,以及哪些历史数据不能直接外推。